Data Science
Generative AI Và Data Science: Cách Data Scientist Dùng AI Tạo Sinh Để Làm Nhanh Hơn
Generative AI giúp data scientist làm nhanh hơn ở 4 bước: bổ sung dữ liệu, viết code, sinh báo cáo và đề xuất giả thuyết. Bài giải thích GAN, VAE, LLM và synthetic data bằng ví dụ đời thường, kèm cảnh báo hallucination và bias.
 Phong Nguyen
PNTECH Writer · 23/09/2026
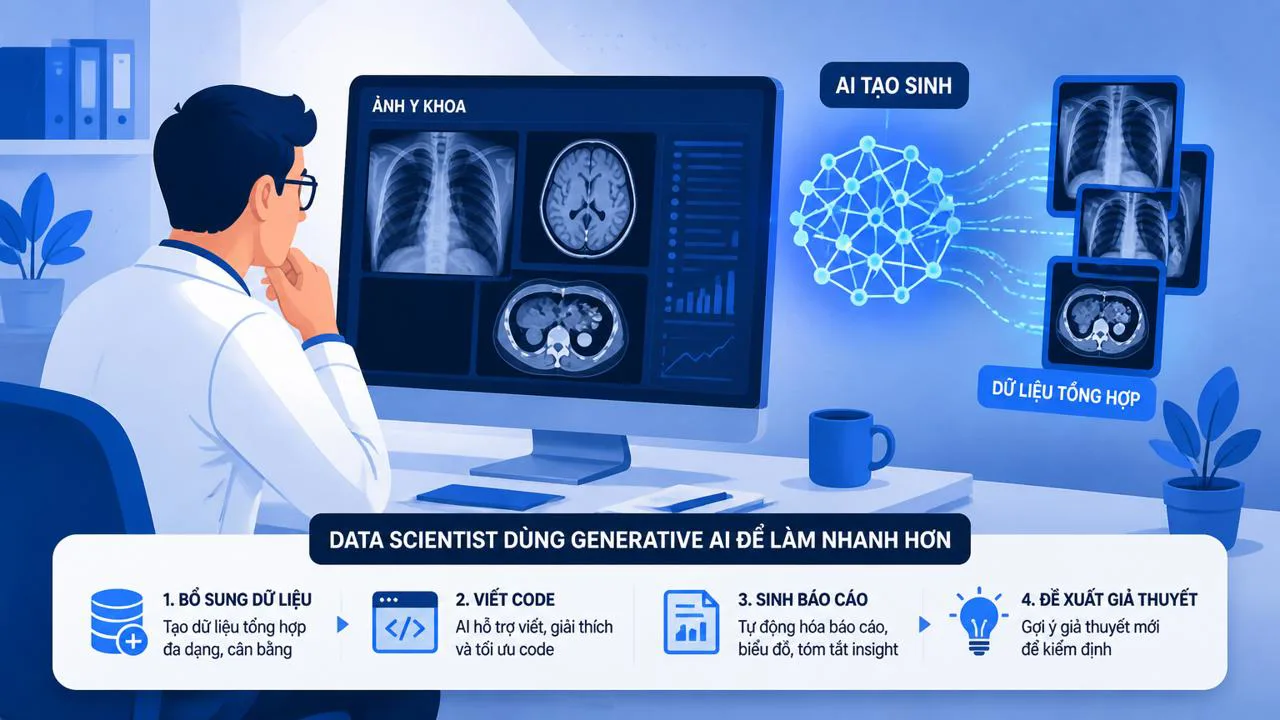
Có một bệnh viện lớn chỉ có trong tay 200 ca bệnh nhân thật về một loại ung thư hiếm — quá ít để huấn luyện một mô hình chẩn đoán từ ảnh y khoa. Họ cần khoảng 5.000 mẫu. Giải pháp không đến từ bệnh nhân mới, mà đến từ một nhóm kỹ sư dùng generative AI (AI tạo sinh) để tạo ra ảnh giả có cùng "phổ" đặc điểm với ảnh thật. Nhờ vậy, mô hình được huấn luyện mà không vi phạm quyền riêng tư của người bệnh. Đây chỉ là một trong rất nhiều việc data scientist có thể làm nhanh hơn khi biết cách tận dụng AI tạo sinh đúng chỗ.
Bài viết này giải thích generative AI là gì, nó khác gì so với AI truyền thống, và một người mới làm dữ liệu có thể ứng dụng nó ở bước nào trong quy trình data science. Bạn không cần biết trước về deep learning — mọi thuật ngữ sẽ được mở ra bằng ví dụ đời thường trước khi đi vào phần kỹ thuật.
Generative AI là gì và khác gì AI truyền thống
AI truyền thống — hay còn gọi là AI phân tích (analytical AI) — giống một giám khảo giỏi: đọc dữ liệu rồi đưa ra phán đoán. Nó nhận email rồi quyết định thư rác hay không, nhận ảnh chụp X-quang rồi phân loại u lành hay u ác, nhận lịch sử giao dịch rồi dự báo doanh thu tháng tới. Đầu vào là dữ liệu có sẵn, đầu ra là một con số hoặc một nhãn.
Generative AI (AI tạo sinh) thì khác — nó giống một học sinh tài năng đã đọc hàng vạn tác phẩm, rồi tự viết ra một tác phẩm mới theo phong cách đã học. Đầu vào vẫn là dữ liệu, nhưng đầu ra là thứ chưa từng tồn tại: một đoạn văn, một bức ảnh, một đoạn nhạc, một hàm code, hay một bảng dữ liệu hoàn toàn mới.
Cả hai đều nằm trong nhánh rộng hơn là deep learning — tức mạng nơ-ron nhiều lớp (giống chuỗi bộ lọc xếp chồng: mỗi lớp nhặt một đặc điểm, lớp sau nhặt đặc điểm phức tạp hơn từ những gì lớp trước tìm được). Để hiểu rõ hơn mạng nơ-ron là gì và hoạt động ra sao, bạn có thể đọc thêm Deep Learning cơ bản: neural network là gì. Còn để nắm bức tranh tổng thể về data science trước khi đi vào AI tạo sinh, hãy xem lại Data Science là gì và quy trình chuẩn. Trong bài AI và Data Science: phân biệt và mối liên hệ, mối quan hệ giữa hai lĩnh vực này cũng đã được mở ra ở mức tổng quan.
Các mô hình nền tảng: GAN, VAE và LLM
Để tạo ra thứ mới, generative AI dùng vài kiểu mô hình nền tảng. Bạn không cần nhớ công thức toán — chỉ cần hiểu ý tưởng bằng ví dụ quen thuộc.
GAN (Generative Adversarial Network — Mạng đối kháng tạo sinh) gồm hai mạng đấu nhau. Một mạng đóng vai "nghệ nhân làm tiền giả", cứ thử vẽ ra tờ tiền giống thật. Mạng còn lại đóng vai "cảnh sát kiểm tra tiền", nhìn tờ tiền rồi phán đó là thật hay giả. Mỗi lần cảnh sát bắt trúng, nghệ nhân phải vẽ tinh vi hơn. Sau hàng vạn vòng đấu, sản phẩm của nghệ nhân tinh vi đến mức cảnh sát khó phân biệt — đó chính là lúc ảnh giả trở nên rất giống ảnh thật. GAN thường được dùng để tạo ảnh, ví dụ ảnh khuôn mặt người không có thật.
VAE (Variational Autoencoder — Bộ tự mã hóa biến phân) có cơ chế khác: nó nén dữ liệu thành một dạng rút gọn gọi là "không gian ẩn" (giống khi bạn tóm tắt quyển sách dày 300 trang còn 3 dòng), rồi từ bản tóm tắt đó, nó phục hồi thành mẫu mới có cùng phong cách. Hình dung như bạn giữ lại "linh hồn" của ảnh chân dung — nét mặt, ánh sáng, góc chụp — rồi từ đó vẽ ra những gương mặt mới mà vẫn mang phong cách ấy.
LLM (Large Language Model — Mô hình ngôn ngữ lớn) là generative AI chuyên về chữ. Các tên quen thuộc như GPT, Claude hay Gemini đều thuộc nhóm này. Bạn gửi câu hỏi hoặc yêu cầu, nó sinh ra đoạn văn, đoạn code, hoặc bản tóm tắt. Với data scientist, LLM là công cụ gần gũi nhất vì nó đọc–viết được tiếng Việt và tiếng Anh.
Ngoài ba nhóm trên, còn có diffusion model (mô hình khuếch tán) — nền tảng của các công cụ tạo ảnh nổi tiếng như Stable Diffusion và Midjourney. Ý tưởng của nó là bắt đầu từ một màn hình nhiễu trắng, rồi từng bước "gỡ nhiễu" để lộ ra bức ảnh có nội dung. Bạn sẽ thấy mô hình này xuất hiện nhiều trong các công cụ thiết kế và tạo hình ảnh từ 2025 trở đi.
GAN giống cuộc đấu giữa người làm tiền giả và cảnh sát; VAE giống việc giữ "linh hồn" bức ảnh rồi vẽ lại; LLM là generative AI chuyên đọc và viết chữ.
Synthetic data — dữ liệu giả, khi nào cần và giới hạn
Synthetic data là dữ liệu do máy tạo ra, có cùng "phổ" (distribution — tức cách các giá trị phân bổ trong tập dữ liệu) với dữ liệu thật nhưng không phải dữ liệu thật. Nói cách khác, mắt thường và thậm chí nhiều mô hình khó phân biệt, nhưng không có cá nhân nào bị lộ thông tin.
Ba tình huống mà synthetic data đặc biệt hữu ích:
- Dữ liệu hiếm: bệnh hiếm gặp, gian lận thẻ tín dụng hiếm xảy ra, lỗi thiết bị công nghiệp hiếm khi xuất hiện. Mô hình cần nhiều mẫu để học, mà thực tế không đủ.
- Dữ liệu riêng tư: hồ sơ bệnh nhân, thông tin tài chính, dữ liệu nhân viên. Không thể chia sẻ trực tiếp để huấn luyện hoặc nghiên cứu.
- Dữ liệu mất cân bằng: có 100.000 giao dịch bình thường nhưng chỉ 50 giao dịch gian lận. Mô hình sẽ thiên về lớp đa số, bỏ sót lớp thiểu số — synthetic data giúp "bù" cho phía thiểu số.
Quay lại ví dụ bệnh viện ở đầu bài: từ 200 ca thật, nhóm kỹ sư dùng generative AI sinh thêm hàng nghìn mẫu ảnh giả có cùng đặc điểm (kích thước khối u, mức cản quang, vị trí tổn thương). Mô hình học trên tập ảnh lớn hơn mà không chạm vào thông tin bệnh nhân thật.
Tuy nhiên, synthetic data có một giới hạn quan trọng: nó không tự nhiên sinh ra edge case (những tình huống hiếm gặp nhưng đột biến mà dữ liệu gốc chưa từng có). Vì nó được tạo từ pattern đã học, nó chỉ "lặp lại" những gì dữ liệu thật đã có. Do đó, mọi mô hình huấn luyện trên synthetic data đều phải kiểm thử lại trên dữ liệu thật trước khi đưa vào dùng thật.
4 việc cụ thể generative AI giúp data scientist mỗi ngày
Đây là phần áp dụng vào công việc thật. Một data scientist có thể nhờ generative AI ở bốn bước trong quy trình dữ liệu — không phải bước nào cũng cần dùng, và không phải lúc nào nó cũng thay thế được con người.
1. Augment dữ liệu (bổ sung mẫu). Khi tập dữ liệu quá nhỏ hoặc mất cân bằng, generative AI giúp tạo thêm mẫu "giả mà thật" để mô hình học đa dạng hơn. Ví dụ: thêm ảnh khối u ở góc chụp hiếm, thêm giao dịch giả lập kịch bản gian lận. Cách này đặc biệt hiệu quả với ảnh và dữ liệu dạng bảng có cấu trúc.
2. Viết và kiểm thử code. LLM rất giỏi sinh code theo yêu cầu bằng tiếng Việt hoặc tiếng Anh. Bạn có thể nhờ viết hàm pandas gộp hai bảng, viết truy vấn SQL trích khách hàng mua lại trong 30 ngày, hoặc giải thích một đoạn code lỗi mà bạn đọc mãi không hiểu. Tuy nhiên, output luôn cần được chạy thử và đọc lại — LLM có thể viết code chạy được nhưng sai logic nghiệp vụ.
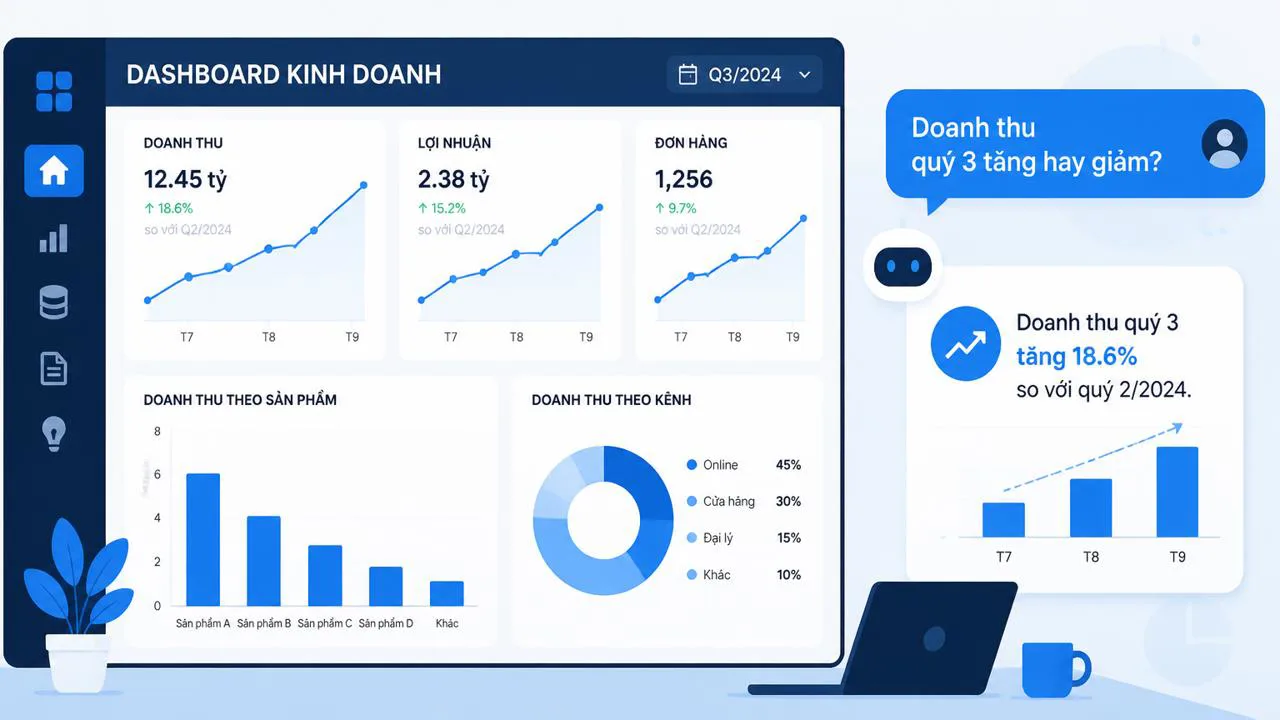
3. Sinh insight và báo cáo tự động. Thay vì ngồi kéo bảng, lọc, vẽ biểu đồ thủ công, bạn có thể hỏi trực tiếp bằng ngôn ngữ tự nhiên. Ví dụ: "Doanh thu theo khu vực trong quý 3 tăng hay giảm so với quý 2, nguyên nhân chính là gì?" Một số công cụ BI (business intelligence — phân tích kinh doanh) như IBM Cognos Analytics cho phép đặt câu hỏi bằng tiếng Anh hoặc tiếng Việt, tự dò dữ liệu và cập nhật khi dữ liệu đổi. Nếu bạn muốn tham khảo thêm các mô hình có sẵn có thể tích hợp, hãy xem Model Asset eXchange (MAX) — kho model có sẵn.
4. Khám phá pattern ẩn. Generative AI có thể quét hàng vạn biến số, đề xuất những giả thuyết (hypothesis — phỏng đoán có thể kiểm chứng) mà con người chưa nghĩ tới. Ví dụ: "Có mối liên hệ giữa thời tiết và tỷ lệ hủy đơn không?" Model đề xuất, bạn kiểm chứng — thay vì bạn phải tự nghĩ hết mọi khả năng.
Generative AI không thay data scientist — nó giúp data scientist làm 4 việc nhanh hơn: bổ sung dữ liệu, viết code, sinh báo cáo, và đề xuất giả thuyết mới.
Ví dụ ngành dễ hình dung
Để bạn thấy rõ 4 việc trên hoạt động ngoài đời thực, đây là vài ngành gần với người Việt:
- Y tế: tạo ảnh y khoa giả để đào tạo bác sĩ đọc X-quang, mô phỏng phản ứng phụ của dược liệu mới mà chưa cần thử trên người.
- Tài chính: mô phỏng kịch bản thị trường (giá vàng giảm mạnh, lãi suất tăng đột ngột) để stress-test mô hình đánh giá rủi ro.
- Marketing và bán lẻ: cá nhân hoá nội dung quảng cáo theo từng nhóm khách — mỗi nhóm nhận một phiên bản hình ảnh và câu chữ khác nhau được sinh tự động.
- Game và thời trang: tạo nhân vật mới, texture vải, hoặc mẫu thiết kế thử nghiệm trước khi đưa vào sản xuất thật.
Cảnh báo thực tế trước khi dùng
Generative AI tiện nhưng có ba điểm bạn phải luôn ghi nhớ, đặc biệt trong giai đoạn 2025–2026 khi công cụ thay đổi rất nhanh:
Hallucination — AI bịa rất tự tin. Mô hình ngôn ngữ có thể sinh ra con số, trích dẫn, hoặc sự kiện trông rất hợp lý nhưng hoàn toàn sai. Một báo cáo tự động có thể nói "doanh thu tháng 6 tăng 15%" trong khi dữ liệu thật là giảm 8%. Vì vậy, mọi con số quan trọng đều phải kiểm lại bằng dữ liệu gốc.
Bias — thiên kiến từ dữ liệu huấn luyện. Generative AI học từ dữ liệu có sẵn, nên mọi thiên kiến trong dữ liệu đều xuất hiện trong output. Nếu dữ liệu huấn luyện thiếu mẫu của một nhóm người dùng, synthetic data cũng sẽ thiếu nhóm đó — và mô hình sẽ phục vụ nhóm đó kém hơn.
Công cụ và giá thay đổi liên tục. Trong 2025–2026, các công cụ AI tạo sinh được nâng cấp và đổi giá theo từng quý. Trước khi chọn một công cụ cụ thể để dùng lâu dài, hãy đọc lại trang chính hãng để biết tính năng, giới hạn sử dụng và chi phí hiện tại — bài viết này không đưa ra con số giá cụ thể vì chúng thay đổi quá nhanh.
Bảng thuật ngữ tra nhanh
| Thuật ngữ | Giải thích ngắn |
|---|---|
| Generative AI | AI tạo ra nội dung mới (văn bản, ảnh, nhạc, code, dữ liệu) dựa trên pattern học được. |
| AI phân tích (analytical AI) | AI đọc dữ liệu rồi phân loại hoặc dự đoán, không tạo nội dung mới. |
| Deep learning | Mạng nơ-ron nhiều lớp — nền tảng của hầu hết generative AI hiện đại. |
| GAN | Hai mạng đấu nhau: một vẽ giả, một phát hiện giả, kết quả là ảnh giả ngày càng giống thật. |
| VAE | Nén dữ liệu thành dạng rút gọn rồi phục hồi thành mẫu mới cùng phong cách. |
| LLM | Mô hình ngôn ngữ lớn, generative AI chuyên về chữ (GPT, Claude, Gemini). |
| Synthetic data | Dữ liệu do máy tạo, có cùng phổ với dữ liệu thật nhưng không phải dữ liệu thật. |
| Distribution (phổ phân bố) | Cách các giá trị trong dữ liệu phân bổ — ví dụ phần lớn khách hàng mua dưới 500k, một số ít mua trên 5 triệu. |
| NLP (Natural Language Processing) | Xử lý ngôn ngữ tự nhiên — nhánh AI giúp máy đọc–hiểu–viết tiếng người. |
| Hypothesis (giả thuyết) | Phỏng đoán có thể kiểm chứng bằng dữ liệu — ví dụ "mưa nhiều thì hủy đơn tăng". |
Tóm lại: 5 việc cần ghi nhớ khi bắt đầu dùng generative AI trong data science
- Biết khái niệm: generative AI tạo thứ mới, AI phân tích đọc rồi phán đoán — hai nhánh khác nhau.
- Biết ba mô hình nền tảng: GAN (đấu nhau), VAE (nén–phục hồi), LLM (chuyên chữ) — đủ dùng cho phần lớn tình huống thực tế.
- Biết 4 chỗ dùng: bổ sung dữ liệu, viết code, sinh báo cáo, khám phá pattern ẩn.
- Biết giới hạn: synthetic data không tạo edge case mới; AI có thể bịa số (hallucination) và lặp lại thiên kiến (bias) từ dữ liệu huấn luyện.
- Luôn kiểm tra lại: dùng AI để nhanh hơn, nhưng giữ thói quen đối chiếu output với dữ liệu gốc trước khi đưa ra quyết định.
Generative AI không thay thế data scientist, nhưng là một trợ lủng mới — giống như máy tính không thay thế kế toán, nhưng giúp kế toán làm việc nhanh hơn rất nhiều. Nắm vững 4 chỗ dùng ở trên và luôn kiểm tra lại, bạn đã có thể áp dụng ngay vào công việc hằng ngày mà không sợ phụ thuộc mù quáng vào máy.
Tags
- generative AI
- machine learning
- VAE
- data science
- ứng dụng AI
- synthetic data
- LLM
- học máy
- phân tích dữ liệu
- GAN
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.