Data Science
Data Preparation Trong Data Science: Case Study Suy Tim Sung Huyết Thực Tế
Data preparation trong y tế không phải chạy mô hình, mà là lọc đúng nhóm CHF theo ICD, đặt ngưỡng 30 ngày, gom dữ liệu giao dịch thành một dòng mỗi bệnh nhân, và sẵn sàng quay lại bổ sung khi thiếu chỉ tiêu.
 Phong Nguyen
PNTECH Writer · 23/09/2026
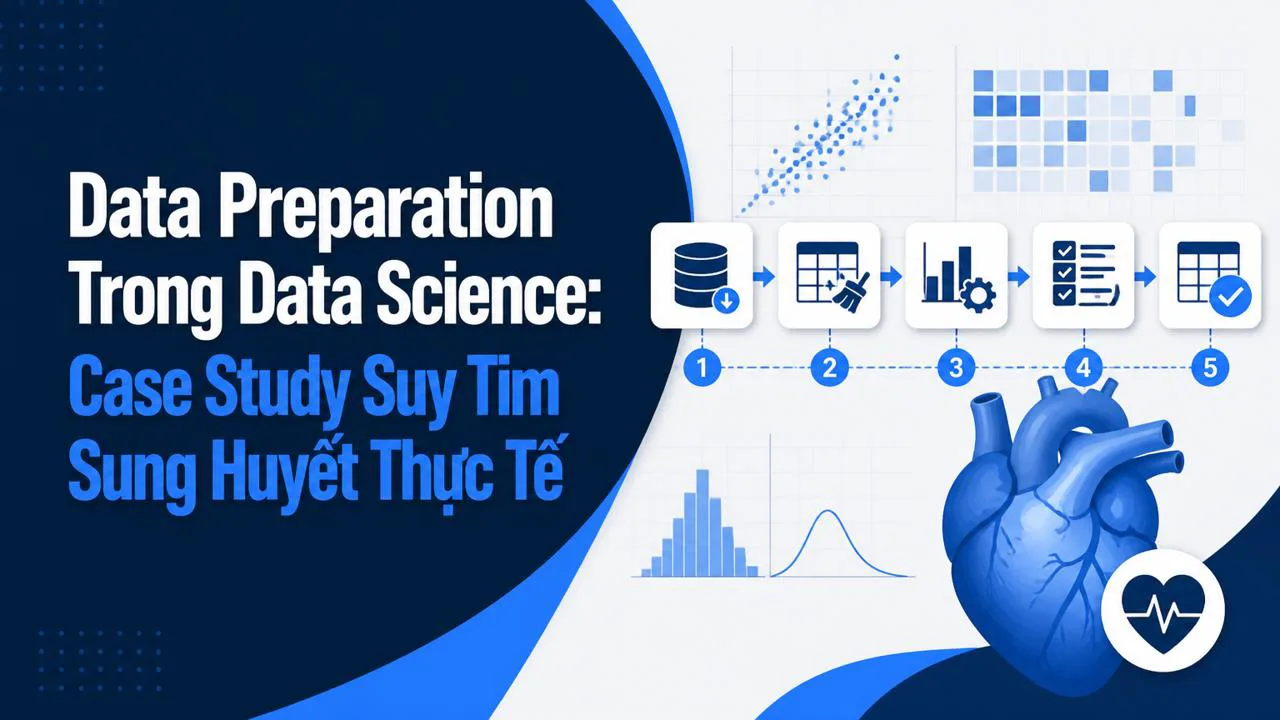
Bạn có khoảng 300 dòng dữ liệu khám, xét nghiệm, kê đơn, nhập – xuất viện của một bệnh nhân suy tim. Mô hình dự đoán chỉ chấp nhận đúng một dòng cho mỗi người. Khoảng cách giữa "dữ liệu thô chất đống" và "một dòng sạch đưa vào mô hình" chính là toàn bộ công việc của giai đoạn Data Preparation — và bài viết này sẽ đi qua đúng 5 bước cụ thể bằng một case study y tế thật: dự đoán bệnh nhân suy tim sung huyết (CHF) có tái nhập viện trong 30 ngày hay không.
Tại sao case study này đáng xem
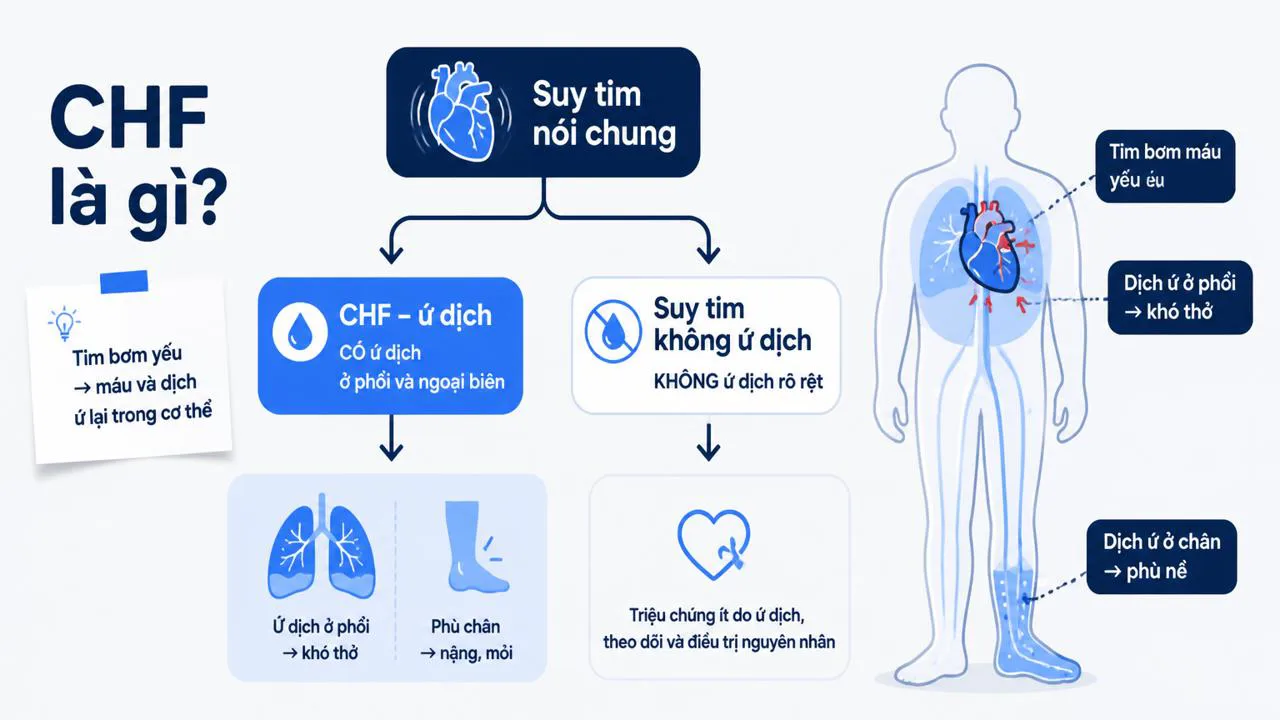
Suy tim sung huyết (Congestive Heart Failure, viết tắt CHF) là tình trạng tim bơm máu không đủ hiệu quả, khiến chất lỏng ứ lại ở phổi, chân, gan. Đây không phải mọi ca suy tim — nhiều người bị suy tim nhưng không có dấu hiệu ứ dịch, và cách điều trị, theo dõi sẽ khác hẳn. Vì vậy khi làm data science cho bài toán này, bước đầu tiên không phải là chạy thuật toán, mà là trả lời: nhóm bệnh nhân nào mới đúng là CHF?
Bài toán đặt ra rất cụ thể: với một bệnh nhân vừa xuất viện, dự đoán xem họ có quay lại nhập viện vì CHF trong vòng 30 ngày hay không. Đầu ra mong muốn chỉ là một giá trị Có hoặc Không cho mỗi người — gọi là biến mục tiêu Y. Ngưỡng 30 ngày không phải con số ngẫu nhiên: đây là mốc được cộng đồng lâm sàng (bác sĩ, nhà nghiên cứu y khoa) dùng để đo chất lượng chăm sóc sau xuất viện. Trong ngôn ngữ bệnh viện, lần nhập viện đầu tiên được gọi là index admission, còn lần quay lại là readmission.
Bước 1 – Lọc đúng nhóm bệnh bằng mã chẩn đoán
Trong hệ thống y tế, mỗi lần khám được gán một mã chẩn đoán theo bảng phân loại bệnh quốc tế (ICD). Thay vì đọc từng hồ sơ, người làm data dùng chính các mã này để lọc. Ví dụ, trong bảng ICD-9, mã 428.0 là suy tim sung huyết không xác định — đây là mã đặc trưng cho CHF. Có những mã chỉ suy tim nói chung, có mã chỉ CHF, nên chọn đúng mã là bước sống còn: gộp chung hai nhóm sẽ làm mô hình học sai đối tượng.
Vì sao phải cẩn thận đến vậy? Vì các hướng dẫn lâm sàng (clinical guidelines) quy định rõ: bệnh nhân CHF được theo dõi, dùng thuốc lợi tiểu, đánh giá dấu hiệu ứ dịch theo cách riêng. Nếu tập dữ liệu lẫn cả ca suy tim không ứ dịch, mọi phân tích phía sau sẽ bị nhiễu. Tóm lại, bước 1 là: dùng hướng dẫn lâm sàng để chọn mã chẩn đoán CHF, lọc các bản ghi có mã phù hợp, kèm các dấu hiệu đặc trưng của CHF (như phù, khó thở do ứ dịch phổi).
Bước 2 – Đặt ngưỡng 30 ngày và xác định index admission
Sau khi có danh sách các đợt nhập viện vì CHF, bước tiếp theo là sắp xếp lại theo trình tự thời gian cho từng bệnh nhân. Bạn cần xác định: lần nhập viện nào là index admission (lần đầu trong khoảng quan sát), và lần nào được tính là readmission (tái nhập viện trong 30 ngày kể từ lần xuất viện gần nhất). Ví dụ: bệnh nhân A nhập viện CHF ngày 1/3, xuất viện 8/3, quay lại nhập viện ngày 2/4 — lần 2/4 được tính là readmission trong 30 ngày, dù thực tế cách 25 ngày sau xuất viện.
Ngưỡng 30 ngày đến từ chuyên môn y khoa vì đây là khoảng thời gian phản ánh tốt nhất việc chăm sóc sau xuất viện có hiệu quả hay không. Tự ý đổi thành 60 hay 90 ngày sẽ thay đổi ý nghĩa bài toán và rất khó đối chiếu với các nghiên cứu khác. Đặt ngưỡng 30 ngày chính là bước 2: từ một chuỗi sự kiện y tế lộn xộn, bạn rút ra được cho mỗi bệnh nhân một nhãn Có/Không tái nhập viện.
Ngưỡng 30 ngày không phải con số ngẫu nhiên — nó là mốc mà cộng đồng lâm sàng dùng để đo chất lượng chăm sóc sau xuất viện, và thay đổi nó đồng nghĩa thay đổi bài toán.
Bước 3 – Tổng hợp dữ liệu giao dịch về dạng cấp bệnh nhân
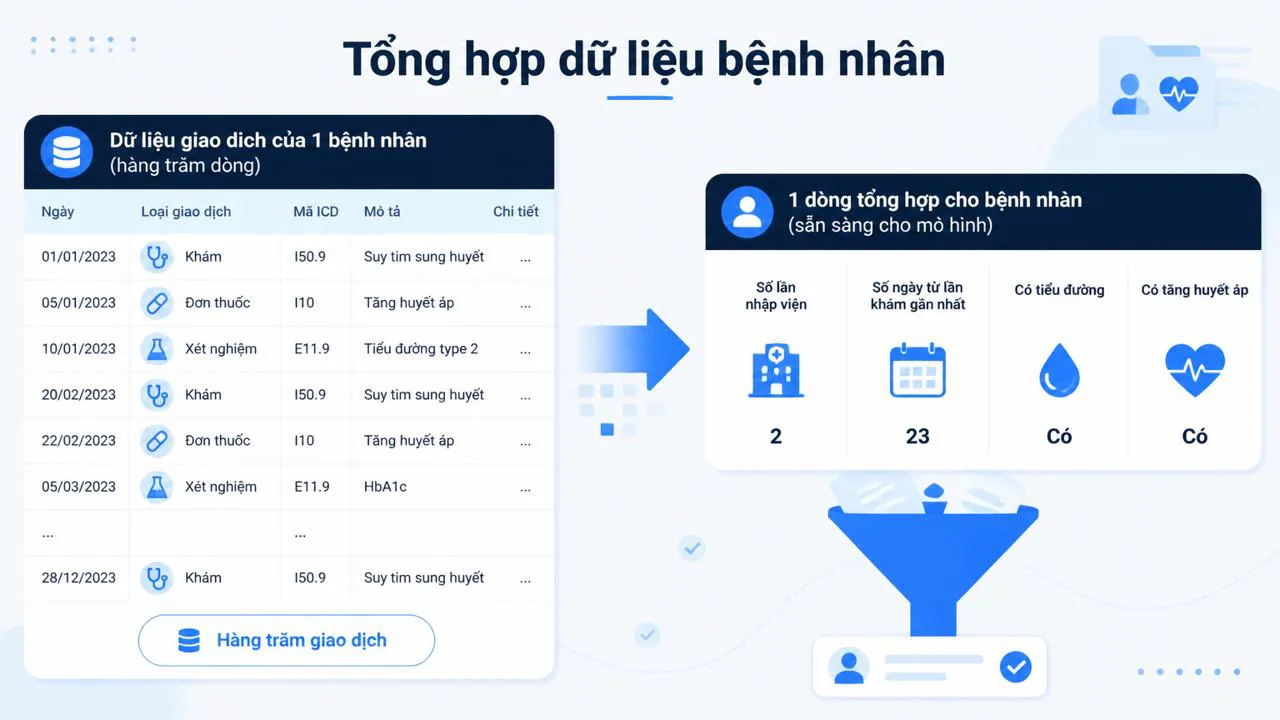
Dữ liệu y tế thô thường ở dạng giao dịch (transactional): mỗi lần khám, mỗi đơn thuốc, mỗi xét nghiệm là một dòng riêng. Một bệnh nhân CHF nặng có thể có vài trăm đến vài ngàn dòng trong vài năm. Tuy nhiên, phần lớn mô hình dự đoán phổ biến — ví dụ decision tree (cây quyết định — thuật toán phân loại/dự đoán bằng cách chia dữ liệu thành các nhánh có/không) — yêu cầu đúng một dòng cho mỗi đối tượng. Đây là lúc cần đến phép tổng hợp (aggregation): gộp nhiều dòng giao dịch thành một dòng duy nhất đại diện cho cả bệnh nhân.
Ví dụ cụ thể: bệnh nhân A có 300 dòng dữ liệu trong 2 năm. Sau khi tổng hợp, bạn có một dòng duy nhất gồm: tổng số lần nhập viện, tổng số lần khám ngoại trú, số ngày kể từ lần khám gần nhất, số loại thuốc đã dùng, có kèm tiểu đường hay không, có kèm tăng huyết áp hay không. Quy trình này không tự động 100% — bạn phải quyết định dùng phép đếm, phép cộng, lấy giá trị lớn nhất, hay lấy giá trị gần nhất cho mỗi cột. Nói cách khác, bạn đang "nén" cả một hành trình điều trị dài thành một bức chân dung tóm tắt.
Nếu bạn đã đọc bài tổng quan về chuỗi 10 giai đoạn, bước này nằm trong giai đoạn số 4 của methodology — bạn có thể xem lại 10 giai đoạn trong Data Science Methodology để hình dung vị trí của nó. Còn nếu muốn tìm hiểu kỹ hơn về các phép xử lý dữ liệu chung (xử lý giá trị thiếu, chuẩn hóa), có thể tham khảo thêm bài về các kỹ thuật tiền xử lý dữ liệu chung để đối chiếu.
Bước 4 – Tạo cột đặc trưng mới và gắn nhãn biến mục tiêu
Quá trình tổng hợp ở bước 3 chính là lúc các cột đặc trưng (feature) mới được sinh ra. Những cột này là "nguyên liệu" đầu vào cho mô hình — gọi chung là biến đầu vào X. Trong case study CHF, các cột đặc trưng tiêu biểu gồm: tần suất khám trong một khoảng thời gian, số ngày kể từ lần khám gần nhất, có mắc thêm tiểu đường không, có mắc thêm tăng huyết áp không, tuổi, giới tính, loại bảo hiểm. Mỗi cột phản ánh một góc nhìn về bệnh nhân, và tập hợp lại sẽ giúp mô hình phân biệt người có nguy cơ tái nhập viện cao với người có nguy cơ thấp.
Riêng biến mục tiêu Y là cột "Tái nhập viện CHF trong 30 ngày: Có/Không" — cột này được tạo ra từ bước 2 ở trên. Đến đây, bạn đã có một bảng gọn gàng: mỗi hàng là một bệnh nhân, mỗi cột là một đặc trưng, và có đúng một cột Y để mô hình học cách dự đoán. Đây cũng là lúc bạn nhìn lại toàn bộ bảng để hỏi: cột nào thiếu nhiều? cột nào không còn ý nghĩa? cột nào cần đổi kiểu dữ liệu?
Bước 5 – Rà soát và sẵn sàng quay lại giai đoạn trước
Một trong những đặc điểm quan trọng nhất của Data Preparation là tính lặp (iterative). Nghĩa là bạn không chỉ làm một lần rồi đi tiếp — bạn phải quay lại bất cứ khi nào phát hiện thiếu. Ví dụ: sau khi tạo xong các cột đặc trưng, bạn nhận ra không có dữ liệu về chỉ số phân suất tống máu (EF — chỉ số đo khả năng bơm máu của tim) — đây là yếu tố rất quan trọng với CHF. Lúc này, bạn phải quay lại giai đoạn Data Collection để bổ sung, không phải cố "chữa cháy" bằng cách bịa giá trị.
Việc quay lại thu thập dữ liệu khi thiếu chỉ tiêu là chuyện bình thường, không phải thất bại. Ngược lại, tâm lý "đã chuẩn bị xong rồi, cứ chạy mô hình đi" mới là rủi ro thật sự. Nếu bạn muốn đọc kỹ hơn về cách thu thập dữ liệu theo vòng lặp, có thể tham khảo quay lại giai đoạn Data Collection khi thiếu chỉ tiêu. Còn về giai đoạn liền kề trước đó, bạn có thể xem lại bước Data Understanding trước đó để thấy Data Preparation không tách rời mà nối tiếp tự nhiên.
Kết quả cuối của case study này, theo tài liệu gốc, là khoảng 2.343 bệnh nhân đáp ứng đủ tiêu chí lọc CHF và có đủ dữ liệu để đưa vào mô hình. Con số này cần kiểm tra lại từ nguồn case study IBM/Coursera vì có thể đến từ một bản trình bày cụ thể trong khóa học, không phải nghiên cứu peer-reviewed. Tập dữ liệu này sau đó được chia thành tập huấn luyện (training) để mô hình học, và tập kiểm tra (testing) để đánh giá — chia theo tỷ lệ phổ biến như 70/30 hoặc 80/20.
Chuẩn bị dữ liệu không phải làm một lần cho xong — đó là vòng lặp: lọc, tổng hợp, rà soát, phát hiện thiếu, quay lại thu thập, rồi lặp lại.
5 sai lầm thường gặp khi chuẩn bị dữ liệu y tế
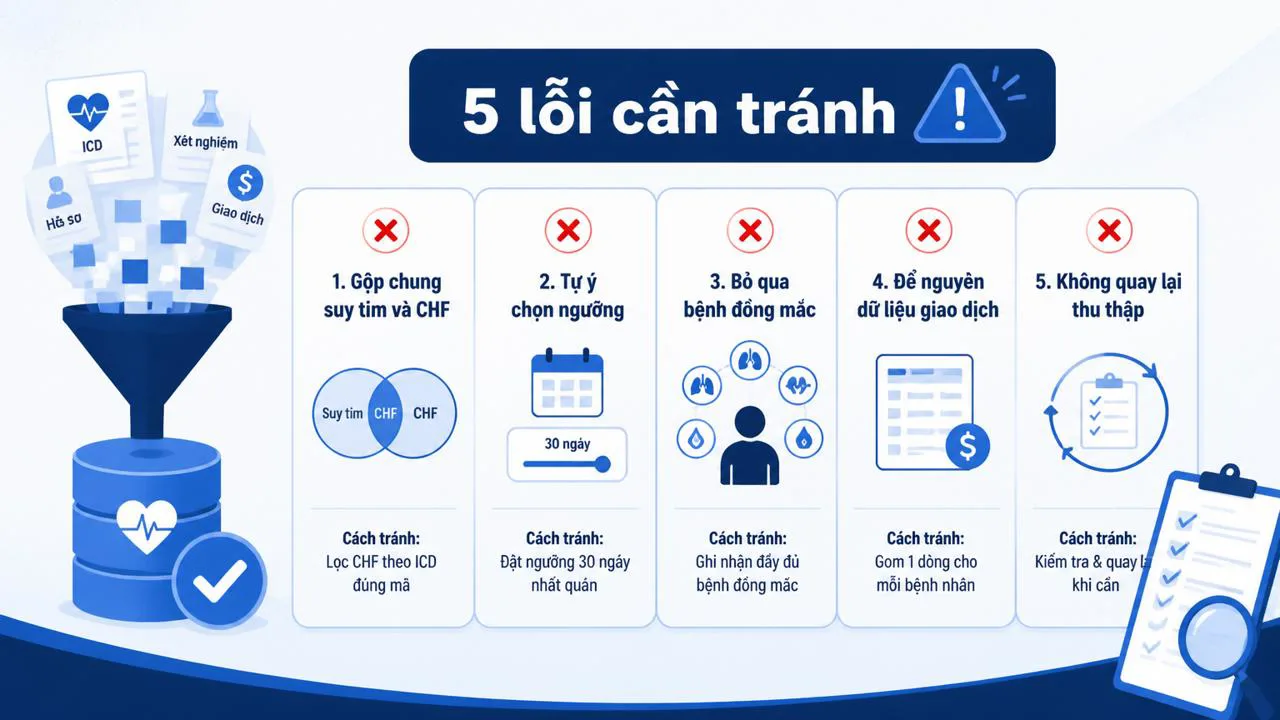
Sai lầm thứ nhất là gộp chung "suy tim" và "suy tim sung huyết". Hai nhóm này có đặc điểm lâm sàng khác nhau, cách điều trị khác nhau, nên gộp lại sẽ khiến mô hình học sai. Sai lầm thứ hai là tự ý chọn ngưỡng thời gian (30, 60, 90 ngày) mà không dựa trên guideline hoặc mục tiêu nghiệp vụ rõ ràng — làm vậy sẽ khó đối chiếu kết quả với các nghiên cứu khác.
Sai lầm thứ ba là bỏ qua bệnh đồng mắc. Tiểu đường, tăng huyết áp, bệnh thận mạn ảnh hưởng trực tiếp đến khả năng tái nhập viện của bệnh nhân CHF, nên cần có cột đặc trưng riêng. Sai lầm thứ tư là để nguyên dữ liệu giao dịch khi mô hình cần dạng cấp bệnh nhân — đây là lỗi kỹ thuật phổ biến khi người mới bắt đầu làm data y tế. Sai lầm thứ năm là tâm lý "đã chuẩn bị xong, không quay lại". Data Preparation là vòng lặp, không phải đường thẳng một chiều.
Bảy điểm cần nhớ trước khi sang giai đoạn Modeling
Thứ nhất, CHF không phải mọi ca suy tim — phải lọc đúng theo guideline và mã ICD. Thứ hai, ngưỡng 30 ngày đến từ chuyên môn lâm sàng, không phải phỏng đoán. Thứ ba, dữ liệu y tế thường là dạng giao dịch và phải được tổng hợp về dạng cấp bệnh nhân trước khi đưa vào mô hình. Thứ tư, bệnh đồng mắc cần có cột đặc trưng riêng vì ảnh hưởng trực tiếp đến biến mục tiêu.
Thứ năm, biến mục tiêu Y là Có/Không tái nhập viện do CHF trong 30 ngày, còn biến đầu vào X là tập các cột đặc trưng sinh ra từ quá trình tổng hợp. Thứ sáu, việc quay lại giai đoạn Data Collection khi thiếu chỉ tiêu là bình thường, không phải thất bại. Thứ bảy, kết quả của case study này là khoảng 2.343 bệnh nhân đáp ứng tiêu chí (cần kiểm tra lại nguồn gốc), được chia thành tập huấn luyện và tập kiểm tra để chuẩn bị cho giai đoạn Modeling.
Nếu bạn muốn nhìn case study này trong bức tranh rộng hơn về ứng dụng data science trong y tế — không chỉ CHF mà còn nhiều bài toán khác như cảnh báo thiên tai, dịch bệnh — có thể đọc thêm bài về ứng dụng data science trong y tế nói chung. Còn khi sẵn sàng bước sang giai đoạn tiếp theo (Modeling), hãy quay lại bài tổng quan methodology để biết bạn đang đứng ở giai đoạn nào trong chuỗi 10 bước.
Tags
- y tế
- CHF
- data preparation
- data science
- tiền xử lý dữ liệu
- mã ICD
- bệnh đồng mắc
- tái nhập viện
- suy tim sung huyết
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.