Data Science
Data Science Giải Quyết Bài Toán Cũ Như Thế Nào: 3 Ví Dụ Thực Tế Từ Uber, Giao Thông Và Hồ Nước
Data science không phải phép màu mà là quy trình 5 bước lặp lại được. Bài đi qua 3 ví dụ thực tế từ Uber, giao thông Toronto và hồ nước để bạn thấy cách áp dụng vào công việc của mình, kèm checklist bắt đầu dự án.
 Phong Nguyen
PNTECH Writer · 15/09/2026
Data Science giải quyết bài toán cũ như thế nào: 3 ví dụ thực tế từ Uber, giao thông và hồ nước
Bạn đã đọc nhiều bài giới thiệu data science nhưng vẫn thấy mơ hồ? Đây là bài viết đi thẳng vào 3 vấn đề đời thường — đón xe khó, kẹt đường giờ cao điểm, hồ nước bị ô nhiễm — để bạn thấy data science giải quyết vấn đề cũ ra sao bằng một quy trình 5 bước lặp lại được ở mọi ngành. Bạn không cần biết Python hay thuật toán; chỉ cần hiểu workflow và nhìn ra cách áp dụng vào công việc của mình.
Vì sao những bài toán cũ giờ mới giải được?
Kẹt xe giờ cao điểm, gọi xe mãi không có tài xế, hồ nước bỗng dưng xanh đục có mùi — đây là những vấn đề đã tồn tại hàng chục năm. Vậy tại sao giờ chúng ta lại có cơ hội giải tốt hơn? Câu trả lời nằm ở ba thứ: dữ liệu giờ rẻ hơn, cảm biến (sensor) phủ rộng hơn, và máy tính đủ mạnh để xử lý khối lượng lớn trong thời gian ngắn.
Data science, nói đơn giản, là cách thu thập và làm sạch dữ liệu, rồi phân tích để ra quyết định cụ thể thay vì đoán mò. Trong đó, machine learning (máy học) là một nhánh của data science: thay vì lập trình từng quy tắc, người ta cho máy xem nhiều dữ liệu mẫu để nó tự rút ra quy luật — giống như đứa trẻ xem nhiều ảnh mèo rồi tự phân biệt được mèo với chó. Cùng một workflow này có thể áp dụng cho giao thông, môi trường, tài chính, bán lẻ — bất kỳ ngành nào có dữ liệu.
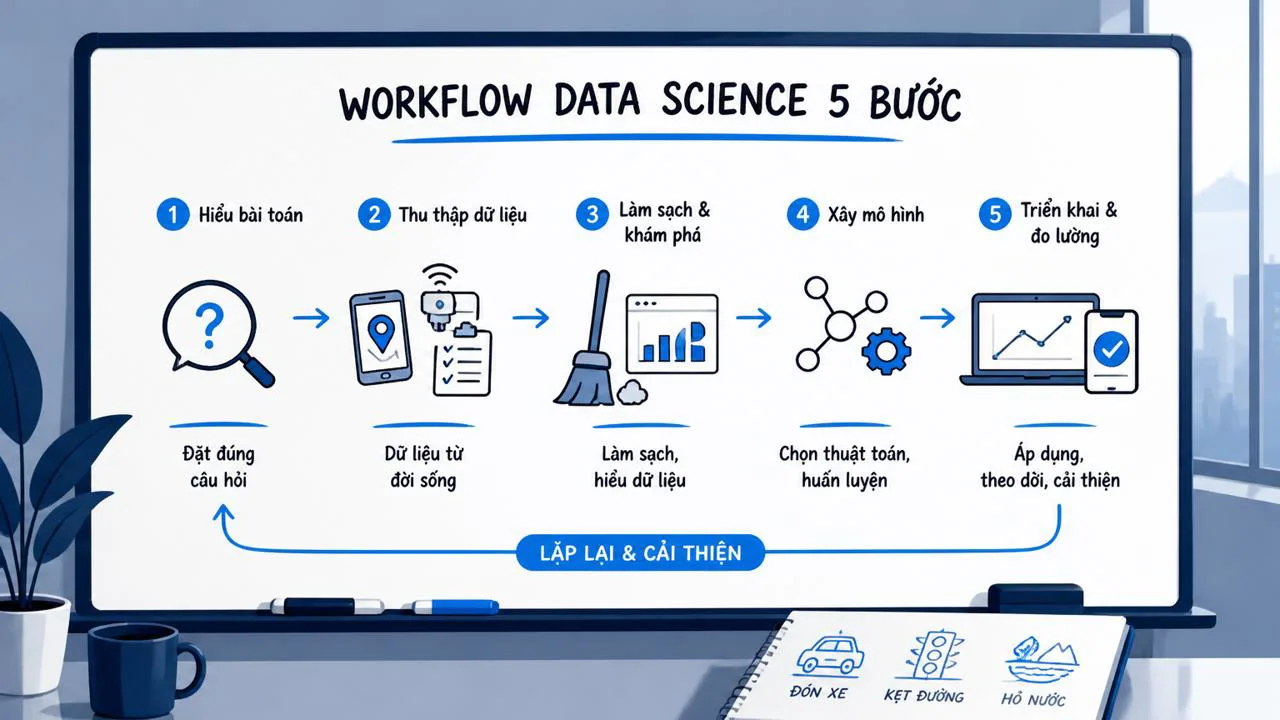
Data science không phải phép màu — nó là quy trình 5 bước lặp lại được, áp dụng được cho bất kỳ ngành nào có dữ liệu.
Nếu bạn muốn hiểu sâu hơn khái niệm nền tảng và vai trò trong doanh nghiệp, hãy đọc tiếp bài Data Science Là Gì? Khái Niệm, Quy Trình Và Vai Trò Trong Doanh Nghiệp trước khi quay lại xem các case thực tế dưới đây.
Ví dụ 1: Uber cân bằng cung cầu xe bằng dữ liệu thời gian thực
Bài toán cũ tưởng chừng đơn giản: làm sao có đủ tài xế ở đúng nơi, đúng giờ khách cần. Trước đây, công ty taxi truyền thống giải bằng kinh nghiệm của tổng đài — nhưng khi hàng triệu chuyến xe diễn ra mỗi ngày, kinh nghiệm không đủ.
Uber áp dụng cơ chế dynamic pricing (giá nhảy theo cung cầu), hay còn gọi là surge pricing. Bạn có thể hình dung quen thuộc hơn qua ví dụ giá vé máy bay: cùng một chặng, giờ cao điểm đắt gấp rưỡi hoặc gấp đôi, còn giờ thấp điểm rẻ hơn nhiều. Uber cũng vậy — khi một khu vực đang ít xe trong khi nhu cầu cao, giá chuyến sẽ tăng để hấp dẫn tài xế chạy tới. Khi đã có đủ xe, giá tự hạ về mức bình thường.
Áp quy trình 5 bước cho Uber:
- Vấn đề: thiếu tài xế ở một số khu vực vào giờ cao điểm hoặc sự kiện lớn.
- Dữ liệu: vị trí tài xế và vị trí khách theo thời gian thực, lịch sử yêu cầu xe theo khu vực theo giờ.
- Công cụ: thuật toán dự đoán cung cầu — dựa trên dữ liệu lịch sử, máy sẽ ước lượng nhu cầu sắp tới và tính mức giá phù hợp.
- Chiến lược: tăng giá surge khi cung thiếu, đồng thời thông báo cho tài xế gần đó rằng khu vực đang hấp dẫn.
- Kết quả: cân bằng lại cung cầu mà không cần ai đứng điều phối thủ công.
Bài học rút ra: dữ liệu thời gian thực cộng thuật toán có thể tự động cân bằng thị trường — điều mà phương pháp thủ công không làm nổi ở quy mô lớn. Bạn có thể tìm hiểu thêm các ứng dụng tương tự trong bài Ứng Dụng Machine Learning Trong Đời Sống Và Tài Chính.
Ví dụ 2: Giảm kẹt xe ở Toronto bằng dữ liệu khiếu nại và tín hiệu điện thoại
Toronto (TTC — cơ quan vận hành xe buýt và streetcar) cũng đối mặt bài toán cũ: giờ cao điểm kẹt xe khiến hành khách đi làm muộn. Họ không có đủ camera để phủ hết mạng lưới, nhưng họ có hai nguồn dữ liệu tưởng như không liên quan: log khiếu nại khách hàng và probe data (tín hiệu vị trí từ điện thoại di động và thiết bị GPS trên xe — từ đó suy ra đoạn đường nào đang đông, đoạn nào thông).
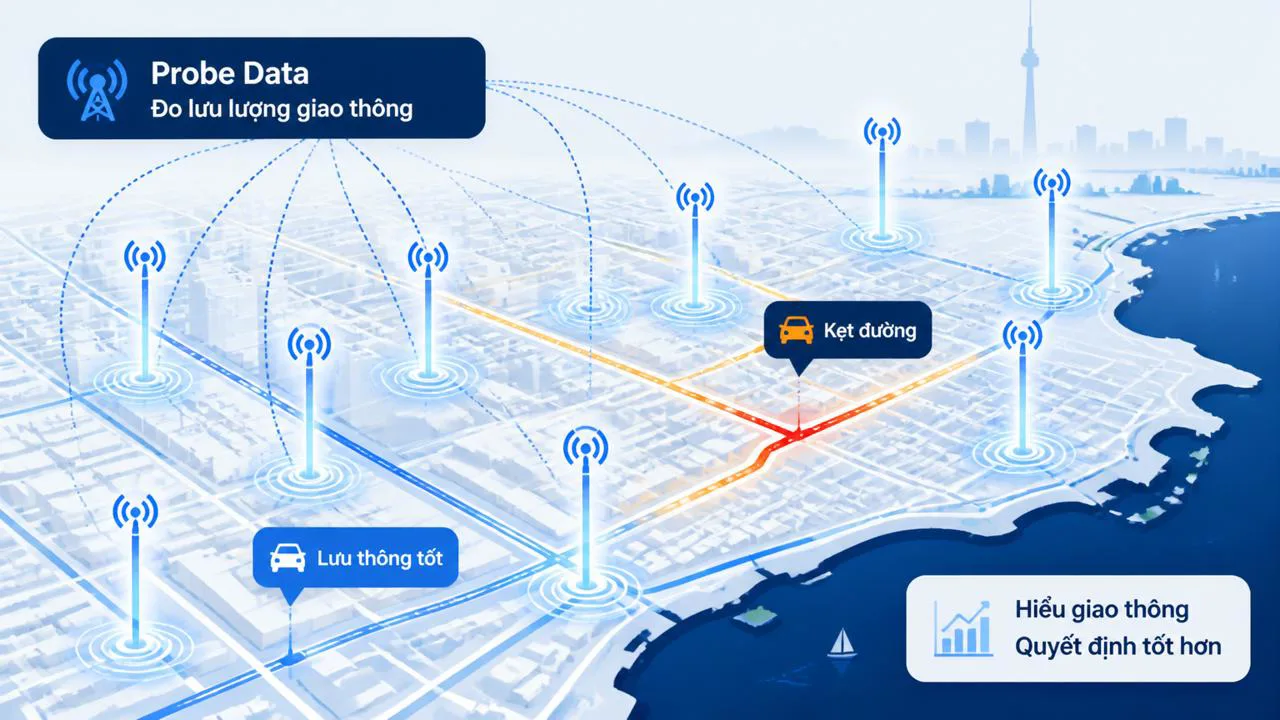
Áp quy trình 5 bước cho TTC:
- Vấn đề: tắc nghẽn giờ cao điểm làm tăng thời gian di chuyển và giảm độ hài lòng hành khách.
- Dữ liệu: probe data từ điện thoại, log khiếu nại hành khách, dữ liệu vận hành streetcar (xe điện mặt đất), dữ liệu lịch trình tuyến.
- Công cụ: phân tích thống kê kết hợp mô hình dự đoán để xác định các điểm nghẽn lặp lại theo giờ, theo ngày trong tuần.
- Chiến lược: lập đội big-data riêng, đặt mục tiêu đo lường rõ ràng (số giờ kẹt xe trung bình mỗi tháng), điều chỉnh lịch trình và phân bổ xe theo dữ liệu.
- Kết quả (cần verify lại từ báo cáo chính thức của TTC trước khi đăng): thời gian kẹt xe trung bình mỗi tháng được cho là giảm từ khoảng 4,75 giờ (năm 2010) xuống còn khoảng 3 giờ (giữa năm 2014).
Khiếu nại khách hàng và tín hiệu vị trí từ điện thoại là hai nguồn dữ liệu thường bị bỏ qua — nhưng lại là mỏ vàng để hiểu vấn đề thực tế.
Bài học rút ra: đừng chỉ nhìn vào dữ liệu truyền thống (camera, báo cáo nội bộ). Khiếu nại và probe data có thể tiết lộ các điểm nghẽn mà bạn không thấy. Nếu bạn đang vận hành một doanh nghiệp nhỏ, bài Ứng Dụng Data Science Trong Kinh Doanh Và Vận Hành Doanh Nghiệp sẽ cho bạn thêm góc nhìn thực tế.
Ví dụ 3: Cảnh báo sớm tảo độc trong hồ nước
Bài toán cũ tiếp theo: cyanobacterial bloom — hiện tượng tảo nở hoa làm nước hồ chuyển xanh đục và sinh ra độc tố nguy hiểm cho người, vật nuôi và hệ sinh thái. Điều khó nhất là bloom xuất hiện rất nhanh, đôi khi chỉ trong vài ngày, khiến các hồ công viên hoặc nguồn cấp nước phải đóng cửa khẩn cấp.
Cách giải cũ là lấy mẫu nước định kỳ rồi xét nghiệm trong phòng thí nghiệm — chậm và tốn kém. Cách giải mới dùng dữ liệu:
- Dữ liệu: thuyền robot (robotic boat), phao nổi có cảm biến, drone bay chụp nhiệt độ mặt nước, cộng thêm dữ liệu thời tiết và lịch sử bloom của từng hồ.
- Công cụ: mô hình thuật toán (algorithmic model) học từ dữ liệu quá khứ để dự đoán khi nào bloom có khả năng bùng — tương tự dự báo thời tiết nhưng cho tảo.
- Chiến lược: ra cảnh báo sớm cho cơ quan quản lý và người dân, đồng thời chuẩn bị sẵn phương án xử lý trước khi nước bị nhiễm.
- Kết quả: chuyển từ tư duy "chữa cháy" sang "phòng ngừa" — giảm thiệt hại sức khỏe và chi phí xử lý.
Bài học rút ra: khi dữ liệu đa nguồn (cảm biến, drone, lịch sử, thời tiết) được kết hợp, ta có thể phát hiện sớm những hiện tượng tưởng chừng bất ngờ. Đây cũng là lý do AI Và Data Science: Phân Biệt, Mối Liên Hệ Và Vai Trò Trong Quy Trình Dữ Liệu trở thành cặp khái niệm bạn nên nắm rõ.
Quy trình 5 bước áp dụng cho mọi bài toán
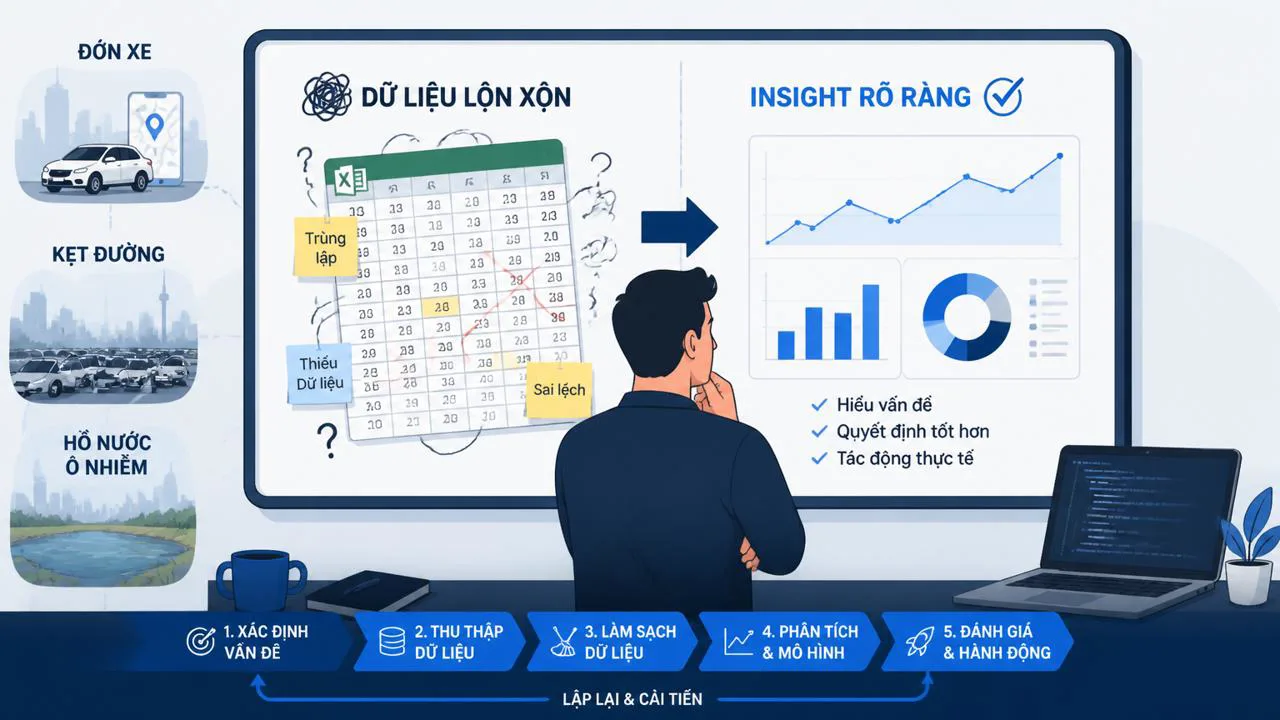
Dù là Uber, TTC hay giám sát hồ nước, cả ba ví dụ trên đều đi qua cùng một workflow. Ghi nhớ 5 bước sau sẽ giúp bạn bắt đầu bất kỳ dự án data science nào:
- Xác định vấn đề rõ ràng: mô tả được bằng con số hoặc câu hỏi cụ thể. Đừng nhảy sang chọn tool khi chưa thống nhất vấn đề.
- Thu thập dữ liệu đúng: kể cả nguồn phi truyền thống như khiếu nại, cảm biến IoT, tín hiệu vị trí.
- Làm sạch và chuẩn bị dữ liệu: dữ liệu bẩn sẽ cho ra model vô dụng, dù thuật toán có tốt.
- Chọn công cụ phân tích phù hợp: từ thống kê đơn giản đến mô hình machine learning, tùy mức độ phức tạp của vấn đề.
- Xây chiến lược dữ liệu dài hạn (data strategy) và áp dụng machine learning nếu phù hợp: data strategy là kế hoạch dùng dữ liệu liên tục, không phải làm một lần rồi thôi.
Quy trình data science là vòng lặp, không phải đường thẳng. Sau mỗi lần áp dụng, bạn sẽ hiểu vấn đề sâu hơn và điều chỉnh lại từ bước 1.
Nếu muốn tìm hiểu sâu hơn về cách khai thác dữ liệu thô thành quyết định, bài Data Mining Là Gì? Quy Trình 7 Bước Từ Dữ Liệu Thô Đến Quyết Định sẽ là bước đi tiếp theo hợp lý.
Checklist 5 điểm để bắt đầu một dự án data science
| Câu hỏi kiểm tra | Mục đích |
|---|---|
| Mình đã mô tả vấn đề bằng số liệu hoặc câu hỏi rõ ràng chưa? | Tránh chạy theo tool khi chưa hiểu việc cần giải. |
| Dữ liệu đang có đủ và sạch để trả lời câu hỏi đó không? | Dữ liệu thiếu hoặc bẩn là lý do số 1 khiến dự án thất bại. |
| Đã thử các nguồn phi truyền thống (khiếu nại, cảm biến, probe data) chưa? | Nguồn không ai nghĩ tới đôi khi lại quý nhất. |
| Có mục tiêu đo lường thành công rõ ràng chưa? | Ví dụ: giờ kẹt xe giảm bao nhiêu, số ca cảnh báo trễ giảm bao nhiêu. |
| Sau khi có dự đoán, ai sẽ hành động và làm gì? | Dự đoán không thôi là chưa đủ — phải gắn với hành động cụ thể. |
Sai lầm phổ biến cần tránh
Dù bạn mới bắt đầu hay đã thử vài lần, mấy lỗi sau vẫn xuất hiện rất thường xuyên. Tránh được chúng, bạn đã đi nhanh hơn 80% người mới:
- Nhảy thẳng vào chọn tool hoặc thuật toán khi chưa hiểu rõ vấn đề. Đây là lỗi phổ biến nhất.
- Bỏ qua bước làm sạch dữ liệu — tốn thời gian nhất nhưng lại bị cắt giảm.
- Coi thường nguồn dữ liệu phi truyền thống như khiếu nại, probe data, cảm biến.
- Coi data science là dự án một lần — thực tế phải vận hành liên tục, cập nhật model theo mùa, theo năm.
- Lẫn lộn giữa dự đoán và hành động: model cho ra con số thì cần kèm theo quy trình ai làm gì với con số đó.
Tổng kết
Data science giải được những bài toán cũ không phải vì có thuật toán thần kỳ, mà vì ba thứ kết hợp với nhau: dữ liệu giờ rẻ hơn và phong phú hơn, công cụ phân tích đủ mạnh cho người bình thường dùng được, và một quy trình 5 bước lặp lại được ở mọi ngành. Uber cân bằng cung cầu bằng surge pricing, TTC giảm kẹt xe bằng probe data và khiếu nại, các hồ nước cảnh báo sớm tảo độc bằng cảm biến và model dự đoán — cả ba đều đi qua cùng một workflow.
Nếu bạn muốn đào sâu hơn, hãy đọc tiếp quy trình data mining 7 bước và phân biệt AI với data science để hiểu rõ hơn cách từng khái niệm đan vào nhau trong thực tế.
Tags
- quy trình 5 bước
- machine learning
- ví dụ thực tế
- cảm biến IoT
- data science
- giao thông thông minh
- phân tích dữ liệu
- Uber surge pricing
- doanh nghiệp nhỏ
Câu hỏi thường gặp
Tiếp theo
Xem phần mềm — hoặc nhận tư vấn
Đọc xong thì chọn: phần mềm PN, công cụ khuyên dùng, hoặc nhờ mình làm theo nhu cầu.