Data Science
AI Và Data Science: Phân Biệt, Mối Liên Hệ Và Vai Trò Trong Quy Trình Dữ Liệu
AI và data science không phải một — chúng chồng lấn nhưng mục tiêu và đầu ra khác nhau. Bài tách bạch big data, data mining, machine learning, deep learning bằng ví dụ đời thường để bạn đọc tin, nói chuyện với đồng nghiệp và chọn hướng học mà không bị rối.
 Phong Nguyen
PNTECH Writer · 18/09/2026
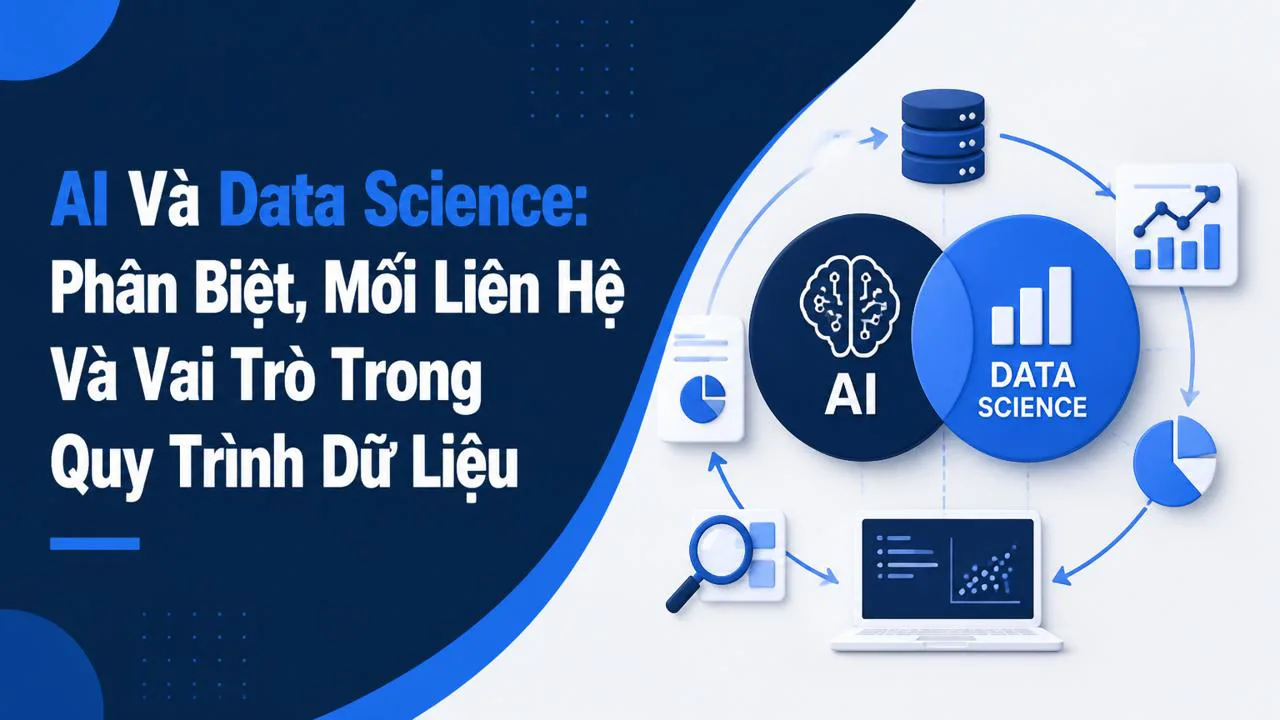
Bạn nghe ai đó nói "dự án này dùng AI", rồi người khác lại bảo "đây là data science" — và bạn tự hỏi hai cái đó có phải một không? Câu trả lời ngắn: không. AI và data science là hai lĩnh vực có phạm vi khác nhau, dù chúng hay đi cùng nhau trong cùng một dự án [S1][S2][S3]. Bài này sẽ tách từng khái niệm ra bằng ví dụ đời thường — từ big data, data mining, machine learning, deep learning cho tới neural network — để bạn đọc tin tức, nói chuyện với đồng nghiệp và chọn hướng học mà không bị rối.
Trước khi đi sâu, hãy nhớ một câu: AI là "mái nhà lớn" bao trùm nhiều thứ, còn data science là cách làm việc với dữ liệu để ra quyết định. Hai cái giao nhau ở chỗ cùng dùng dữ liệu, nhưng mục tiêu cuối khác nhau [S8].
Big data là gì — và khi nào dữ liệu được gọi là "lớn"
Big data (dữ liệu lớn) không phải là "nhiều dữ liệu" theo cảm tính, mà là dữ liệu lớn tới mức công cụ thường (Excel, database nhỏ) không xử lý nổi trong thời gian chấp nhận được. Một shop bán hàng online có vài nghìn đơn/tháng thì chưa phải big data; nhưng một sàn thương mại điện tử có vài chục triệu lượt truy cập/ngày, mỗi lượt lại kèm hành vi click, vị trí, thiết bị — thì đó là big data.
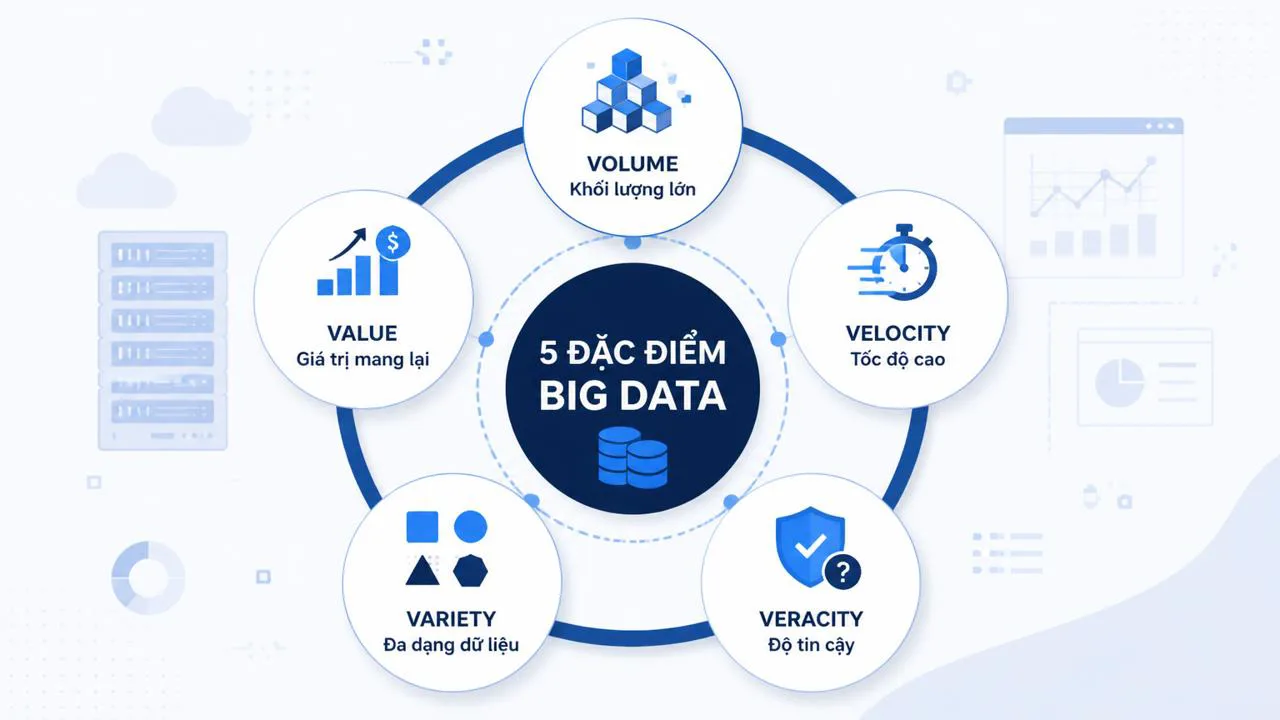
Để nhận diện big data, người ta hay dùng mô hình 5V — năm đặc điểm đi kèm nhau:
- Volume (khối lượng): tính bằng TB, PB trở lên.
- Velocity (tốc độ): dữ liệu sinh ra liên tục theo thời gian thật, ví dụ giao dịch thẻ mỗi giây.
- Variety (đa dạng): vừa có số, vừa có chữ, ảnh, video, log hệ thống.
- Veracity (độ tin cậy): dữ liệu có thể sai, trùng, thiếu — phải đánh giá chất lượng.
- Value (giá trị): dữ liệu chỉ có ý nghĩa khi mình khai thác được thành insight hoặc quyết định.
5V này không phải tự nhiên sinh ra cùng lúc. Ban đầu chỉ có 3V (Volume, Velocity, Variety) do Doug Laney đề xuất từ cuối những năm 1990, sau đó cộng đồng mở rộng thêm Veracity và Value. Khi dùng trong bài viết hay thuyết trình, bạn nên nhắc nguồn gốc này để tránh bị "người am hiểu" hỏi.
Nếu bạn muốn đi tiếp vào phần công cụ xử lý big data như Hadoop hay Spark, bài big data và công cụ Hadoop, Spark sẽ giải thích cụ thể hơn.
Data mining là gì — đào thứ ẩn trong đống dữ liệu
Data mining (khai phá dữ liệu) là quá trình duyệt qua một tập dữ liệu lớn để tìm ra những pattern (mẫu lặp), xu hướng hoặc quy luật mà mắt thường không nhìn ra. Bạn có thể hình dung giống như đãi vàng: cát sỏi là dữ liệu thô, cái mình cần là vàng — những insight có giá trị.
Trong thực tế, data mining thường gồm các bước lặp lại: thu thập dữ liệu, làm sạch (bỏ trùng, bỏ thiếu, chuẩn hóa), phân tích khám phá, áp thuật toán để tìm pattern, rồi kiểm tra lại xem pattern đó có thật sự hữu ích không. Bước làm sạch hay bị xem nhẹ nhất nhưng lại tốn thời gian nhất — nhiều dự án thực tế dành 60–80% thời gian chỉ để sửa dữ liệu [S5].
Một ví dụ dễ hình dung: một hệ thống siêu thị muốn biết khách hay mua bia thì mua kèm gì. Kết quả thuật toán có thể gợi ý "bia + tã em bé" — nghe vô lý nhưng thật, vì các ông bố hay được vợ gửi đi mua cùng lúc. Pattern này sinh ra chiến dịch bày hàng liền kề, tăng doanh thu.
Data mining không phải để tìm câu trả lời đúng, mà để tìm câu hỏi mới mà mình chưa nghĩ tới.
Để xem quy trình chi tiết từng bước, bạn có thể đọc tiếp quy trình data mining 7 bước chi tiết.
Machine learning là gì — máy tự học từ dữ liệu thay vì được lập trình sẵn
Machine learning (học máy) là một nhánh của AI, nơi máy không được lập trình cứng "nếu A thì làm B", mà được cho rất nhiều ví dụ để tự rút ra quy luật [S4]. Ví dụ cổ điển nhất là lọc email spam: thay vì kỹ sư ngồi viết hàng nghìn luật "chữ này là spam, từ kia là spam", người ta cho hệ thống xem hàng triệu email đã được dán nhãn spam/không-spam, để nó tự tìm đặc điểm phân biệt.
Machine learning có ba nhóm chính:
- Supervised learning (học có giám sát): dữ liệu có nhãn sẵn (ảnh mèo/ảnh chó), máy học để dự đoán nhãn cho dữ liệu mới.
- Unsupervised learning (học không giám sát): dữ liệu không nhãn, máy tự phân nhóm hoặc phát hiện bất thường.
- Reinforcement learning (học tăng cường): máy thử hành động, nhận thưởng/phạt, dần tối ưu — giống cách dạy thú cưng.
Trong đời sống, bạn gặp supervised learning mỗi ngày: gợi ý phim trên Netflix, app ngân hàng cảnh báo giao dịch lạ, hay trợ lý ảo nhận diện giọng nói. Tất cả đều được "dạy" từ dữ liệu lịch sử trước khi chạy thật.
Deep learning và neural network — khi máy học theo nhiều lớp
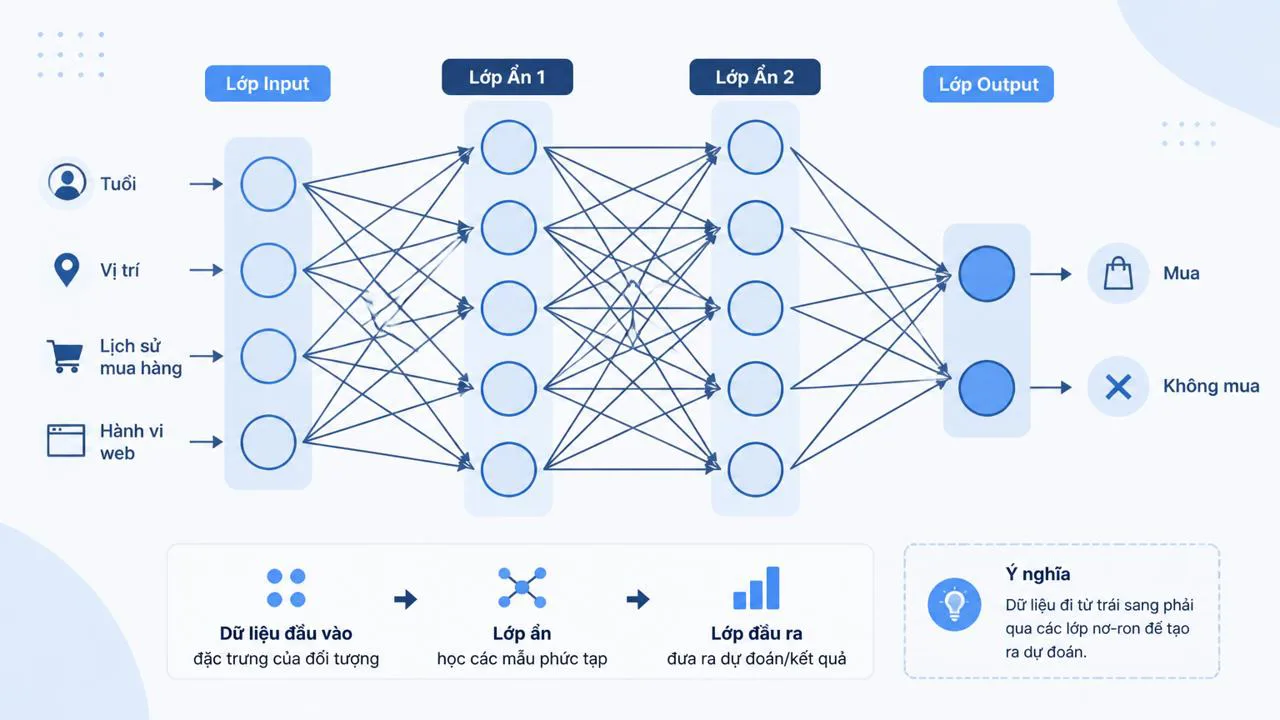
Deep learning (học sâu) là một nhánh của machine learning, dùng mạng nơ-ron nhiều lớp (neural network) để học từ dữ liệu phức tạp như ảnh, giọng nói, ngôn ngữ tự nhiên [S4][S8]. "Sâu" ở đây nghĩa là nhiều lớp xử lý chồng lên nhau, mỗi lớp trích một đặc điểm khác nhau.
Hình dung đơn giản: khi bạn nhìn một bức ảnh mèo, não bạn nhận diện theo nhiều lớp — lớp đầu thấy đường nét, lớp sau ghép thành hình tròn/tam giác, lớp sau nữa nhận ra tai, mắt, ria, rồi lớp cuối kết luận "đây là mèo". Neural network mô phỏng cách học đó: mỗi layer là một lớp trích đặc trưng.
Đặc điểm quan trọng: deep learning cần rất nhiều dữ liệu và năng lực tính toán lớn (GPU) để chạy hiệu quả. Càng nhiều dữ liệu, mô hình càng học được pattern tinh tế — đó là lý do các công ty lớn có lợi thế khi train mô hình ngôn ngữ hay mô hình ảnh quy mô lớn. Khi dữ liệu ít, deep learning thường không tốt hơn mô hình machine learning truyền thống, thậm chí tệ hơn.
Bạn không cần nhớ công thức toán của neural network ở giai đoạn này. Quan trọng là phân biệt được: machine learning là khái niệm cha, deep learning là con, neural network là kiến trúc cốt lõi của deep learning. Nếu muốn đi sâu vào ứng dụng thực tế của deep learning, bài deep learning và neural network ở mức ứng dụng thực tế sẽ giải thích cụ thể hơn.
AI và Data Science khác nhau ở đâu, giao nhau ở chỗ nào
Sau khi đi qua các khái niệm nền, quay lại câu hỏi lớn: AI và data science là gì và khác nhau ra sao? Hai khái niệm này không phải là tập con của nhau — chúng chồng lấn một phần, nhưng mục tiêu và công cụ chính khác nhau [S1][S2][S3][S7].
Để dễ nhớ, bạn có thể hình dung thế này:
- Data science là quy trình từ dữ liệu thô tới insight/phát hiện: thu thập, làm sạch, phân tích thống kê, kể chuyện bằng biểu đồ, hỗ trợ ra quyết định. Đầu ra thường là một báo cáo, dashboard, hoặc khuyến nghị cho con người.
- AI (đặc biệt là AI hiện đại) là xây dựng hệ thống có khả năng "suy luận", "nhận thức", "hành động" — mục tiêu là thay thế hoặc hỗ trợ con người trong một tác vụ cụ thể. Đầu ra là một sản phẩm chạy tự động: chatbot, xe tự lái, hệ thống gợi ý.
Một ví dụ đời thường: bạn làm ở một app ngân hàng. Nhóm data science phân tích lịch sử giao dịch, phát hiện "khách VIP hay chuyển khoản vào 8h sáng ngày 25" và đề xuất chiến dịch remarketing. Nhóm AI thì xây chatbot hỗ trợ khách, hay hệ thống phát hiện giao dịch lạ trong mili-giây để chặn gian lận. Cả hai cùng đụng dữ liệu, nhưng nhóm data science kết thúc ở báo cáo-insight, nhóm AI kết thúc ở sản phẩm tự chạy.
Điểm giao nhau là cả hai đều dùng dữ liệu, đều dùng thống kê và machine learning ở mức nào đó. AI hiện đại gần như không thể làm gì nếu thiếu dữ liệu chất lượng — và data science thì lại hay dùng AI như công cụ phân tích (ví dụ dùng LLM tóm tắt báo cáo). Vì vậy trong nhiều công ty, hai team ngồi chung và làm cho nhau [S7].
| Tiêu chí | Data Science | AI |
|---|---|---|
| Mục tiêu chính | Tìm insight, hỗ trợ quyết định | Xây hệ thống tự động suy luận/hành động |
| Đầu ra điển hình | Báo cáo, dashboard, đề xuất | Sản phẩm chạy tự động (chatbot, hệ gợi ý, mô hình dự đoán) |
| Công cụ lõi | Thống kê, trực quan hóa, SQL, machine learning cơ bản | Machine learning, deep learning, neural network, xử lý ngôn ngữ |
| Câu hỏi thường gặp | "Khách hàng nào sắp rời bỏ?" | "Làm sao để app tự trả lời khách 24/7?" |
Một cách diễn đạt phổ biến mà bạn sẽ gặp: AI là "mái nhà lớn" (bao trùm ML, deep learning, robotics…), còn data science là "nghề thủ công" đi từ dữ liệu tới insight. Hai khái niệm chồng lấn chứ không phải cha-con. Nếu muốn xem khái niệm và quy trình data science tổng quan, đọc thêm khái niệm và quy trình data science tổng quan.
Quy trình từ dữ liệu thô tới insight — và AI nằm ở bước nào
Để thấy rõ vị trí của AI trong toàn bộ quy trình, bạn có thể hình dung một pipeline (dây chuyền) xử lý dữ liệu điển hình gồm sáu bước:
- Thu thập (collect): gom log, giao dịch, khảo sát, dữ liệu từ app/web.
- Tiền xử lý (preprocess): làm sạch, bỏ trùng, chuẩn hóa định dạng, xử lý giá trị thiếu.
- Khai phá (mining): tìm pattern, phân nhóm, phát hiện bất thường.
- Mô hình hóa (model): áp thuật toán machine learning hoặc deep learning để dự đoán/phân loại.
- Triển khai (deploy): đưa mô hình vào sản phẩm thật để phục vụ người dùng.
- Cải thiện (improve): đo lường hiệu quả, thu thêm dữ liệu, train lại mô hình.
Trong sáu bước này, AI (machine learning/deep learning) nằm chính ở bước 4 và góp mặt ở bước 3, 5, 6. Nhưng bước 1 và 2 — thu thập và tiền xử lý — lại là phần "không AI" nhưng lại chiếm phần lớn thời gian và công sức của một dự án thực tế. Đây là lý do nhiều người bắt đầu học data science thường ngạc nhiên: thay vì làm mô hình, hai tháng đầu chỉ sửa dữ liệu.
Nếu bạn muốn xem ứng dụng của data science trong đời sống (gợi ý phim, thiết bị đeo, bản đồ), bài AI và data science trong bối cảnh ứng dụng thực tế sẽ cho bạn vài ví dụ dễ hình dung hơn.
Lỗi thường gặp khi mới bắt đầu — và cách tránh
Khi mới tiếp cận, mọi người hay mắc ba lỗi phổ biến. Ghi nhớ chúng giúp bạn khỏi đi lệch hướng.
Lỗi 1: Gọi nhầm AI cho mọi thứ. Thấy dashboard phân tích khách hàng cũng bảo "dùng AI", thấy chatbot cũng bảo "AI". Thực tế, nhiều hệ thống chỉ là thống kê + rule đơn giản, chưa cần machine learning. Khi nghe "AI", nên hỏi lại: "Phần nào dùng machine learning, phần nào chỉ là rule?"
Lỗi 2: Bỏ qua làm sạch dữ liệu. Nhiều bạn mới thấy mô hình deep learning hấp dẫn nên lao vào train, nhưng dữ liệu chưa được làm sạch. Kết quả mô hình tệ không phải vì thuật toán, mà vì input sai. Làm sạch dữ liệu không hấp dẫn nhưng quyết định 80% chất lượng đầu ra [S5].
Lỗi 3: Dùng deep learning chỗ không cần. Deep learning cần nhiều dữ liệu và GPU. Với bài toán vài nghìn dòng dữ liệu, một mô hình hồi quy (regression) hoặc cây quyết định (decision tree) cho kết quả tốt hơn, chạy nhanh hơn, dễ giải thích hơn. Chỉ chọn deep learning khi dữ liệu lớn và bài toán phức tạp (ảnh, giọng nói, ngôn ngữ).
Nếu bạn đang muốn bắt đầu học bài bản, bài lộ trình học data science cho người mới sẽ giúp bạn đi từng bước. Còn nếu muốn mở rộng vốn từ vựng sang các thuật toán cụ thể (regression, KNN, phân cụm…), tổng hợp thuật ngữ và thuật toán data science cơ bản là điểm khởi đầu tốt.
Tóm lại: 7 ý chốt để nhớ
- AI và data science không phải một — chúng chồng lấn nhưng có mục tiêu và đầu ra khác nhau.
- Big data được nhận diện bằng 5V: Volume, Velocity, Variety, Veracity, Value (5V mở rộng từ 3V ban đầu).
- Data mining là quá trình làm sạch + tìm pattern ẩn trong dữ liệu; bước làm sạch chiếm phần lớn thời gian.
- Machine learning là nhánh của AI, cho máy tự học từ dữ liệu thay vì lập trình cứng.
- Deep learning là nhánh con của machine learning, dùng neural network nhiều lớp để xử lý ảnh/giọng nói/ngôn ngữ.
- Trong quy trình dữ liệu, AI chiếm chính ở bước mô hình hóa và triển khai, còn thu thập + làm sạch chiếm phần lớn công sức.
- Đừng nhảy vào deep learning khi dữ liệu ít; hãy chọn thuật toán theo độ lớn và yêu cầu giải thích của bài toán.
Sau bài này, bạn đã có bộ từ vựng nền để đọc tin tức AI, nghe đồng nghiệp nói chuyện và chọn hướng học tiếp theo mà không cần Google lại từng thuật ngữ. Nếu muốn đào sâu thêm, cụm bài liên kết phía trên sẽ dẫn bạn đi từng bước — từ khái niệm, quy trình, công cụ tới lộ trình học cụ thể.
Tags
- neural network
- lộ trình học data science
- machine learning cơ bản
- thuật toán cho người mới
- big data 5V
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.