Data Science
Model Asset eXchange (MAX) Là Gì: Kho Model Deep Learning Có Sẵn Từ IBM
MAX là kho model deep learning mở của IBM, đóng gói sẵn thành microservice chạy bằng Docker. Bài giải thích MAX là gì, dùng cho ai, microservice chạy ra sao, và cách Docker/Kubernetes giúp triển khai model AI nhanh.
 Phong Nguyen
PNTECH Writer · 19/09/2026
Model Asset eXchange (MAX) là gì và giải quyết nỗi khổ nào của người mới
Bạn muốn có một model AI nhận diện ảnh, đọc văn bản hay dịch giọng nói — nhưng thật lòng mà nói, để train một model deep learning từ đầu bạn cần vài nghìn ảnh được gán nhãn cẩn thận, một cụm GPU đủ mạnh, vài tuần chờ máy chạy, cộng thêm người biết chỉnh tham số. Đó là lý do nhiều bạn sinh viên, marketer, hay người mới vào ngành dữ liệu… bỏ cuộc trước khi kịp thử.
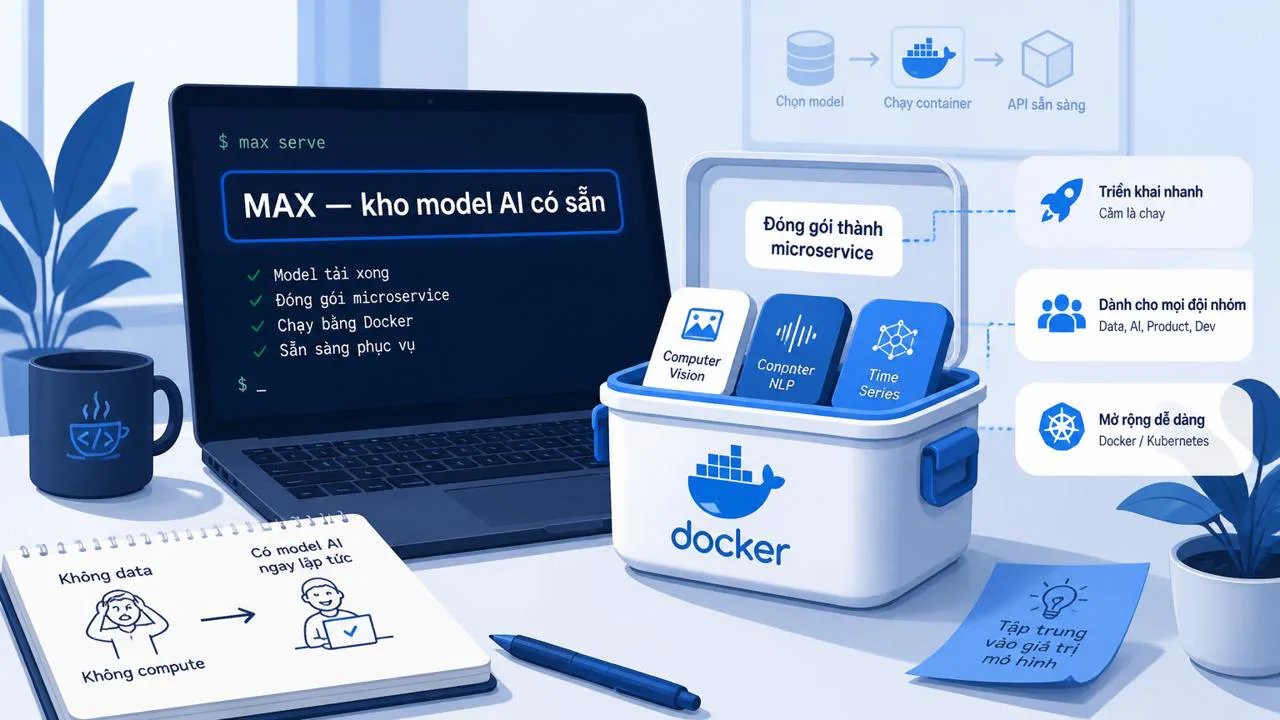
Model Asset eXchange — gọi tắt là MAX — là kho mở của IBM, nơi đã có sẵn hàng chục model deep learning được đóng gói thành các microservice chạy được ngay. Bạn kéo về, chạy bằng một câu lệnh, gửi ảnh hoặc văn bản lên, nhận kết quả về. Không cần data, không cần GPU, không cần biết train. Nếu cần "học" thêm cho bài toán riêng (ví dụ nhận diện sản phẩm của một shop), bạn dùng model làm nền rồi fine-tune — tinh chỉnh — bằng một lượng data nhỏ hơn rất nhiều. Bài viết này đi từ đúng nỗi khổ đó, giải thích MAX là gì, microservice chạy ra sao, và Docker/Kubernetes — hai thứ nghe rất "kỹ thuật" — dùng để làm gì, bằng ví dụ đời thường.
Pre-trained model là gì, và vì sao nó thay đổi cán cân
Một model deep learning là chương trình đã học ra "pattern" từ dữ liệu: cho nó xem triệu tấm ảnh mèo, nó tự rút ra đặc điểm của mèo; cho nó đọc văn bản, nó tự rút ra quy luật ngữ pháp. Để làm được điều đó, model phải trải qua quá trình train — tức là chạy vòng lặp tính toán hàng triệu lần để tinh chỉnh hàng triệu con số bên trong. Train từ đầu tốn data, tốn GPU, tốn thời gian, và cần người biết cài đặt cho đúng.
Pre-trained model — model đã được train sẵn — giống như mua một món ăn nấu xong thay vì tự nấu. Ai đó (IBM, Google, Meta, cộng đồng nghiên cứu…) đã bỏ công train, bạn chỉ việc lấy về dùng. Có hai cách dùng:
- Dùng luôn (inference): gửi input, nhận output, không cần data riêng. Ví dụ model nhận diện vật thể: gửi ảnh, nhận về danh sách "person, car, dog" kèm toạ độ.
- Tinh chỉnh (fine-tune): lấy model làm nền, train thêm vài trăm đến vài nghìn mẫu của bạn để nó "quen" với bài toán riêng. Một shop thời trang muốn model phân biệt áo sơ mi và áo polo không cần train từ đầu — chỉ cần fine-tune từ model phân loại ảnh có sẵn, thời gian tính bằng giờ thay vì tuần.
Khái niệm quan trọng ở đây là time to value — thời gian từ lúc bạn bắt đầu dự án đến khi có kết quả hữu ích. Pre-trained model cắt time to value từ vài tháng xuống vài giờ. Trong thực tế, hầu hết team sản phẩm không có thời gian chờ train từ đầu; họ chọn pre-trained, đo trên data thật, nếu thiếu thì mới fine-tune. MAX sinh ra để phục vụ đúng nhịp làm việc đó.
MAX cung cấp những gì và dùng được cho ai
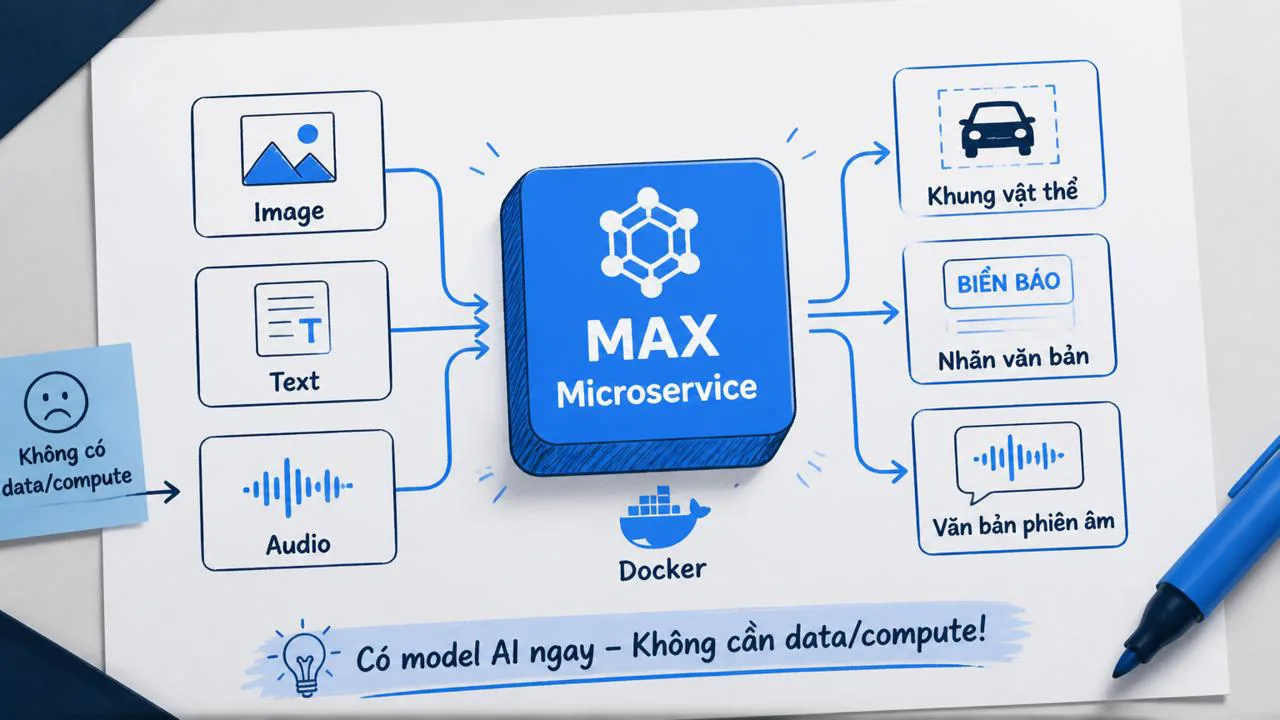
MAX là kho microservice deep learning mở của IBM, mỗi microservice bọc một model đã được kiểm thử. Bạn không cần đụng đến thuật toán bên trong — chỉ cần gọi microservice qua REST API. Danh mục bài toán có sẵn trên MAX bao gồm các nhóm chính:
- Thị giác máy tính: nhận diện vật thể trong ảnh (object detection), phân loại ảnh (image classification), ước lượng tư thế người (human pose estimation), chuyển ảnh thành chữ (image-to-text).
- Xử lý ngôn ngữ: phân loại văn bản (text classification), nhận diện tên riêng (named entity recognition), phân tích cảm xúc, trả lời câu hỏi.
- Âm thanh: chuyển giọng nói thành văn bản (speech-to-text), chuyển văn bản thành giọng nói (text-to-speech), phân loại âm thanh.
Mỗi microservice đi kèm mã nguồn mở và tài liệu cách chạy, đóng gói sẵn thành Docker image để kéo về dùng. Giấy phép mặc định cho phép dùng cá nhân lẫn thương mại, tuy nhiên license cụ thể có thể khác nhau tuỳ model (có model gốc từ bên thứ ba), nên bạn vẫn cần đọc file LICENSE trong repo từng model trước khi đưa vào sản phẩm thương mại.
MAX thuộc nhóm công cụ các nhóm công cụ data science ở mảng "model deployment" — tức là giai đoạn đưa model ra chạy thật, sau khi đã có model ở tay.
Một câu hỏi nhiều bạn đặt ra: MAX còn được IBM duy trì trong giai đoạn 2025–2026 không? Trang IBM Developer từng là nơi host tài liệu MAX và đã trải qua tái cơ cấu; repo mã nguồn và Docker image vẫn xuất hiện trên GitHub và Docker Hub dưới tên tổ chức liên quan đến IBM, nhưng tốc độ cập nhật model mới chậm hơn trước. Trước khi bắt tay vào dự án lớn, nên kiểm tra trực tiếp repo và Docker Hub để xem commit gần nhất cách đây bao lâu, model bạn cần có còn được liệt kê không. Đây là bước "cần verify" mà bất kỳ ai định dùng MAX vào production nên làm.
Microservice là gì, và flow bên trong một microservice MAX
Thuật ngữ microservice nghe phức tạp nhưng ý tưởng rất đời thường: thay vì một chương trình to chứa đủ thứ, bạn tách thành nhiều chương trình nhỏ, mỗi chương trình làm đúng một việc, nói chuyện với nhau qua mạng (gọi là service, phiên bản thu nhỏ là micro). Trong MAX, mỗi model được bọc trong một microservice riêng — "trạm" đón request, xử lý, trả về kết quả.
Một microservice MAX thường có bốn khối chức năng, nối tiếp nhau theo một flow cố định:
- REST API — cửa vào microservice. App khác (web, mobile, script Python) gửi yêu cầu lên đây. REST API là giao thức web phổ biến nhất để hai phần mềm nói chuyện; bạn có thể đọc chi tiết hơn ở bài REST API trong data science.
- Pre-processing — chuẩn bị dữ liệu đầu vào cho vừa "khẩu vị" của model. Ảnh gốc to 4K phải được resize về kích thước model yêu cầu (ví dụ 224×224), chuyển định dạng màu, chuẩn hoá pixel. Văn bản phải tách từ, loại bỏ ký tự thừa.
- Model — bộ não chính, chạy dự đoán. Đây là file nặng nhất (có thể vài trăm MB đến vài GB), chứa toàn bộ tri thức model đã học.
- Post-processing — biến output thô của model thành thứ dễ dùng. Ví dụ model object detection ra hàng trăm khung hình chồng chéo, post-processing lọc bớt, chỉ giữ khung có độ tin cậy cao, vẽ nhãn lên ảnh.
Flow tổng thể: client gửi ảnh qua REST API → microservice nhận → pre-processing → model dự đoán → post-processing → microservice đóng gói thành JSON (chuẩn định dạng web phổ biến, dễ đọc, dễ gửi qua mạng) → trả về client. Client nhận JSON, hiển thị lên web hoặc lưu vào database. Toàn bộ quá trình thường mất từ vài trăm mili-giây đến vài giây, tuỳ độ phức tạp của model và tốc độ mạng.
Tưởng tượng microservice như một quán phở nhỏ: khách gửi yêu cầu qua quầy (REST API), đầu bếp sơ chế nguyên liệu (pre-processing), nấu bằng nồi riêng (model), bày ra tô sạch đẹp (post-processing), rồi mang ra cho khách.
Docker và Kubernetes, giải thích bằng ví dụ đời thường
Để chạy microservice MAX, bạn sẽ gặp hai khái niệm: Docker và Kubernetes. Nếu bạn chưa từng đụng vào, hãy hình dung thế này.
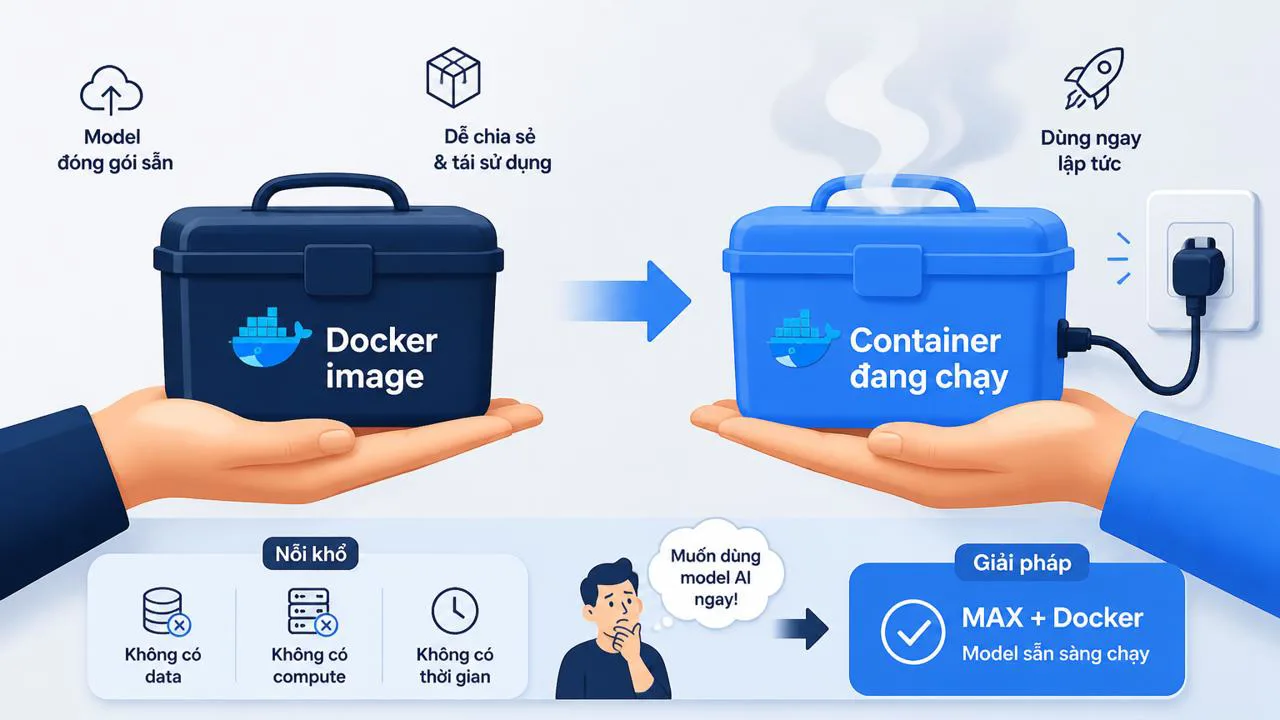
Docker image giống một hộp cơm điện đã đóng gói sẵn: bên trong có đủ cơm, thức ăn, nước chấm, và cả dây cắm. Hộp được niêm phong kín. Bạn mang hộp sang máy Windows, sang Mac, sang server Linux, sang máy bạn, sang máy đồng nghiệp — cắm điện vào là chạy giống nhau. Docker container là hộp cơm đang cắm điện, đang nấu — tức image đã được khởi chạy thành một tiến trình thật trên máy bạn. Một image có thể tạo ra nhiều container chạy song song, mỗi cái là một bản "đang nấu" riêng.
MAX phát hành mỗi microservice dưới dạng Docker image. Bạn kéo image về máy bằng một câu lệnh (docker pull), rồi chạy (docker run) là có ngay microservice trên cổng 8080 hoặc 5000. Không cần cài Python, không cần cài thư viện, không sợ xung đột môi trường — mọi thứ đã nằm gọn trong hộp.
Kubernetes là người quản lý nhiều hộp cơm điện cùng lúc. Khi bạn chạy một microservice cho vài chục người dùng, một container là đủ. Nhưng khi traffic lên vài nghìn người, bạn cần nhiều container chạy song song, có cái hỏng phải thay, có cái quá tải phải chuyển bớt request. Kubernetes làm đúng việc đó: tự thêm container khi tải tăng, tự giảm khi tải giảm, tự thay container hỏng, tự phân phối request đều. Nó là "hệ điều hành" cho hàng trăm, hàng nghìn container.
Red Hat OpenShift về bản chất là Kubernetes, nhưng có thêm lớp giao diện web, công cụ bảo mật doanh nghiệp, tích hợp CI/CD, và hỗ trợ kỹ thuật từ Red Hat. Nếu Kubernetes là động cơ xe, OpenShift là cả chiếc xe lắp sẵn, có bảng điều khiển, có dây an toàn. OpenShift chạy được trên IBM Cloud, AWS, GCP, Azure và cả on-premise (server đặt tại chỗ). MAX trên OpenShift là một tổ hợp phổ biến trong tài liệu IBM, thuộc nhóm cloud-based tools cho data science.
Quy trình tạo ra một microservice MAX từ đầu
Nếu bạn không chỉ dùng model có sẵn mà muốn đóng góp một microservice mới cho MAX — hoặc muốn hiểu để tự bọc model riêng — quy trình chung gồm năm bước.
Bước 1 — Thu thập và chuẩn bị dữ liệu. Chạy model trên một cụm máy có GPU, kiểm tra dữ liệu có đủ đa dạng không, gán nhãn có nhất quán không. Đây là bước tốn thời gian nhất trong thực tế, nhưng nếu đã có pre-trained model thì bạn chỉ cần vài trăm đến vài nghìn mẫu để fine-tune.
Bước 2 — Nghiên cứu, đánh giá, train, kiểm thử. Vòng lặp: thử cấu hình A, đo kết quả trên tập validation, tinh chỉnh, lặp lại. Khi kết quả đạt ngưỡng chấp nhận được thì chốt model.
Bước 3 — Bọc model trong microservice. Viết code pre-processing (xử lý input trước khi đưa vào model), gọi model dự đoán, viết code post-processing (biến output thô thành kết quả sạch), bọc tất cả trong REST API. Thư viện Flask hoặc FastAPI của Python rất phổ biến cho việc này.
Bước 4 — Đóng gói Docker image. Viết Dockerfile — file hướng dẫn Docker cách đóng gói microservice kèm mọi thứ nó cần (Python, thư viện, model file). Test image bằng cách chạy container local, gửi request mẫu, kiểm tra response.
Bước 5 — Viết tài liệu và đẩy lên GitHub. Tài liệu cần nêu rõ input/output, ví dụ gọi API bằng curl hoặc Python, license, giới hạn. Khi đã public, người khác chỉ cần docker pull là dùng được.
Ba tình huống thực tế để hình dung
Tình huống A — Nhận diện vật thể trong ảnh. Một bạn marketer upload tấm ảnh sự kiện công ty lên microservice object detection. Microservice trả về JSON với danh sách vật thể kèm toạ độ: { "person": 12, "chair": 8, "table": 4 } kèm các khung hình chữ nhật. Bạn dùng số liệu này để báo cáo "sự kiện có 12 người tham dự" mà không cần đếm tay.
Tình huống B — Triển khai text classification lên OpenShift. Một startup cần phân loại email khách hàng thành "khiếu nại", "hỏi thông tin", "khen". Họ lấy microservice text classification từ MAX, đẩy Docker image lên OpenShift cluster (cụm máy chủ chạy Kubernetes do OpenShift quản lý) trên IBM Cloud. Khi lượng email tăng đột biến cuối tuần, Kubernetes tự thêm container để xử lý, không cần ai can thiệp.
Tình huống C — Fine-tune model cho shop online. Một shop bán giày muốn model tự gắn nhãn sản phẩm mới: "sneaker", "boot", "sandal". Họ lấy model phân loại ảnh từ MAX, chuẩn bị khoảng 500–1000 ảnh giày của shop, fine-tune thêm vài giờ trên một máy có GPU thuê (Google Colab, AWS SageMaker, hoặc máy local). Kết quả: model phân loại đúng các kiểu giày riêng của shop, thời gian từ ý tưởng đến sản phẩm chạy được tính bằng ngày, không phải tháng. Lưu ý: data shop phải đủ đa dạng (nhiều góc chụp, nhiều nền, đủ sáng/tối), nếu không model sẽ "học" cả nền chứ không học giày.
Lỗi phổ biến khi mới dùng MAX và pre-trained model
Từ các tình huống trên và phản hồi thường gặp từ người mới, có năm lỗi lặp đi lặp lại:
- Tưởng pre-trained là "xong xuôi", không cần fine-tune. Model pre-trained được train trên data tổng quát (ảnh Internet chẳng hạn). Bài toán riêng của bạn có thể khác đặc điểm, nên đừng ngạc nhiên khi kết quả chưa đạt. Đo trên data thật trước, nếu sai nhiều thì mới fine-tune.
- Bỏ qua pre-processing. Gửi nguyên ảnh 4K vào model yêu cầu 224×224, model vẫn "chạy" nhưng cho output rác. Luôn đọc kỹ input mẫu trong tài liệu microservice.
- Nhầm model với microservice. Model là "bộ não", microservice là cả "trạm" đón khách. Nếu chỉ tải file model về mà không bọc microservice, bạn phải tự viết pre/post-processing và REST API — mất thời gian gấp nhiều lần so với dùng image có sẵn.
- Không đọc license khi dùng thương mại. Phần lớn MAX là Apache 2.0 — dùng thoải mái — nhưng model gốc có thể kèm license riêng. Luôn kiểm tra trước khi đưa vào sản phẩm bán ra.
- Train từ đầu khi MAX đã có sẵn model tốt. Nếu bài toán của bạn nằm trong danh mục MAX hỗ trợ (phân loại ảnh, nhận diện vật thể, NER…), hãy thử pre-trained trước. Train từ đầu chỉ nên làm khi không có lựa chọn nào khác hoặc bài toán quá đặc thù.
Tổng kết và việc nên làm tiếp
Tóm lại bảy ý chính của bài:
- Pre-trained model giúp bạn có AI chạy được trong vài giờ thay vì vài tháng.
- MAX là kho microservice deep learning mở của IBM, có sẵn nhiều bài toán thị giác, ngôn ngữ và âm thanh.
- Mỗi microservice MAX chạy theo flow: REST API → pre-processing → model → post-processing → trả JSON.
- Docker image giống hộp cơm điện đóng gói sẵn, container là hộp đang cắm điện chạy.
- Kubernetes tự quản lý hàng trăm container; OpenShift là Kubernetes có thêm công cụ doanh nghiệp.
- Fine-tune một model pre-trained cho bài toán riêng tốn ít data và thời gian hơn rất nhiều so với train từ đầu.
- Đọc license, đọc tài liệu input/output, và đo trên data thật trước khi đưa vào production.
Nếu bạn mới bắt đầu, việc nên làm ngay hôm nay: vào trang MAX trên GitHub hoặc Docker Hub, chọn một model trong danh sách (object detection là dễ thử nhất), kéo Docker image về máy bằng docker pull, chạy bằng docker run, gửi một tấm ảnh thử qua curl hoặc script Python, xem JSON trả về. Toàn bộ quá trình mất khoảng 15–30 phút nếu máy bạn đã cài Docker. Khi đã quen, hãy đọc thêm các bài liên quan trong chuỗi data science của PN Tech: các nhóm công cụ data science để biết MAX nằm ở đâu trong bức tranh lớn, công cụ thương mại trong data science để so sánh khi nào dùng mở, khi nào cần trả phí, cloud-based tools cho data science để hiểu thêm về OpenShift và các nền tảng cloud, REST API trong data science để nắm chắc cách microservice nói chuyện với app khác, và deep learning cơ bản nếu bạn muốn đào sâu hơn về model bên trong microservice.
Tags
- Docker
- fine-tune
- deep learning
- pre-trained model
- microservice
- Model Asset eXchange
- MAX IBM
- OpenShift
- AI cho người mới
- Kubernetes
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.