Data Science
Data Understanding Trong Data Science: Đọc Kỹ Dữ Liệu Trước Khi Chạy Mô Hình
Data Understanding là giai đoạn bạn dừng lại kiểm tra dữ liệu thô có trung thực với bài toán không, trước khi chạy mô hình. Bài hướng dẫn 3 góc nhìn (đơn biến, tương quan cặp, phân phối), 4 vấn đề chất lượng thường gặp và quy trình 4 bước áp dụng ngay.
 Phong Nguyen
PNTECH Writer · 22/09/2026
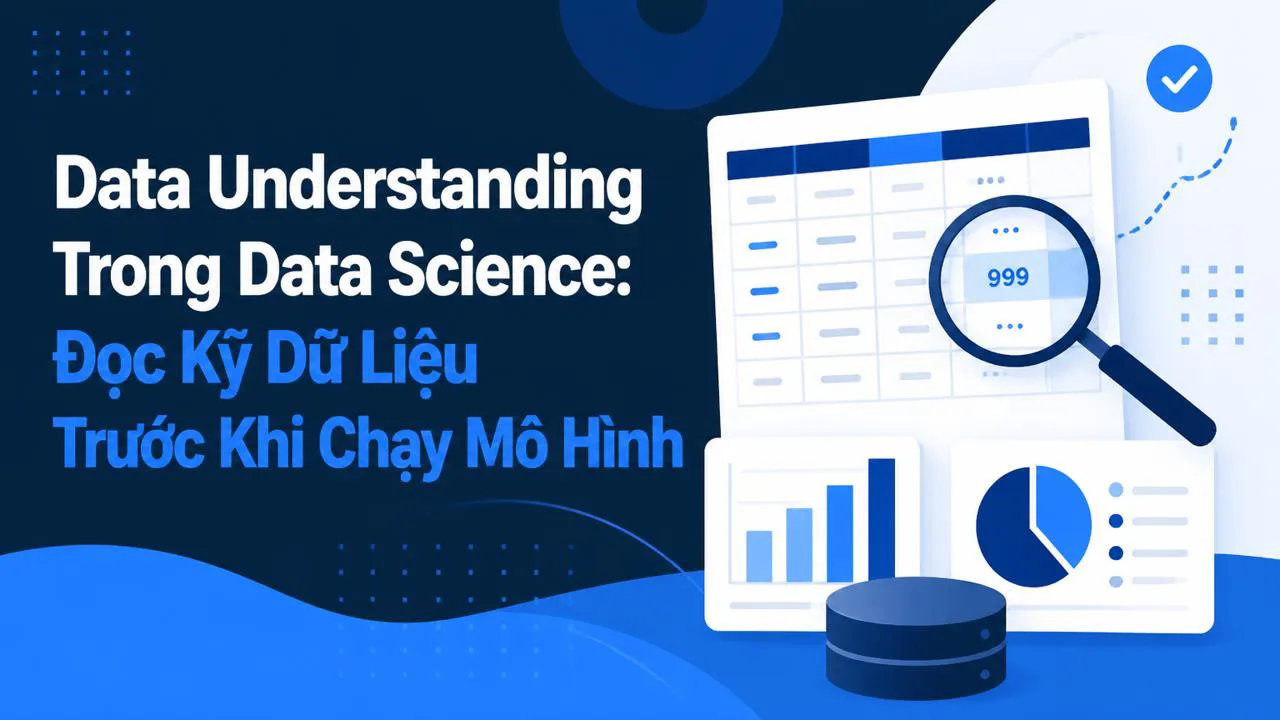
Hiểu dữ liệu trước khi chạy mô hình — vì sao bước này quyết định bạn có đi đúng hướng
Bạn đã có dữ liệu thô trong tay, và phản xạ tự nhiên là mở notebook, chọn thuật toán, chạy thử. Nhưng nếu dữ liệu đó không thật sự đại diện cho bài toán đang giải — ví dụ cột "tuổi" có người ghi 999, cột "chẩn đoán" chỉ ghi một loại trong khi thực tế có nhiều — thì mọi mô hình đẹp đẽ phía sau đều xây trên cát. Data Understanding trong data science chính là lúc bạn dừng lại, đối thoại với dữ liệu để xem nó có đang kể đúng câu chuyện của vấn đề hay không.
Nói ngắn gọn: bước này trả lời câu hỏi "dữ liệu tôi có đủ tin cậy để đi tiếp không, hay phải quay lại thu thập?". Đó là lý do giai đoạn hiểu dữ liệu được đặt làm cầu nối giữa lúc bạn hiểu bài toán và lúc bạn chuẩn bị dữ liệu — nó quyết định bạn đi thẳng hay phải lùi. Nếu bạn chưa nắm vị trí của nó trong toàn bộ quy trình, hãy xem lại bản đồ 10 giai đoạn của Data Science Methodology để thấy bức tranh lớn hơn.
Data Understanding là gì và nó nằm ở đâu trong dòng chảy
Trong Data Science Methodology mà John Rollins (IBM) tổng hợp, Data Understanding là giai đoạn bạn cầm tờ dữ liệu thô vừa thu thập được lên và đặt nó cạnh định nghĩa bài toán đã chốt ở bước trước. Mục tiêu lớn không phải là "xem dữ liệu có gì" mà là "kiểm tra dữ liệu có trung thực với vấn đề không". Hai việc này nghe giống nhau nhưng khác nhau: xem là quan sát bề mặt, còn kiểm tra là đặt câu hỏi xem dữ liệu có bịa, thiếu, hay hiểu lầm vấn đề hay không.
Vì sao đây là cầu nối quan trọng? Sau khi bạn đọc lại bài về Business Understanding để nắm bước đi trước đó, bạn sẽ thấy bước hiểu bài toán cho bạn câu hỏi đúng, còn bước hiểu dữ liệu cho bạn câu trả lời: dữ liệu này có trả lời được câu hỏi đó không. Nếu câu trả lời là không, bạn quay lại bước thu thập — tham khảo cách thu thập dữ liệu theo vòng lặp để biết vì sao thu thập cũng là quá trình lặp, không phải làm một lần rồi xong. Nếu câu trả lời là có, bạn đủ tự tin để sang bước kế tiếp.
Hiểu dữ liệu là lúc bạn đối thoại với nó để xem nó có kể đúng câu chuyện của vấn đề hay không — không phải lúc bạn "xem" nó.
Ba góc nhìn cốt lõi khi đọc dữ liệu
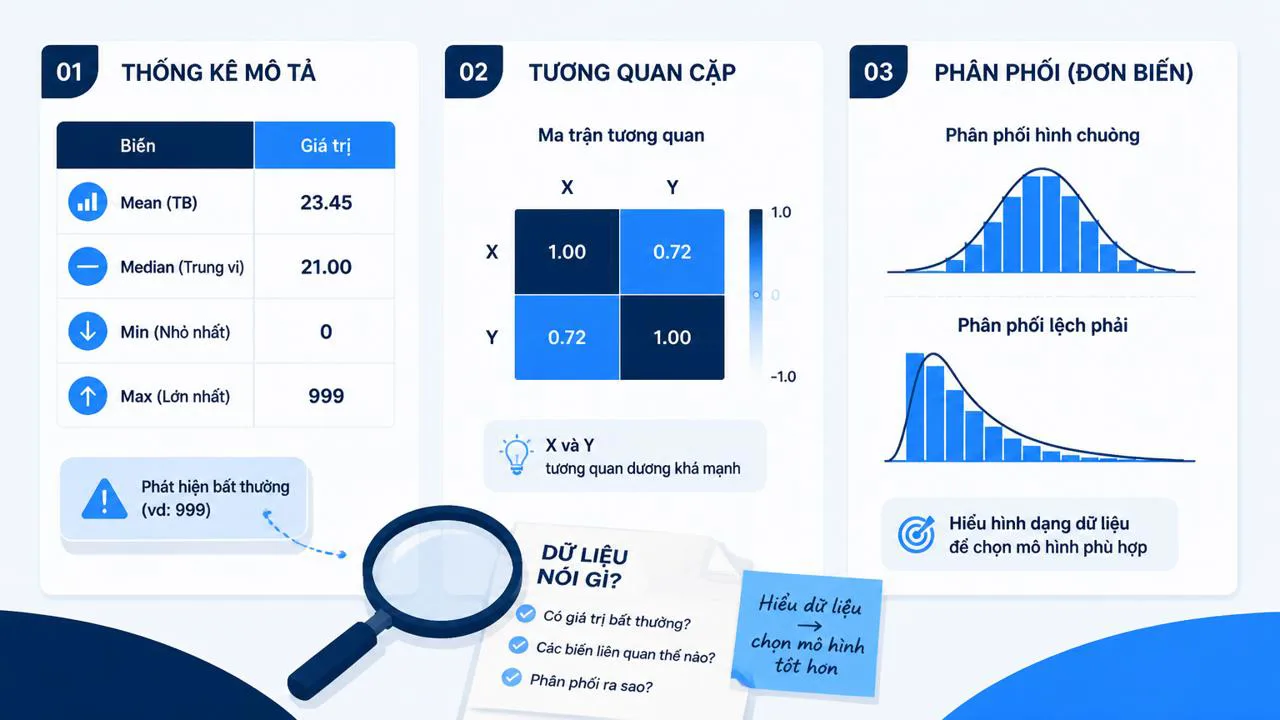
Một dataset có thể được "đọc" theo nhiều góc, nhưng với người mới, ba góc sau đủ để nắm phần lớn tình hình: nhìn từng cột một, nhìn cặp cột với nhau, và nhìn hình dạng phân phối của dữ liệu. Cả ba cùng phục vụ một mục tiêu: biết dữ liệu đang nói gì và nó có hợp lý không.
Thống kê đơn biến — nhìn từng cột một lần
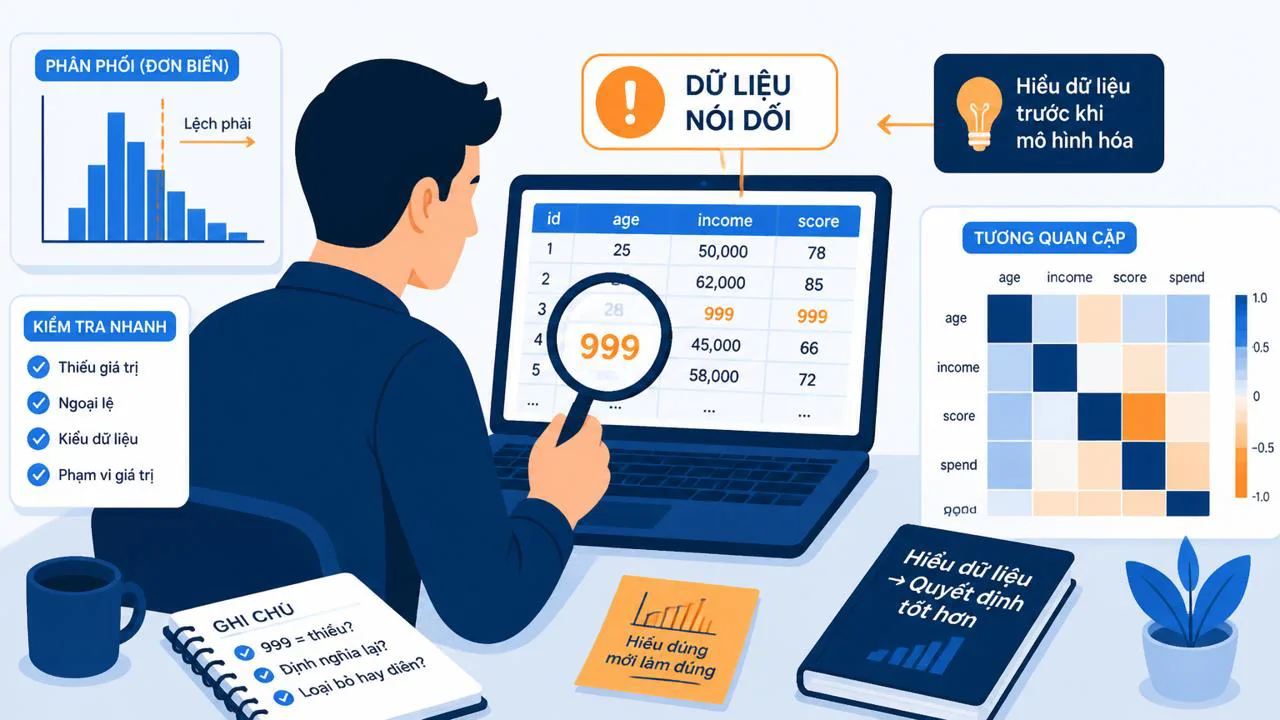
Thống kê đơn biến (univariate statistics) là cách mô tả từng cột riêng lẻ bằng vài con số tóm tắt. Với cột số, bạn cần biết giá trị nhỏ nhất (min), lớn nhất (max), trung bình cộng (mean — tổng chia số lượng), trung vị (median — giá trị ở giữa khi sắp xếp), và độ lệch chuẩn (std — đo mức độ các giá trị chệch khỏi trung bình). Với cột chữ — ví dụ giới tính, thành phố — bạn đếm tần suất mỗi loại xuất hiện bao nhiêu lần.
Ví dụ quen thuộc: bạn có cột "tuổi khách hàng", chạy thống kê ra min = 0 và max = 999. Người mới sẽ nghĩ "có khách hàng 999 tuổi à?" — không, rất có thể 999 là mã hệ thống dùng để đánh dấu "không rõ tuổi" mà người nhập liệu quên không sửa. Đây là lúc thống kê mô tả trong data science phát huy tác dụng: nó không cho bạn biết vì sao có giá trị lạ, nhưng nó chỉ ra giá trị lạ đang nằm ở đâu.
Tương quan cặp — nhìn hai biến cùng lúc
Tương quan cặp là gì? Là cách đo xem hai biến có di chuyển cùng chiều hay ngược chiều không — ví dụ "nhiệt độ cao" và "số ly nước bán ra" có tăng cùng nhau không. Hệ số tương quan (correlation) nằm trong khoảng -1 đến 1: gần 1 nghĩa là cùng tăng cùng giảm, gần -1 nghĩa là một tăng một giảm, gần 0 nghĩa là không liên quan rõ ràng.
Vì sao phải quan tâm? Nếu hai biến gần như nói cùng một điều (tương quan rất cao, ví dụ 0.95), bạn chỉ cần giữ một — vì giữ cả hai vừa thừa, vừa khiến một số mô hình bị "bội tín hiệu" và đánh giá sai tầm quan trọng của biến. Ngược lại, hai biến tương quan thấp có thể đang mang hai mảnh thông tin khác nhau, bạn giữ lại cả hai.
Phân phối dữ liệu — nhìn hình dạng
Phân phối dữ liệu histogram là biểu đồ cột đếm xem mỗi khoảng giá trị có bao nhiêu quan sát rơi vào. Ví dụ với cột "tuổi", bạn sẽ thấy cột nào cao ở khoảng 20–30 tuổi, cột nào thấp ở khoảng 60+. Hình dạng này cho bạn biết dữ liệu có lệch trái, lệch phải, có hai đỉnh (gợi ý hai nhóm khách hàng trộn lẫn), hay có một cột đứng riêng ở rìa (gợi ý outlier).
Biết hình dạng phân phối quan trọng vì nhiều mô hình (ví dụ hồi quy tuyến tính) hoạt động tốt nhất khi dữ liệu có phân phối gần chuẩn (hình chuông). Nếu dữ liệu lệch mạnh, bạn cần cân nhắc biến đổi nó (như lấy log) trước khi đưa vào mô hình — đây là việc thuộc bước tiền xử lý, không phải bước hiểu dữ liệu.
Bốn vấn đề chất lượng dữ liệu thường gặp
Đây là phần thực chiến nhất của bước hiểu dữ liệu: bạn cần chủ động tìm các vấn đề trước khi nó "phản bội" bạn ở bước mô hình. Kiểm tra chất lượng dữ liệu tập trung vào bốn nhóm vấn đề sau.
Thứ nhất, giá trị thiếu (missing value). Dữ liệu có thể thiếu ô trống, hoặc thiếu kiểu ngầm (999, -1, "N/A", "không rõ"). Mỗi loại cần cách xử lý khác nhau, và đặc biệt: missing không phải lúc nào cũng có nghĩa là "không biết". Trong bảng khảo sát, "không trả lời" có thể nghĩa là người đó từ chối, hoặc họ không có ý kiến, hoặc câu hỏi không áp dụng cho họ. Ba nghĩa này cần ba cách xử lý khác nhau.
Thứ hai, giá trị ngoại lai (outlier). Là điểm dữ liệu lệch quá xa so với phần còn lại. Một khách hàng chi 500 triệu trong khi phần lớn chi 1–2 triệu có thể là outlier. Outlier có khi là lỗi nhập liệu, có khi là tín hiệu thật cần giữ, có khi là điểm bất thường cần loại. Bước hiểu dữ liệu không quyết định xử lý — bước đó chỉ phát hiện và đánh dấu.
Thứ ba, mã đặc biệt ẩn nghĩa. 999, -1, 0 — mỗi mã có thể mang một ý nghĩa riêng mà người nhập liệu biết nhưng người phân tích không biết. Đây là lý do bạn cần người hiểu dữ liệu ngồi cùng người hiểu quy trình tạo ra dữ liệu — gọi là data dictionary (từ điển dữ liệu, nói rõ mỗi cột nghĩa là gì và các mã đặc biệt mang ý nghĩa nào).
Thứ tư, đơn vị và cách mã hóa không nhất quán. Một cột "doanh thu" có thể có dòng ghi USD, dòng ghi VND, dòng ghi triệu VND mà không có cột đơn vị đi kèm. Một cột "ngày" có thể lẫn lộn giữa định dạng dd/mm/yyyy và mm/dd/yyyy. Đây là loại vấn đề mà thống kê đơn biến sẽ phát hiện qua việc min/max bất thường, còn phân phối sẽ phát hiện qua việc thấy hai cụm rời rạc bất thường.
Quy trình bốn bước khi hiểu dữ liệu
Để áp dụng được ngay, bạn có thể đi theo trình tự bốn bước. Mỗi bước có một câu hỏi rõ ràng và một đầu ra cụ thể để bạn kiểm tra chéo.
Bước 1 — Chạy thống kê mô tả cho mọi cột. Câu hỏi: cột nào có min/max bất thường, cột nào có tỷ lệ thiếu cao? Đầu ra: bảng tóm tắt kèm danh sách cột cần điều tra thêm.
Bước 2 — Tính tương quan cặp giữa các biến số. Câu hỏi: cặp biến nào gần như nói cùng điều (tương quan rất cao)? Đầu ra: danh sách cặp biến trùng lặp cần chọn một.
Bước 3 — Vẽ biểu đồ phân phối cho từng biến. Câu hỏi: biến nào có hình dạng lệch mạnh, biến nào có hai cụm rời nhau, biến nào có cột đứng riêng ở rìa? Đầu ra: danh sách biến cần biến đổi hoặc điều tra outlier.
Bước 4 — Đánh giá chất lượng dữ liệu tổng thể. Câu hỏi: dữ liệu có đủ sạch để đi tiếp, hay cần quay lại thu thập/sửa định nghĩa? Đầu ra: quyết định "đi tiếp" hoặc "lùi một bước", kèm lý do cụ thể.
Bước hiểu dữ liệu không phải lúc xử lý dữ liệu — nó là lúc đối thoại để quyết định dữ liệu có đáng tin để xử lý hay không.
Khi nào cần quay lại bước trước
Data Science Methodology mang tính vòng lặp (iterative), không phải đường thẳng một chiều. Bước hiểu dữ liệu có thể phát hiện ra rằng định nghĩa bài toán ban đầu chưa đúng — lúc đó bạn phải quay lại bước Business Understanding để sửa câu hỏi, hoặc quay lại bước Data Collection để bổ sung nguồn.
Ví dụ: bạn định dự đoán "khách hàng rời bỏ dịch vụ" trong tháng tới, nhưng khi xem dữ liệu, bạn thấy chỉ có nhãn "đã hủy" mà không có nhãn "còn hoạt động" cho những người âm thầm không dùng. Lúc này dữ liệu không đủ để trả lời câu hỏi — bạn phải quay lại thu thập hoặc định nghĩa lại "rời bỏ" là gì (chỉ hủy tài khoản, hay cả không dùng trong 90 ngày?). Đó là lý do vòng lặp tồn tại — nó giúp bạn không mắc kẹt với một định nghĩa sai ngay từ đầu.
Ví dụ thực tế: bài toán nhập viện do suy tim sung huyết
Đây là case study kinh điển trong tài liệu IBM về Data Science Methodology. Một bệnh viện muốn dự đoán bệnh nhân nào sẽ tái nhập viện vì suy tim sung huyết (một bệnh tim mạch nghiêm trọng, dịch tích tụ trong phổi và tim).
Ban đầu, nhóm phân tích định lấy cột "chẩn đoán chính" làm đặc trưng — tức lý do chính khiến bệnh nhân nhập viện. Khi hiểu dữ liệu, họ phát hiện: rất nhiều ca suy tim sung huyết thật sự lại được ghi dưới chẩn đoán chính là bệnh khác (viêm phổi, khó thở, phù phổi), chỉ khi đọc đến chẩn đoán thứ cấp (lý do phụ kèm theo) hoặc tam cấp (lý do phụ thứ ba) mới thấy ghi nhận suy tim. Nếu chỉ dựa vào chẩn đoán chính, mô hình sẽ bỏ sót một lượng lớn ca thật — và hậu quả là dự đoán sai, can thiệp sai.
Phát hiện này buộc nhóm phải quay lại bước thu thập: mở rộng định nghĩa "ca suy tim sung huyết" không chỉ dựa vào chẩn đoán chính, mà còn cả chẩn đoán thứ cấp và tam cấp. Đây chính là ví dụ điển hình cho việc bước hiểu dữ liệu kéo bạn quay lại sửa định nghĩa vấn đề, chứ không phải cứ đi thẳng một mạch.
Những sai lầm thường gặp của người mới
Sai lầm phổ biến nhất là nhảy thẳng vào mô hình — mở dữ liệu ra, gọi hàm train_test_split, chạy thuật toán, đánh giá điểm số. Điểm số có thể đẹp, nhưng nếu dữ liệu đầu vào đã lỗi thì điểm số chỉ là ảo tưởng. Bước hiểu dữ liệu giúp bạn phát hiện ảo tưởng đó trước khi tốn hàng giờ tinh chỉnh mô hình.
Sai lầm thứ hai là giữ hết các biến có tương quan cao vì "phòng khi cần". Hai biến gần như nói cùng điều không chỉ thừa, mà còn khiến một số mô hình gặp vấn đề đa cộng tuyến (multicollinearity — các biến đầu vào phụ thuộc lẫn nhau, khiến mô hình khó xác định biến nào thật sự quan trọng).
Sai lầm thứ ba là bỏ qua mã đặc biệt như 999. Nếu không biết 999 nghĩa là "không rõ", bạn có thể vô tình lấy trung bình tuổi khách hàng và bị kéo lệch bởi những giá trị 999 này. Hậu quả: mọi phân tích tuổi sau đó đều sai.
Sai lầm thứ tư là tin rằng định nghĩa bài toán ban đầu là đúng tuyệt đối. Ví dụ bệnh viện ở trên cho thấy định nghĩa "chẩn đoán chính = suy tim sung huyết" là chưa đủ — phải mở rộng. Nếu không lặp lại bước hiểu dữ liệu, bạn sẽ không bao giờ phát hiện ra định nghĩa thiếu.
Thuật ngữ nên nắm
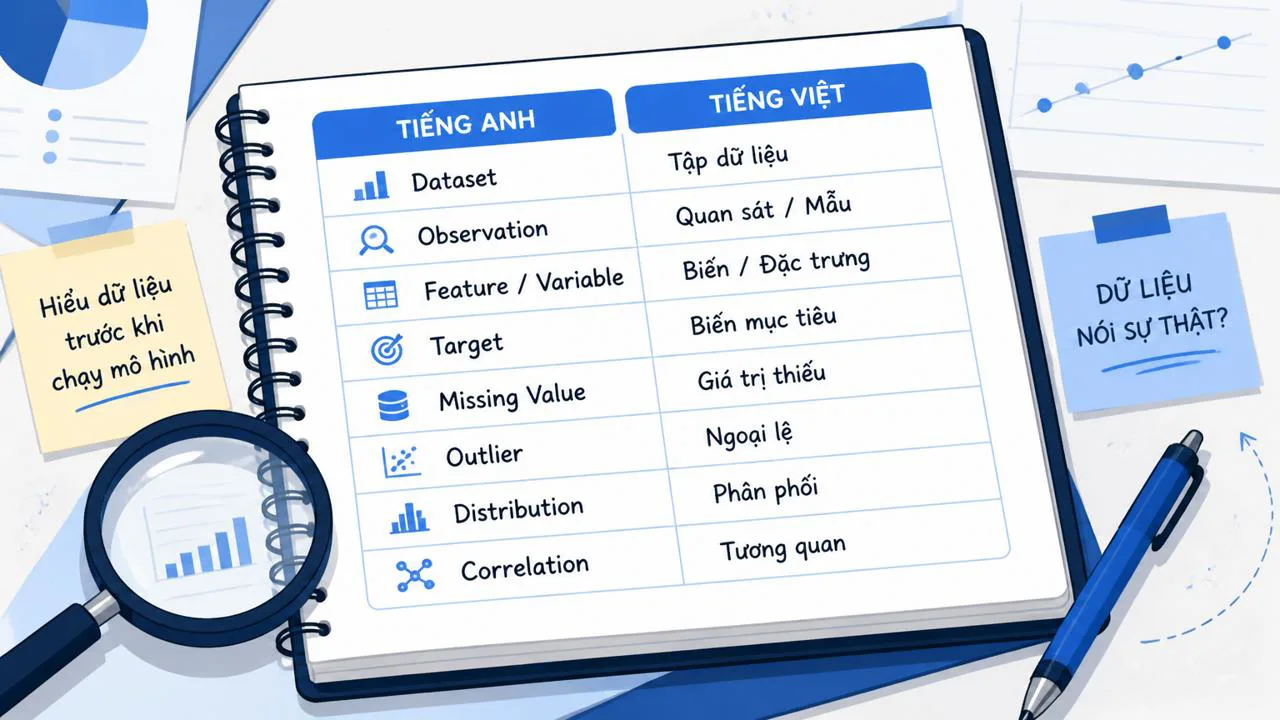
Vì đây là giai đoạn chuyên sâu, bảng dưới tóm tắt các thuật ngữ tiếng Anh bạn sẽ gặp trong tài liệu, kèm nghĩa tiếng Việt và giải thích ngắn để tra cứu nhanh.
| Tiếng Anh | Tiếng Việt | Giải thích ngắn |
|---|---|---|
| Variable | Biến | Một cột dữ liệu, ví dụ "tuổi", "giới tính", "doanh thu tháng" |
| Univariate statistics | Thống kê đơn biến | Mô tả một biến bằng các con số tóm tắt: min, max, mean, median, std |
| Pairwise correlation | Tương quan cặp | Đo mức độ hai biến di chuyển cùng chiều hoặc ngược chiều, trị số -1 đến 1 |
| Distribution | Phân phối | Hình dạng tần suất của biến, thường vẽ bằng histogram |
| Categorical variable | Biến phân loại | Biến dạng nhóm/chữ, ví dụ giới tính, thành phố, loại sản phẩm |
| Missing value | Giá trị thiếu | Ô dữ liệu không có hoặc được ghi mã đặc biệt để nói "không có" |
| Data quality | Chất lượng dữ liệu | Mức độ dữ liệu đáng tin, đầy đủ, nhất quán để dùng cho phân tích |
| Iterative methodology | Phương pháp lặp | Cách làm theo vòng lặp: phát hiện vấn đề thì quay lại bước trước sửa, không đi thẳng một mạch |
Sau khi hiểu dữ liệu thì đi đâu tiếp
Nếu dữ liệu đủ tin cậy, bạn sang bước tiền xử lý — đây là nơi bạn xử lý missing value, mã 999, đơn vị đo lẫn lộn, biến đổi phân phối lệch, mã hóa biến phân loại. Bước này bài tiền xử lý dữ liệu để biết cách xử lý giá trị thiếu và mã đặc biệt sẽ đi sâu hơn vào phần xử lý — trong khi bài bạn đang đọc chỉ dừng ở mức phát hiện và đánh dấu.
Nếu dữ liệu chưa đủ tin cậy, bạn quay lại bước thu thập hoặc sửa định nghĩa bài toán. Đây không phải lùi mà là tiến — vì bạn đang tiết kiệm hàng giờ làm việc sai hướng.
Bảy điểm cần nhớ
Data Understanding trong data science là giai đoạn bạn đối thoại với dữ liệu để xem nó có kể đúng câu chuyện của bài toán hay không. Ba góc nhìn cốt lõi là thống kê đơn biến, tương quan cặp và biểu đồ phân phối — cùng phục vụ mục tiêu biết dữ liệu đang nói gì. Bốn vấn đề chất lượng thường gặp là missing value, outlier, mã đặc biệt (999), và đơn vị/mã hóa không nhất quán. Quy trình bốn bước để áp dụng ngay là: thống kê mô tả, tương quan cặp, vẽ histogram, đánh giá chất lượng tổng thể. Bước này mang tính lặp — phát hiện định nghĩa sai thì quay lại bước trước để sửa. Ví dụ bệnh viện cho thấy chỉ dựa vào chẩn đoán chính sẽ bỏ sót ca suy tim sung huyết thật. Sai lầm phổ biến là nhảy th
Tags
- chất lượng dữ liệu
- data understanding
- tiền xử lý
- data dictionary
- data science methodology
- outlier
- data science
- thống kê mô tả
- tương quan
- phân phối dữ liệu
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.