Data Science
Data Sets Là Gì Trong Data Science: Cấu Trúc, Nguồn Mở Và Giấy Phép CDLA
Data set là tập dữ liệu có cấu trúc, là nguyên liệu đầu vào của mọi dự án data science. Bài phân tích 4 dạng cấu trúc phổ biến, nguồn open data cho người mới, và cách đọc giấy phép CDLA để tránh nhầm lẫn giữa quyền dùng data và quyền dùng mô hình tạo ra từ data.
 Phong Nguyen
PNTECH Writer · 18/09/2026
Data set là nguyên liệu đầu vào của mọi dự án data science
Một dự án data science có thể có mô hình rất hay, nhưng nếu dữ liệu đầu vào sai hoặc không phù hợp thì kết quả cũng vô nghĩa. Bài viết này giải thích data set là gì trong data science theo cách đời thường: nó là gì, có mấy dạng cấu trúc, lấy ở đâu, và đặc biệt là dùng có thoải mái hay bị giới hạn bởi giấy phép — phần mà người mới hay bỏ qua.
Nếu bạn đang bắt đầu làm quen với data science là gì và quy trình tổng thể thì hiểu data set là bước nền đầu tiên. Còn nếu đang xây lộ trình học, có thể xem thêm lộ trình học data science cho người mới bắt đầu để biết data set nằm ở khâu nào.
Data set là "cái hộp có tổ chức" chứa dữ liệu — chọn đúng hộp thì cả dự án đi đúng hướng, chọn sai thì dù thuật toán có tốt cũng khó ra kết quả tốt.
Data set là gì, khác gì với "data"?
Data là từng thông tin rời rạc: một con số nhiệt độ, một bức ảnh, một dòng log trên web. Data set là tập hợp nhiều data được gom lại theo một cấu trúc nhất định để có thể mở ra xem, phân tích hoặc đưa cho máy học [S1]. Hình dung đơn giản: data là từng viên gạch, data set là cả bức tường đã xếp ngay ngắn.
Trong thực tế, hầu hết công việc của người làm data science bắt đầu bằng việc chọn hoặc tự xây một data set phù hợp với bài toán. Bài toán là "dự đoanh khách hàng rời đi" thì cần bảng lịch sử giao dịch; bài toán là "đọc chữ viết tay" thì cần tập ảnh chữ số; bài toán là "gợi ý bạn bè" thì cần đồ thị quan hệ. Cùng một dự án, dạng data set khác nhau sẽ dẫn tới cách xử lý khác nhau hoàn toàn.
Bốn dạng cấu trúc data set thường gặp
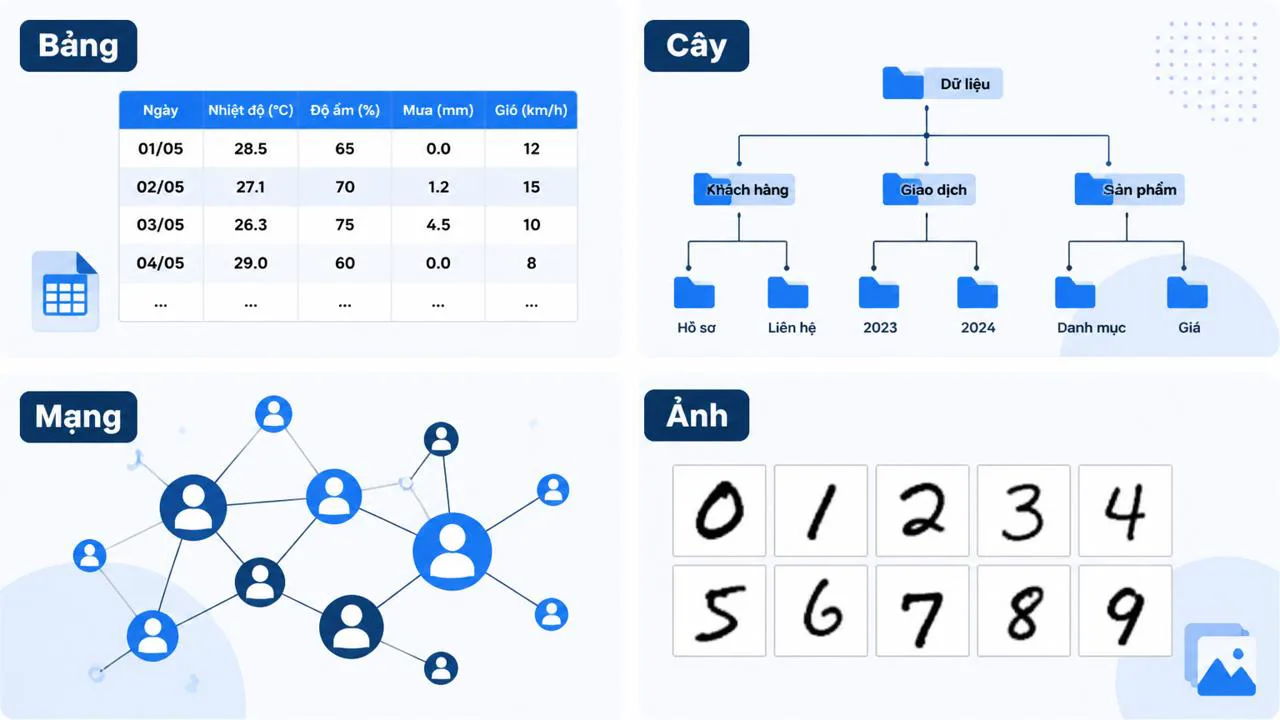
Không phải data set nào cũng là một bảng Excel. Có bốn dạng cấu trúc phổ biến mà người mới sẽ gặp — mỗi dạng phù hợp với một nhóm bài toán khác nhau.
Tabular — bảng dòng và cột
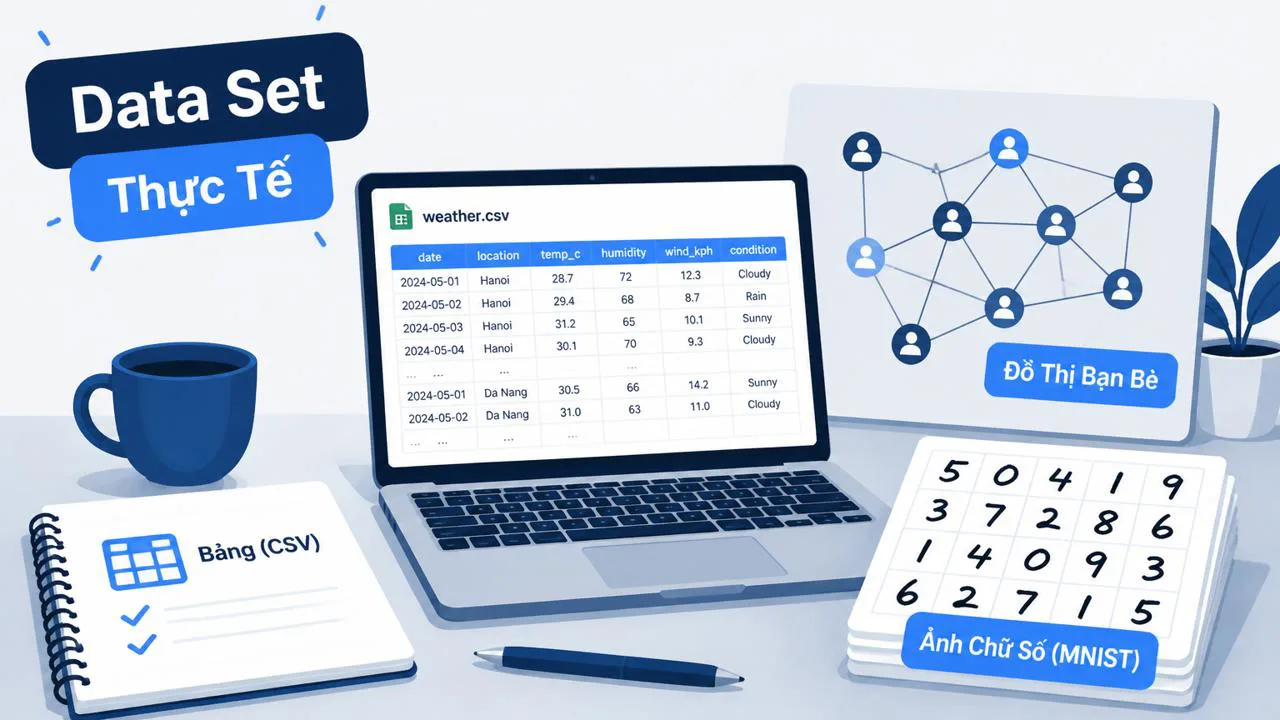
Dạng phổ biến nhất. Mỗi dòng là một quan sát, mỗi cột là một thuộc tính. Ví dụ dễ hình dung: bảng ghi nhiệt độ, độ ẩm, sức gió của một trạm thời tiết mỗi giờ — mỗi dòng là một thời điểm, mỗi cột là một chỉ số. Dạng này thường được lưu thành file CSV — mở bằng Notepad sẽ thấy các giá trị cách nhau bằng dấu phẩy, rất đơn giản [S4]. Nếu bạn cần đi sâu vào các kiểu file, có thể tham khảo thêm về định dạng file dữ liệu phổ biến như CSV, JSON, XLSX.
Hierarchical — cấu trúc cây
Dữ liệu xếp theo quan hệ cha – con, giống cây thư mục trong máy tính: thư mục "Ảnh" chứa thư mục "Du lịch" chứa thư mục "Hà Nội" chứa từng tấm ảnh. Dạng này hay gặp trong file XML, JSON lồng nhau, hoặc bảng phân cấp công ty (phòng ban → nhóm → nhân viên).
Network — đồ thị nút và cạnh
Dữ liệu mô tả quan hệ giữa các đối tượng. Ví dụ quen thuộc nhất là mạng bạn bè trên mạng xã hội: mỗi người là một nút, mỗi lời kết bạn là một cạnh nối hai nút. Dạng này rất hữu ích cho các bài toán gợi ý kết nối, phát hiện cộng đồng, phân tích ảnh hưởng.
Raw media — tập ảnh, âm thanh, video
Không phải bảng số, mà là chính những tệp gốc: bộ ảnh chụp, đoạn ghi âm, video. Ví dụ kinh điển là bộ ảnh chữ số viết tay MNIST — tập hợp hàng chục nghìn ảnh nhỏ từ 0 đến 9, dùng để dạy máy "nhìn" chữ số. Dạng này đặc biệt quan trọng với các bài toán thị giác máy tính và xử lý giọng nói.
Private data và open data khác nhau thế nào
Cùng là data, nhưng cách dùng rất khác nhau tuỳ theo ai giữ và cho phép dùng tới đâu.
Private data là dữ liệu do công ty hoặc cá nhân giữ, thường không chia sẻ công khai: danh sách khách hàng, bảng giá nội bộ, lịch sử giao dịch, dữ liệu sức khoẻ cá nhân. Muốn dùng phải xin phép, ký thoả thuận, và thường phải tuân thủ luật bảo vệ dữ liệu cá nhân.
Open data là dữ liệu được chính phủ, tổ chức nghiên cứu, hoặc doanh nghiệp công bố miễn phí cho mọi người dùng. Ví dụ quen thuộc: dữ liệu dân số công khai của một quốc gia, bảng chỉ số phát triển của Liên Hợp Quốc, dữ liệu giao thông do thành phố phát hành. Open data quan trọng vì nó cho người mới có nguyên liệu để thực hành, cho nhà nghiên cứu có nền tảng để làm sản phẩm, và cho cộng đồng AI có thêm dữ liệu để phát triển mô hình [S2][S8].
Open data không có nghĩa là "dùng thoải mái không cần đọc giấy phép" — nó có nghĩa là dữ liệu được công bố rộng rãi, còn điều kiện cụ thể tuỳ theo giấy phép đi kèm.
Nguồn open data phổ biến cho người mới
Có vài nguồn mà người mới bắt đầu thường tìm tới. Mỗi nguồn có đặc thù riêng, và điều quan trọng là mỗi data set bên trong lại có giấy phép riêng — phải đọc trước khi dùng cho dự án thật.
- Kaggle: cộng đồng lớn, có nhiều data set kèm theo cuộc thi và notebook mẫu. Phù hợp để bắt đầu thực hành.
- Google Dataset Search: máy tìm chuyên cho data set, gom từ nhiều nguồn trên web.
- Cổng dữ liệu mở của chính phủ các nước và thành phố: thường có data giao thông, dân số, kinh tế, môi trường.
- Liên Hợp Quốc, Liên minh châu Âu: data cấp toàn cầu và khu vực, thường ổn định và lâu dài.
- UCI Machine Learning Repository: kho data set học thuật kinh điển, nhiều bài báo gốc dùng data ở đây [S8].
Danh sách nguồn và điều khoản có thể thay đổi theo thời gian, nên khi dùng cho dự án thật nên kiểm tra lại trên trang chính hãng của từng nguồn. Với người mới, có thể bắt đầu từ Kaggle hoặc UCI, tải về một data set nhỏ, mở bằng Excel hoặc Notepad để xem trước khi đưa vào code.
Giấy phép CDLA là gì, và vì sao nó ra đời
Nhiều người mới quen với việc tải phần mềm mã nguồn mở (ví dụ MIT, Apache, GPL) rồi mặc định áp dụng tư duy đó cho data. Nhưng data không giống phần mềm: data có thể chứa thông tin cá nhân, có thể được tuyển chọn và làm sạch mất nhiều công sức, và cách "sửa" data không giống cách sửa code. Vì thế các giấy phép mã nguồn mở viết cho phần mềm không thật sự phù hợp nếu áp sang data.
Để lấp khoảng trống đó, Linux Foundation đã tạo ra CDLA — Community Data License Agreement, một bộ giấy phép viết riêng cho dữ liệu. CDLA được cộng đồng open data đón nhận vì nó rõ ràng, phù hợp với đặc thù của data, và được một tổ chức uy tín bảo trợ. Hiện có hai biến thể chính mà người dùng hay gặp.
CDLA-Sharing và CDLA-Permissive khác nhau ở điểm nào
Hai biến thể này giống nhau ở chỗ: cho phép dùng, sao chép, chỉnh sửa, phân phối lại data. Khác nhau ở điều kiện kèm theo khi phát hành bản sửa.
CDLA-Sharing hoạt động theo kiểu "copyleft" — tức là nếu bạn sửa data rồi phát hành lại bản sửa, thì bản sửa đó phải giữ nguyên giấy phép CDLA-Sharing. Mục tiêu là giữ cho data luôn ở trong hệ sinh thái chia sẻ mở.
CDLA-Permissive nhẹ hơn: dùng, sửa, phân phối tự do, không bắt buộc phải chia sẻ lại bản sửa theo cùng giấy phép. Phù hợp khi bạn muốn linh hoạt hơn trong việc đóng gói hoặc thương mại hoá.
Một điểm rất quan trọng mà người mới hay nhầm: cả hai giấy phép CDLA đều chỉ ràng buộc chính cái data, không ràng buộc "kết quả" tạo ra từ data. Nghĩa là nếu bạn dùng data CDLA để huấn luyện một mô hình AI, thì mô hình đó không tự động bị bắt buộc phải chia sẻ. Chỉ khi bạn phát hành lại chính bộ data (kèm cả phần bạn thêm vào) thì điều kiện CDLA mới áp dụng cho phần data đó.
CDLA ràng buộc data, không ràng buộc mô hình. Tách bạch được hai thứ này sẽ tránh được rất nhiều hiểu lầm khi đọc giấy phép.
Ví dụ thực tế để hình dung
Để mọi thứ không trừu tượng, ghép từng dạng data set với một ví dụ quen thuộc:
- Trạm thời tiết → tabular CSV: mỗi dòng là một mốc thời gian, mỗi cột là nhiệt độ, độ ẩm, sức gió. Mở bằng Notepad thấy chữ cách nhau bởi dấu phẩy.
- MNIST → raw media: bộ ảnh chữ số viết tay, mỗi ảnh là một quan sát. Dùng để dạy máy đọc chữ số.
- Bạn bè trên mạng xã hội → network: nút là người dùng, cạnh là quan hệ kết bạn. Phù hợp bài toán gợi ý kết nối.
- Huấn luyện mô hình với data CDLA: giấy phép chỉ trói buộc chính bộ data, không trói buộc mô hình đã train — nên bạn có thể dùng mô hình cho sản phẩm thử nghiệm mà không phải chia sẻ lại mô hình.
Sai lầm thường gặp khi mới dùng open data
Dưới đây là vài lỗi phổ biến mà người mới hay mắc — đọc trước sẽ tránh được khá nhiều rắc rối:
- Tưởng "miễn phí trên mạng nghĩa là dùng thoải mái" — thực tế mỗi data set có giấy phép riêng, có cái cho dùng thương mại, có cái chỉ cho dùng học thuật, có cái bắt buộc ghi nguồn.
- Nhầm giấy phép của data với giấy phép của kết quả — ví dụ nghĩ mô hình train từ data CDLA cũng phải chia sẻ, trong khi CDLA chỉ ràng buộc data.
- Dùng giấy phép phần mềm mã nguồn mở cho data — MIT, GPL… viết cho code, không phù hợp để áp cho data.
- Chọn open data không khớp bài toán: thiếu trường quan trọng, dữ liệu quá ít, hoặc chất lượng kém.
- Quên chọn đúng dạng data set: bài toán cần quan hệ nhưng lại tải bảng phẳng, hoặc ngược lại.
Checklist 5 bước trước khi dùng một data set
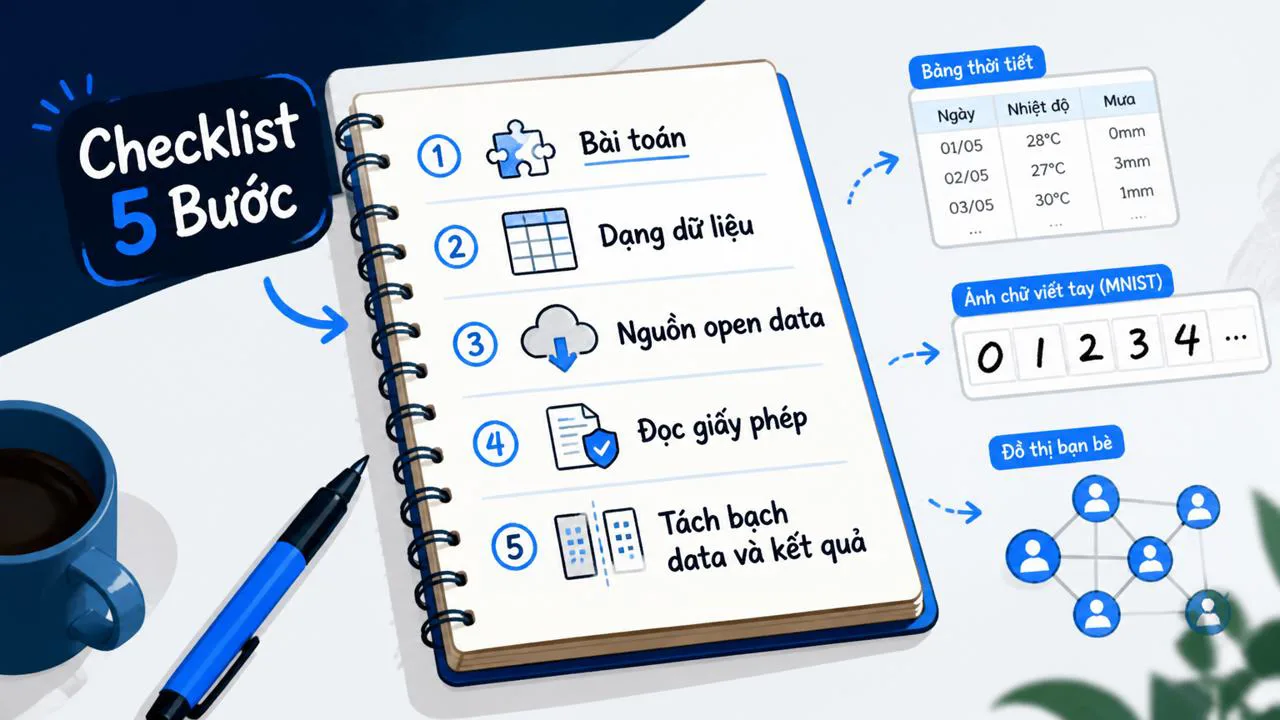
Tóm lại, trước khi đưa một data set vào dự án — dù là bài tập, dự án cá nhân hay sản phẩm thử nghiệm — đi qua nhanh 5 bước sau:
- Xác định bài toán rõ ràng: cần dự đoán gì, gợi ý gì, hay mô tả gì.
- Chọn dạng cấu trúc phù hợp: bảng, cây, mạng, hay tập ảnh/audio/video.
- Tìm nguồn open data phù hợp: Kaggle, Google Dataset Search, cổng dữ liệu mở chính phủ, UCI…
- Đọc kỹ giấy phép: là CDLA-Sharing, CDLA-Permissive hay loại khác; có cho dùng thương mại không, có bắt buộc ghi nguồn không.
- Tách bạch giấy phép của data và giấy phép của kết quả: mô hình, báo cáo, sản phẩm tạo ra từ data không tự động bị ràng buộc bởi giấy phép data.
Hiểu được data set là gì, đọc được giấy phép CDLA, và biết cách tách bạch giấy phép data với giấy phép kết quả là bạn đã đi trước khá nhiều người mới. Phần còn lại là thực hành: tải một data set nhỏ, đọc giấy phép, xử lý thử, rồi đánh giá lại xem data đó có thật sự phù hợp với bài toán của mình không. Nếu bạn đang xây dựng bộ công cụ xử lý dữ liệu đầu tiên, có thể tham khảo thêm về các nhóm công cụ dùng để quản lý và xử lý data set để chọn đúng công cụ cho từng bước.
Tags
- UCI
- giấy phép CDLA
- data license
- kaggle
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.