Data Science
Machine Learning Là Gì? Ba Loại Học Máy, Regression, Classification Và Cách Xây Dựng Một Mô Hình Dự Đoán
Machine learning là máy tự rút quy luật từ dữ liệu thay vì được lập trình từng luật. Bài gom 3 loại học máy, 2 dạng bài toán regression/classification, 5 bước dựng mô hình và lỗi người mới hay vấp.
 Phong Nguyen
PNTECH Writer · 17/09/2026
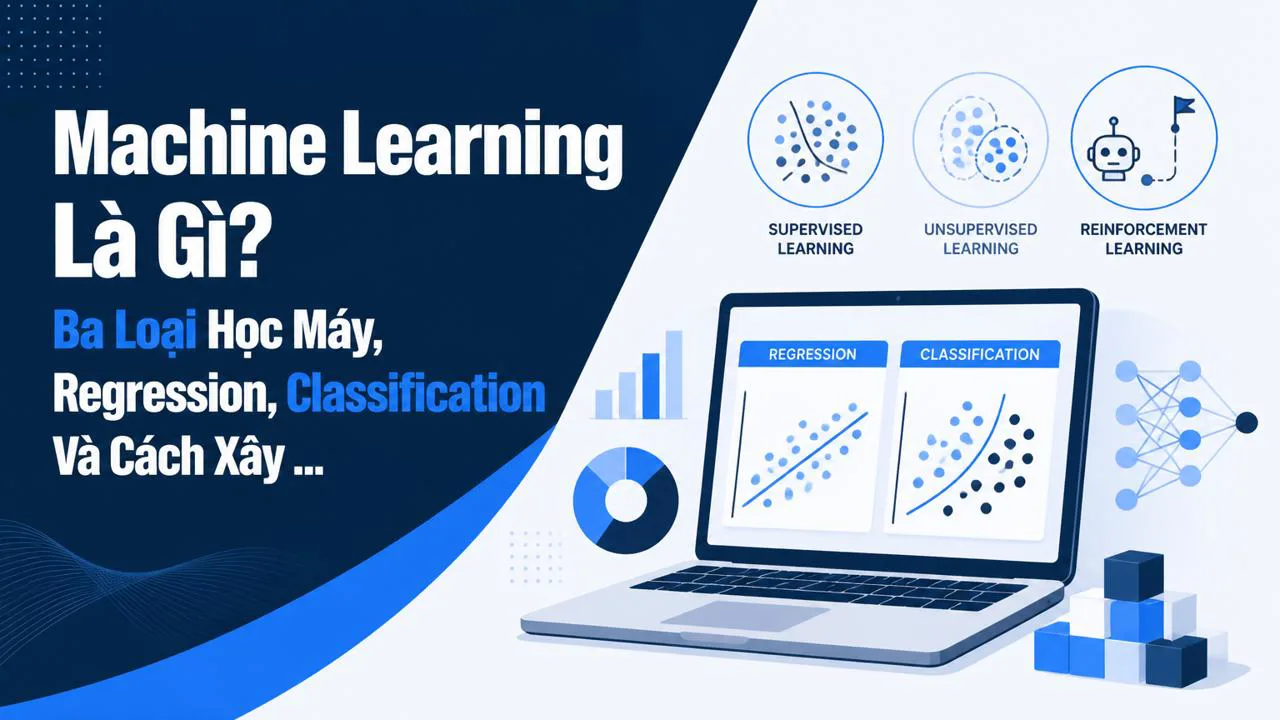
Nếu bạn đã từng xem YouTube gợi ý video tiếp theo, hoặc Shopee gợi ý sản phẩm "có thể bạn sẽ thích", bạn đã thấy machine learning (học máy) chạy thật rồi — không phải phép màu, chỉ là máy tính tự rút ra quy luật từ dữ liệu thay vì được lập trình viên ghi từng dòng luật. Bài này gom gọn 3 loại machine learning phổ biến, 2 dạng bài toán thường gặp nhất (regression dự đoán con số, classification phân loại), và 5 bước cơ bản để tự dựng một mô hình dự đoán — kèm theo những lỗi người mới hay vấp để bạn tự đánh giá khi nào ML đáng học và khi nào chưa cần.
Machine learning là gì và khác phần mềm thường ở điểm nào
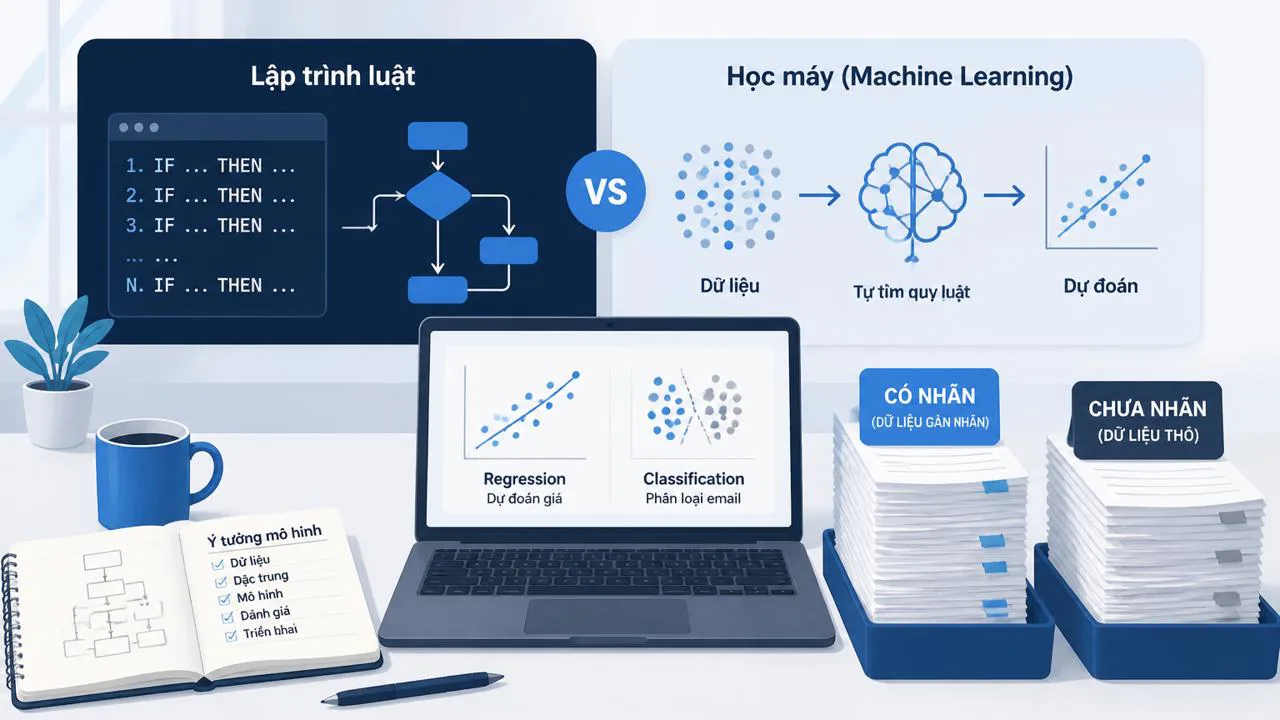
Phần mềm truyền thống hoạt động theo kiểu: người viết ra luật, máy chạy đúng luật đó. Ví dụ đơn giản — để lọc email rác, người lập trình ngồi viết hàng nghìn dòng kiểu: "nếu email chứa từ 'trúng thưởng' hoặc 'miễn phí 100%' thì đánh dấu spam". Máy chỉ biết làm theo, không tự nghĩ thêm.
Machine learning thì ngược lại. Bạn không viết luật — bạn đưa cho máy một tập dữ liệu đã được gán nhãn (ví dụ: hàng vạn email cũ, mỗi email được con người đánh dấu "spam" hoặc "không spam"), rồi máy tự tìm ra đặc điểm chung của nhóm spam để lần sau phân loại email mới. Nói nôm na: thay vì dạy máy bằng quy tắc, bạn dạy máy bằng ví dụ.
Ví dụ đời thường cho dễ hình dung: bạn dạy một đứa trẻ phân biệt mèo và chó. Bạn không ngồi giải thích "4 chân, có ria mép, kêu meo meo là mèo" — bạn chỉ vào từng con và nói "con này là mèo, con này là chó" đủ nhiều lần, đứa trẻ tự rút ra đặc điểm. Machine learning cũng vậy, chỉ là "đứa trẻ" ở đây là một chương trình, còn "dữ liệu dạy" là hàng nghìn đến hàng triệu ví dụ.
Vậy khi nào đáng dùng machine learning? Có hai tình huống điển hình. Một là khi dữ liệu quá nhiều để xem bằng tay — ví dụ log giao dịch thẻ tín dụng cả triệu dòng mỗi ngày. Hai là khi bài toán quá phức tạp để viết luật bằng tay — ví dụ nhận diện khuôn mặt trong ảnh, hoặc phân biệt giọng nói, vì luật "khuôn mặt trông như thế nào" gần như không viết được bằng lệnh if-else. Ngược lại, nếu bài toán nhỏ và rõ ràng, một bảng Excel làm nhanh hơn nhiều so với dựng cả một mô hình ML.
Ba loại machine learning cần biết
Trước khi đụng vào bất kỳ mô hình nào, bạn chỉ cần nhớ 3 loại học máy chính. Tự hỏi "bài toán của mình có đáp án đúng sẵn không?" sẽ giúp bạn chọn đúng loại ngay từ đầu.
Supervised learning (học có giám sát, hay học có "giáo viên") là loại phổ biến nhất. Bạn có cả câu hỏi lẫn đáp án đúng sẵn — gọi là dữ liệu có nhãn. Máy sẽ học mối liên hệ giữa câu hỏi và đáp án, rồi áp dụng cho dữ liệu mới. Hầu hết bài toán thực tế mà bạn nghe tới đều rơi vào nhóm này: dự đoán giá nhà, lọc email rác, phát hiện gian lận thẻ tín dụng, chẩn đoán bệnh từ ảnh X-quang.
Unsupervised learning (học không giám sát) thì ngược lại — bạn không có đáp án đúng, máy tự tìm cấu trúc trong dữ liệu. Hai việc hay gặp: gom nhóm (clustering — ví dụ gợi ý sản phẩm cho nhóm khách có thói quen mua tương tự) và phát hiện bất thường (anomaly detection — ví dụ tự phát hiện giao dịch lạ trong hàng triệu giao dịch bình thường).
Reinforcement learning (học tăng cường, hay học thử–sai) là cách máy học qua thưởng và phạt. Máy thử một hành động, nếu tốt thì được "thưởng", nếu tệ thì bị "phạt", dần dần nó biết cách hành động tốt hơn trong một môi trường cụ thể. Ví dụ kinh điển: con chuột trong mê cung tìm phô mai, AI chơi cờ vua hay cờ tướng, hoặc robot tập đi mà không bị ngã.
Trước khi chọn mô hình, hỏi một câu: "Bài toán của mình đã có đáp án đúng sẵn chưa?" — có thì là supervised, không có mà muốn nhóm thì là unsupervised, có cơ chế thưởng/phạt rõ ràng thì là reinforcement.
Regression và classification — hai dạng bài toán supervised
Trong nhóm supervised, người ta chia thành hai dạng bài toán lớn dựa trên kiểu đầu ra bạn muốn.
Regression (hồi quy) là dự đoán một con số — đầu ra là số thực, có thể là bất kỳ giá trị nào trên trục số. Ví dụ: dự đoán giá một căn nhà từ diện tích, vị trí, số phòng; dự đoán doanh thu tháng sau của một cửa hàng; dự đoán nhiệt độ ngày mai. Máy sẽ cho bạn một con số cụ thể, ví dụ "giá nhà ước tính 3.2 tỷ".
Classification (phân loại) là gán một nhãn cho dữ liệu — đầu ra là một nhóm trong một tập hữu hạn. Ví dụ: email này là "spam" hay "không spam"; ảnh này là "mèo" hay "chó"; giao dịch thẻ này là "bình thường" hay "nghi ngờ gian lận"; khách hàng này là "sẽ rời bỏ" hay "sẽ ở lại". Đầu ra là nhãn, không phải con số liên tục.
Lỗi người mới hay gặp nhất là nhầm giữa hai dạng này. Có người cố dùng regression để phân loại email — máy sẽ ra một con số vô nghĩa kiểu 0.73 thay vì nhãn "spam". Ngược lại, có người dùng classification để dự đoán giá nhà — máy chỉ chọn một trong vài mức giá rời rạc, không ước lượng được con số chính xác. Nắm rõ đầu ra mong muốn sẽ tránh được ngay sai lầm này.
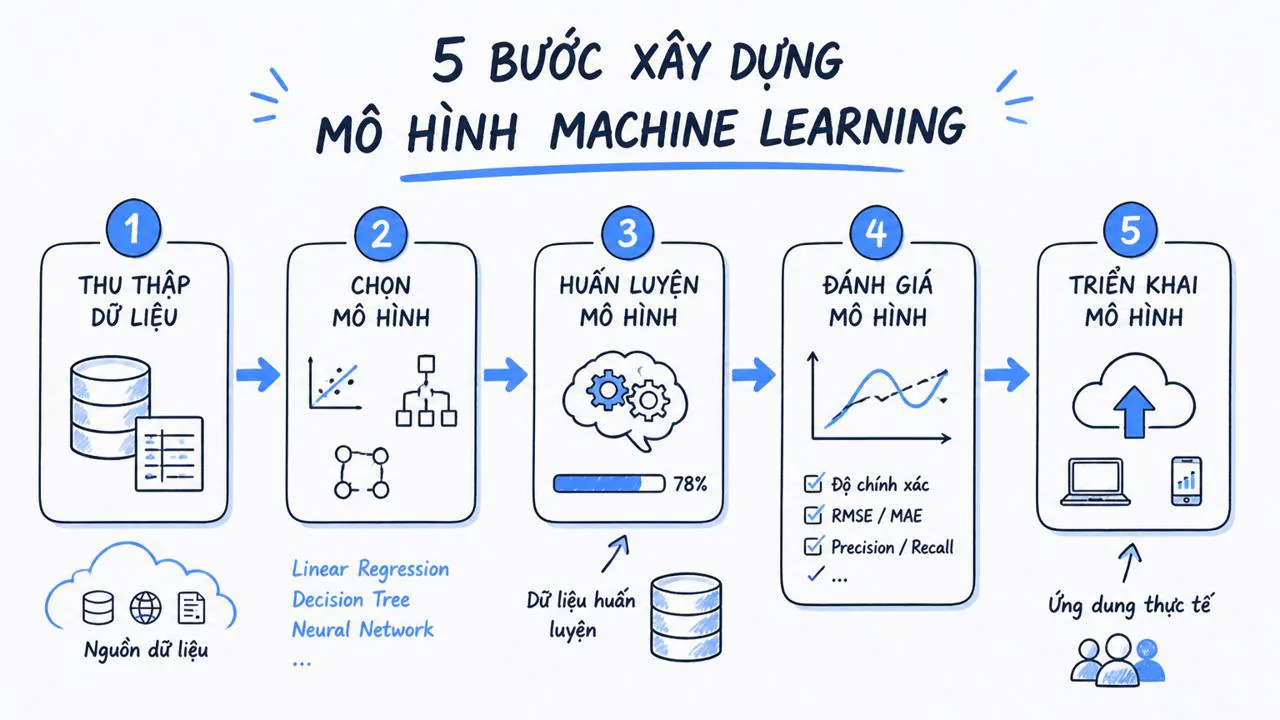
Năm bước dựng một mô hình dự đoán
Dù bạn dựng mô hình đơn giản hay phức tạp, quy trình cơ bản đều đi qua 5 bước. Hiểu quy trình này là đủ để bạn nhìn ra người ta đang làm gì khi đọc các bài hướng dẫn, hoặc để tự đánh giá xem dự án ML có khả thi không.
Bước 1 — Thu thập và gán nhãn dữ liệu. Đây thường là khâu tốn thời gian nhất, có khi chiếm 60–80% tổng công sức của cả dự án. Bạn cần đủ dữ liệu và mỗi mẫu cần được gán nhãn đúng. Ví dụ: muốn máy nhận diện chó trong ảnh, bạn phải khoanh vùng con chó trong hàng nghìn ảnh — việc này do người làm thủ công, không có cách nào làm tự động 100% nếu chưa có mô hình.
Bước 2 — Chọn mô hình. Bạn có hai hướng: dựng từ đầu (chọn thuật toán phù hợp như regression tuyến tính, cây quyết định, mạng nơ-ron) hoặc dùng mô hình đã được train sẵn (gọi là pre-trained model) từ các framework phổ biến như TensorFlow, PyTorch, Keras, hay từ các kho mô hình công khai (gọi là model zoo). Phần lớn người mới nên bắt đầu từ mô hình có sẵn để khỏi ngợp.
Bước 3 — Train (dạy máy). Đưa dữ liệu đã gán nhãn vào mô hình, để máy tự điều chỉnh tham số bên trong sao cho đầu ra khớp với nhãn thật. Quá trình này giống như cho học sinh làm bài tập rồi chữa lại — máy làm sai, sửa, làm sai ít hơn, lặp đi lặp lại hàng nghìn lần.
Bước 4 — Đánh giá và lặp lại. Sau khi train, bạn thử mô hình với một tập dữ liệu riêng mà máy chưa thấy bao giờ (gọi là tập kiểm tra), xem nó đoán đúng bao nhiêu phần trăm. Nếu chưa đạt, bạn chỉnh dữ liệu, chỉnh tham số, đổi mô hình, rồi train lại. Vòng lặp này thường diễn ra nhiều lần trước khi có bản ổn.
Bước 5 — Đưa vào dùng thật (deploy). Khi mô hình đã đủ tốt, bạn gắn nó vào ứng dụng, web hoặc hệ thống thật để xử lý dữ liệu mới hàng ngày. Lúc này máy mới thực sự "làm việc" chứ không còn là bài tập nữa.
Pre-trained model và model zoo — không phải lúc nào cũng dựng từ đầu
Một sai lầm phổ biến của người mới là nghĩ phải dựng mô hình từ đầu. Thực tế, rất nhiều bài toán đã có người train sẵn trên tập dữ liệu khổng lồ, bạn chỉ cần tải về dùng hoặc tinh chỉnh thêm cho dữ liệu riêng. Các framework phổ biến hiện nay như TensorFlow, PyTorch, Keras, ONNX đều có kho mô hình công khai (gọi chung là model zoo) — đây giống như kho "bản thiết kế" miễn phí mà cộng đồng đã đăng lên.
Có hai cách dùng pre-trained model. Cách một là dùng luôn nếu bài toán khớp — ví dụ cần nhận diện khuôn mặt chung chung, có thể tìm được mô hình đã train trên hàng triệu ảnh, độ chính xác đã rất tốt. Cách hai là tinh chỉnh thêm (gọi là fine-tune): lấy mô hình có sẵn, train tiếp trên dữ liệu riêng của bạn để nó hiểu đặc thù nghiệp vụ của bạn — ví dụ nhận diện logo công ty, phân loại email theo tiêu chí nội bộ.
Dùng pre-trained model giống như mua một bản thiết kế nhà đã có sẵn rồi sửa màu sơn, thêm phòng — thay vì tự vẽ lại từng viên gạch. Tiết kiệm hàng tháng, thậm chí hàng năm công sức.
Nếu bạn muốn tham khảo kho mô hình cụ thể, MAX — kho model deep learning mở là một ví dụ đáng xem: IBM đăng tải các mô hình đã train sẵn cho nhiều bài toán thực tế, bạn có thể tải về và chạy thử mà không cần dựng lại từ đầu.
Deep learning là gì và khi nào nên dùng
Deep learning (học sâu) là một nhánh của machine learning, lấy cảm hứng từ cấu trúc bộ não người. Thay vì mô hình tuyến tính đơn giản, deep learning dùng mạng nơ-ron nhiều lớp (neural network) để xử lý dữ liệu phức tạp như ảnh, âm thanh, video, văn bản ngôn ngữ tự nhiên. Chính vì vậy, các ứng dụng bạn thấy ấn tượng nhất trong vài năm gần đây — nhận diện khuôn mặt, dịch tự động, trợ lý ảo nói chuyện được — đều dựa trên deep learning.
Tuy nhiên, deep learning không phải lúc nào cũng là lựa chọn tốt nhất. Để deep learning phát huy, bạn cần hai điều kiện: dữ liệu gán nhãn cực lớn (hàng trăm nghìn đến hàng triệu mẫu) và máy tính có GPU mạnh để train trong thời gian hợp lý. Nếu bài toán của bạn nhỏ, dữ liệu chỉ vài nghìn dòng, hoặc bảng dữ liệu dạng số đơn giản — các mô hình truyền thống như regression, cây quyết định (decision tree) sẽ cho kết quả tương đương mà train nhanh hơn nhiều, không cần GPU, và dễ giải thích hơn.
Ví dụ thực tế gắn với đời sống người Việt
Để mọi thứ bớt lý thuyết, đây là vài ví dụ cụ thể bạn có thể gặp hàng ngày:
- Regression — dự đoán giá nhà: Bạn có bảng dữ liệu các căn nhà đã bán (diện tích, quận, số phòng, giá bán thực tế). Máy sẽ học mối liên hệ giữa các đặc điểm và giá, rồi dự đoán giá một căn nhà mới chưa bán. Đầu ra là một con số (ví dụ "3.2 tỷ"), không phải nhãn.
- Classification — lọc email rác: Từ hàng vạn email cũ đã được gán nhãn "spam" hoặc "không spam", máy học đặc điểm của email rác, sau đó tự đánh dấu email mới. Đầu ra là một trong hai nhãn.
- Unsupervised — gợi ý sản phẩm: Shopee hoặc Tiki nhóm khách hàng theo thói quen mua tương tự (cùng hay mua đồ gia dụng, hoặc cùng hay mua thời trang), rồi gợi ý sản phẩm cho khách dựa trên nhóm họ thuộc về. Không cần nhãn trước, máy tự tìm nhóm.
- Reinforcement — AI chơi cờ: AlphaGo của DeepMind học chơi cờ vây bằng cách tự chơi hàng triệu ván, mỗi nước đi đúng được thưởng, sai bị phạt, dần dần vượt cả con người. Ví dụ này tuy xa vời nhưng là minh chứng rõ nhất cho học thử–sai.
Nếu bạn muốn đi sâu thêm các ứng dụng trong đời sống và tài chính như hệ thống gợi ý, phát hiện gian lận, hay phân tích dự đoán (predictive analytics), xem ứng dụng ML trong đời sống và tài chính sẽ cho bạn nhiều ví dụ thực tế hơn.
Những lỗi người mới hay vấp
Dưới đây là những sai lầm phổ biến nhất mà người mới tiếp cận machine learning hay gặp. Biết trước sẽ giúp bạn tiết kiệm thời gian và tránh đi lại vết xe đổ.
- Nhầm phân tích dữ liệu thủ công với ML. Có bài toán chỉ cần Excel, SQL, hoặc một dashboard là đủ trả lời. Nhảy vào dựng mô hình ML khi chưa hiểu rõ dữ liệu là phí thời gian. Nên làm phân tích thủ công trước, khi nào thấy luật quá phức tạp hoặc dữ liệu quá lớn thì mới tính tới ML.
- Nhầm regression và classification. Đã nói ở trên: đầu ra muốn con số thì dùng regression, muốn nhãn thì dùng classification. Sai chỗ này sẽ làm hỏng cả mô hình.
- Quên rằng unsupervised không có đáp án đúng. Với supervised, bạn có thể đo độ chính xác (accuracy) bằng cách so với nhãn thật. Với unsupervised (gom nhóm, phát hiện bất thường), bạn không có nhãn đúng để so — phải đánh giá bằng cách khác, ví dụ hỏi chuyên gia hoặc xem kết quả có ý nghĩa thực tế không.
- Đánh giá thấp khâu gán nhãn dữ liệu. Nhiều người tưởng phần khó là chọn mô hình, nhưng thực tế phần tốn thời gian nhất là thu thập và gán nhãn dữ liệu — đặc biệt với ảnh, giọng nói, văn bản. Một bộ dữ liệu gán nhãn tốt còn quan trọng hơn thuật toán tinh vi.
- Mặc định deep learning là "xịn nhất". Deep learning ấn tượng trên báo chí, nhưng với bảng dữ liệu nhỏ hoặc bài toán đơn giản, mô hình truyền thống cho kết quả tương đương mà rẻ và nhanh hơn nhiều.
Checklist chọn loại mô hình nào cho bài toán của bạn
| Tình huống của bạn | Loại mô hình nên dùng |
|---|---|
| Có dữ liệu đã gán nhãn + muốn dự đoán con số (giá, doanh thu, nhiệt độ) | Regression (hồi quy) |
| Có dữ liệu đã gán nhãn + muốn phân loại (spam/không spam, mèo/chó) | Classification (phân loại) |
| Không có nhãn + muốn nhóm đối tượng giống nhau | Clustering (gom nhóm, unsupervised) |
| Không có nhãn + muốn phát hiện gian lận hoặc điểm bất thường | Anomaly detection (phát hiện bất thường, unsupervised) |
| Môi trường có cơ chế thưởng/phạt rõ ràng (game, robot, tối ưu hóa chuỗi hành động) | Reinforcement learning (học tăng cường) |
| Dữ liệu ảnh/giọng nói/video/ngôn ngữ + lượng dữ liệu cực lớn | Deep learning (học sâu) |
Vị trí của machine learning trong bức tranh data science
Machine learning không phải là toàn bộ data science, mà là một nhánh quan trọng trong đó. Nếu bạn muốn hiểu ML nằm ở đâu trong bức tranh tổng, hiểu ML nằm ở đâu trong data science sẽ giúp bạn nhìn rõ hơn mối liên hệ giữa thu thập dữ liệu, phân tích, trực quan hóa và dựng mô hình. Còn nếu bạn muốn đi sâu vào bản chất các thuật toán supervised cụ thể (regression tuyến tính, cây quyết định, k-nearest neighbors), xem chi tiết các thuật toán machine learning phổ biến là bước tiếp theo hợp lý.
Khi bạn đã sẵn sàng khám phá nhánh deep learning chuyên xử lý ảnh và ngôn ngữ, đọc tiếp về deep learning và neural network sẽ giới thiệu mạng nơ-ron theo cách dễ hiểu cho người mới. Ngoài ra, nếu bạn quan tâm tới cách data scientist hiện đại tận dụng AI tạo sinh để tăng tốc workflow, xem thêm: machine learning là gì và ba loại học máy sẽ cho góc nhìn bổ sung về mối quan hệ giữa ML truyền thống và generative AI.
Tóm lại
Machine learning là cách dạy máy bằng ví dụ thay vì bằng luật. Có 3 loại chính: supervised (có đáp án sẵn, gồm regression dự đoán con số và classification phân loại nhãn), unsupervised (không có đáp án, tự nhóm hoặc phát hiện bất thường), và reinforcement (học qua thưởng/phạt). Quy trình dựng một mô hình cơ bản gồm 5 bước: thu thập và gán nhãn dữ liệu, chọn mô hình, train, đánh giá và lặp lại, rồi đưa vào dùng thật. Phần lớn người mới nên bắt đầu bằng pre-trained model thay vì dựng từ đầu, và chỉ nên tính tới deep learning khi bài toán thực sự cần. Nếu bạn đang ở giai đo
Tags
- regression
- classification
- machine learning
- supervised learning
- khoa học dữ liệu
- deep learning
- pre-trained model
- xây dựng mô hình
- unsupervised learning
- học máy
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.