Data Science
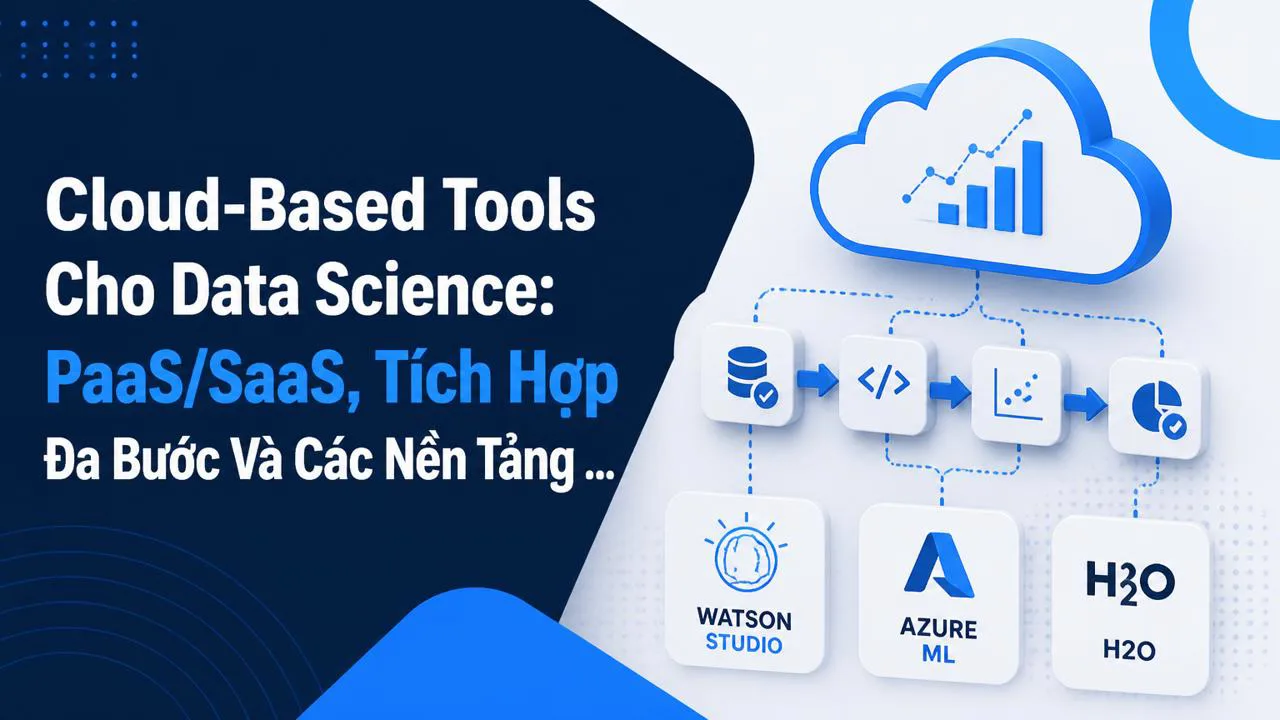
Cloud-Based Tools Cho Data Science: PaaS/SaaS, Tích Hợp Đa Bước Và Các Nền Tảng Thương Mại Phổ Biến
Cloud-based tools giúp bạn làm data science trên trình duyệt mà không cần máy cấu hình cao. Bài so sánh PaaS, SaaS, one-click deploy và các nền tảng thương mại phổ biến để bạn chọn đúng.
 Phong Nguyen
PNTECH Writer · 17/09/2026
Bạn không cần mua máy cấu hình cao để train model nữa — chỉ cần mở trình duyệt, đăng nhập và bắt đầu làm việc. Đó chính là lý do người làm data science (khoa học dữ liệu — tức ngành rút ra hiểu biết và dự đoán từ dữ liệu) dần chuyển sang dùng cloud-based tools (công cụ chạy trên nền tảng điện toán đám mây, tức máy chủ từ xa mà bạn thuê qua internet). Trước khi chọn một nền tảng cho dự án nhỏ của mình, bạn cần hiểu cloud-based tools cho data science hoạt động ra sao, khác gì với cài phần mềm trên máy, và đâu là những nền tảng thương mại phổ biến — để chọn đúng mà không bị phụ thuộc vào một nhà cung cấp duy nhất.
Cloud-based tools cho data science là gì và khác gì so với cài trên máy?
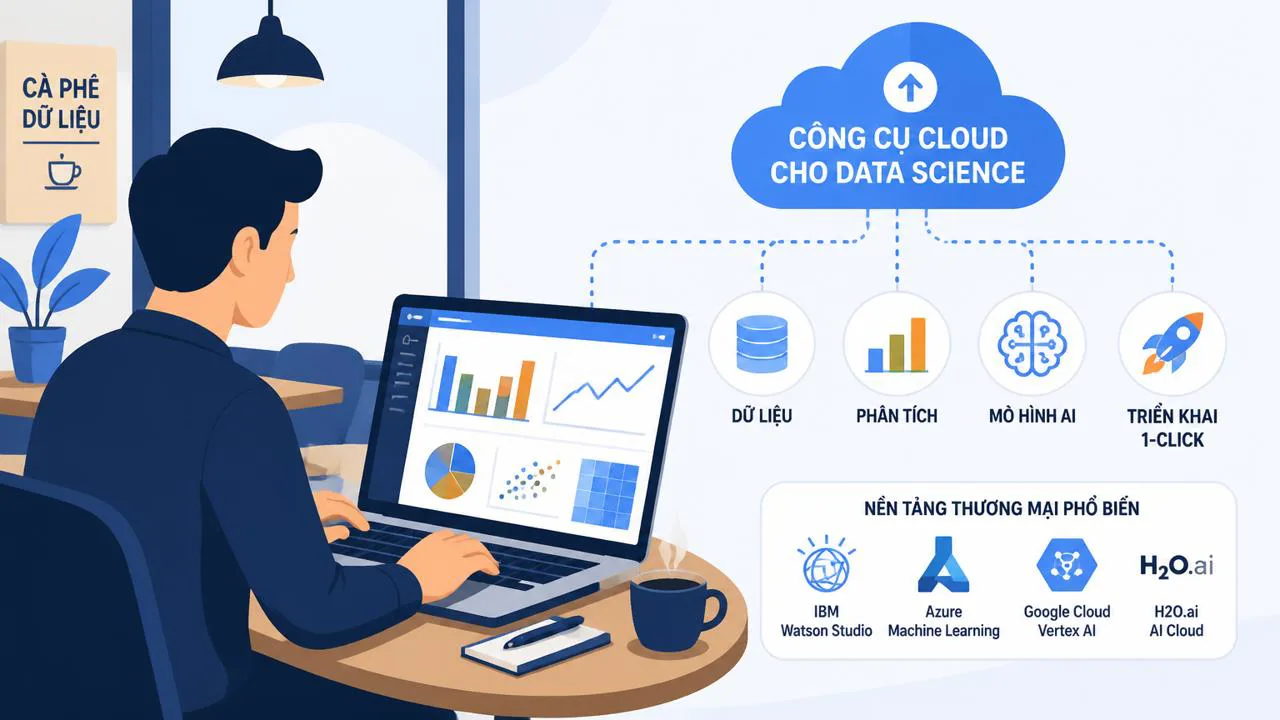
Cloud-based tools cho data science là những công cụ phân tích dữ liệu, train model, vẽ biểu đồ… chạy trên máy chủ từ xa của nhà cung cấp. Bạn truy cập qua trình duyệt hoặc qua một ứng dụng nhẹ; máy tính của bạn chỉ cần đủ để hiển thị kết quả, còn phần tính toán nặng do server của họ xử lý.
Ví dụ đời thường dễ hình dung: thay vì mua dàn tạ tập gym về nhà (tốn tiền, tốn chỗ, lâu lâu mới dùng), bạn ra phòng gym thuê theo tháng (mỗi lần đến chỉ cần tập, không lo bảo trì). Cloud-based tools cho data science cũng vậy: bạn không cần sắm máy chủ, không cần cài hệ điều hành, không phải tự cập nhật phần mềm — mọi thứ nhà cung cấp lo sẵn, bạn trả phí theo mức dùng.
Khác với cách cài phần mềm truyền thống (download về máy, cài đặt, chạy bằng CPU và RAM của máy bạn), cloud tools giao phần "nặng" cho cụm máy chủ (cluster — nhiều máy tính ghép lại làm việc song song). Khi bạn upload một file dữ liệu vài chục GB lên cloud để train model, server của nhà cung cấp sẽ chia nhỏ công việc cho nhiều máy cùng chạy, rồi gom kết quả trả lại cho bạn trong vài phút thay vì vài giờ.
Cloud-based tools cho data science giúp bạn bỏ qua phần "hạ tầng": không mua máy, không cài đặt, không bảo trì — chỉ tập trung vào dữ liệu và mô hình.
Ba cách cloud giao công cụ cho bạn: PaaS, SaaS và one-click deploy
Không phải cloud tool nào cũng giống nhau. Có ba kiểu giao phổ biến mà bạn sẽ gặp khi tìm hiểu:
- PaaS (Platform as a Service — Nền tảng như dịch vụ): nhà cung cấp dựng sẵn một "phòng gym" đầy đủ máy móc, bạn đến tập là chính. Với data science, PaaS nghĩa là nền tảng đã chuẩn bị sẵn môi trường tính toán, các thư viện machine learning, công cụ vẽ biểu đồ; bạn chỉ việc đưa dữ liệu lên và chạy. Watson Studio, Azure Machine Learning là ví dụ điển hình.
- SaaS (Software as a Service — Phần mềm như dịch vụ): mở trình duyệt vào dùng ngay, như mở Google Docs soạn văn bản. Bạn không cài gì lên máy, không cấu hình gì, cứ vào đường link là chạy. Cognos BI trên cloud hay các dashboard báo cáo online thuộc dạng này.
- One-click deploy (cài ở máy, bấm một nút là đẩy lên cloud): bạn cài phần mềm trên máy tính của mình (ví dụ một IDE dùng để viết code Python), nhưng có sẵn một nút bấm để khi nào sẵn sàng thì đẩy model lên cloud chạy. Đây là kiểu lai: vừa quen thuộc với người thích làm offline, vừa tận dụng được sức mạnh cloud khi cần.
Với người mới bắt đầu hoặc SME (doanh nghiệp vừa và nhỏ), SaaS và PaaS thường dễ tiếp cận nhất vì không đòi hỏi bạn phải biết quản trị server. Khi đã quen và muốn kiểm soát nhiều hơn, bạn mới cần cân nhắc sang one-click deploy hoặc tự host (tự chạy server riêng). Bạn có thể đọc thêm cloud computing cơ bản và 3 mô hình PaaS/SaaS để nắm rõ sự khác biệt giữa IaaS, PaaS và SaaS.
Compute cluster đằng sau: vì sao cloud train model nhanh hơn
Đằng sau các cloud tool là một cụm máy chủ làm việc song song, gọi là compute cluster. Bạn không nhìn thấy nó, không cần đụng vào nó — chỉ cần gửi việc lên, nền tảng tự chia việc cho từng máy chạy rồi gom kết quả trả về.
Ví dụ dễ hiểu: tưởng tượng bạn có một bài kiểm tra 100 câu cần chấm trong một tiết. Nếu một mình bạn chấm, mất cả tiết. Nhưng nếu chia đều cho cả lớp, mỗi người vài bài rồi gom lại — xong trong 5 phút. Compute cluster làm y vậy: thay vì một máy tính xử lý tuần tự, hàng chục hoặc hàng trăm máy cùng xử lý, rồi tổng hợp. Đó là lý do cùng một bài toán, máy bạn chạy 3 giờ có thể được cloud giải quyết trong 10 phút.
Vì sao điều này quan trọng với bạn? Vì bạn không cần đầu tư dàn máy trăm triệu để chạy những mô hình phức tạp. Bạn thuê cloud theo giờ, dùng xong trả lại — nhà cung cấp lo phần cứng. Bài viết vì sao cloud giúp làm dữ liệu lớn không cần máy khỏe giải thích chi tiết hơn về cách cụm máy tính này hoạt động trong bối cảnh big data.
Cloud không phải "máy tính ma thuật" mà là một cụm máy chủ chia việc cho nhau. Bạn gửi bài toán, họ chia cho cả lớp làm rồi gom lại trả bạn.
Vì sao các nền tảng ngày càng gộp nhiều bước vào một chỗ
Nếu như trước đây mỗi công cụ đảm nhận một việc — database riêng, công cụ ETL (Extract-Transform-Load — quy trình rút dữ liệu, làm sạch và nạp vào kho) riêng, phần mềm vẽ biểu đồ riêng, phần mềm train model riêng — thì nay các nhà cung cấp lớn (IBM, Microsoft, Google, AWS) gộp tất cả vào một nền tảng. Xu hướng này gọi là "tích hợp đa bước" (integrated platform).
Lý do rất thực tế: một dự án data science bình thường đi qua nhiều công đoạn — lưu trữ dữ liệu, làm sạch, vẽ biểu đồ khám phá, train model, deploy (triển khai model lên môi trường thực tế để người dùng hoặc hệ thống khác gọi tới), giám sát. Nếu mỗi khâu dùng một phần mềm khác nhau, bạn tốn thời gian kết nối, format chuyển đổi, bảo mật nhiều chỗ. Khi tất cả nằm trong một nền tảng, dữ liệu chảy liền mạch hơn, quản lý tập trung hơn, học một chỗ thay vì học cả chục tool.
Đây cũng là lý do các nền tảng thương mại phổ biến ngày nay thường được quảng cáo là "all-in-one": Watson Studio của IBM, Azure Machine Learning của Microsoft, Vertex AI của Google, SageMaker của AWS đều có đủ các bước trong cùng một giao diện. Tất nhiên, vẫn có những tool chuyên một việc (single-purpose cloud service) cho bạn nào cần giải pháp đặc thù — và việc chọn giữa hai hướng này còn tùy thuộc vào quy mô cũng như ngân sách.
Cloud data management: database thuê trên mây
Đây là nơi dữ liệu của bạn "nghỉ chân" trước khi được xử lý. Cloud data management có nghĩa là bạn thuê một database chạy trên server của nhà cung cấp thay vì tự cài đặt database trên máy mình. Nhà cung cấp lo sao lưu (backup), cập nhật bản vá bảo mật, mở rộng dung lượng khi dữ liệu tăng. Cách dùng này còn gọi là DBaaS (Database as a Service — Cơ sở dữ liệu như dịch vụ).
Có hai loại cloud database bạn nên phân biệt rõ:
- Database dựa trên mã nguồn mở, có phiên bản cloud: ví dụ Cloudant (dựa trên CouchDB mã nguồn mở — nghĩa là bất kỳ ai cũng có thể đọc, sửa và dùng lại mã nguồn này). Ưu điểm là bạn có thể chuyển dữ liệu sang tự host (tự chạy server riêng) nếu cần, không bị "khóa" vào một nhà cung cấp.
- Database độc quyền chỉ chạy trên một cloud: ví dụ DynamoDB của AWS. Database này thiết kế riêng cho hạ tầng AWS, chỉ dùng được trong hệ sinh thái AWS. Nếu mai sau muốn chuyển sang Google Cloud hay Azure, bạn phải viết lại nhiều phần — đây là rủi ro "vendor lock-in" (bị phụ thuộc vào một nhà cung cấp).
Ngoài ra, bạn sẽ gặp các khái niệm NoSQL (Not Only SQL — loại database không bắt buộc dữ liệu phải xếp vào bảng cứng như Excel, ví dụ lưu hồ sơ khách hàng dạng JSON — định dạng dữ liệu gọn nhẹ đọc rất giống văn bản). DynamoDB là NoSQL, Cloudant cũng là NoSQL, rất phù hợp với dữ liệu phi cấu trúc (như log hệ thống, bài đăng mạng xã hội, hồ sơ khách hàng). Nếu dữ liệu của bạn có cấu trúc bảng rõ ràng (kiểu bảng lương, danh sách đơn hàng), bạn có thể cân nhắc các database SQL truyền thống cũng có phiên bản cloud như IBM Db2.
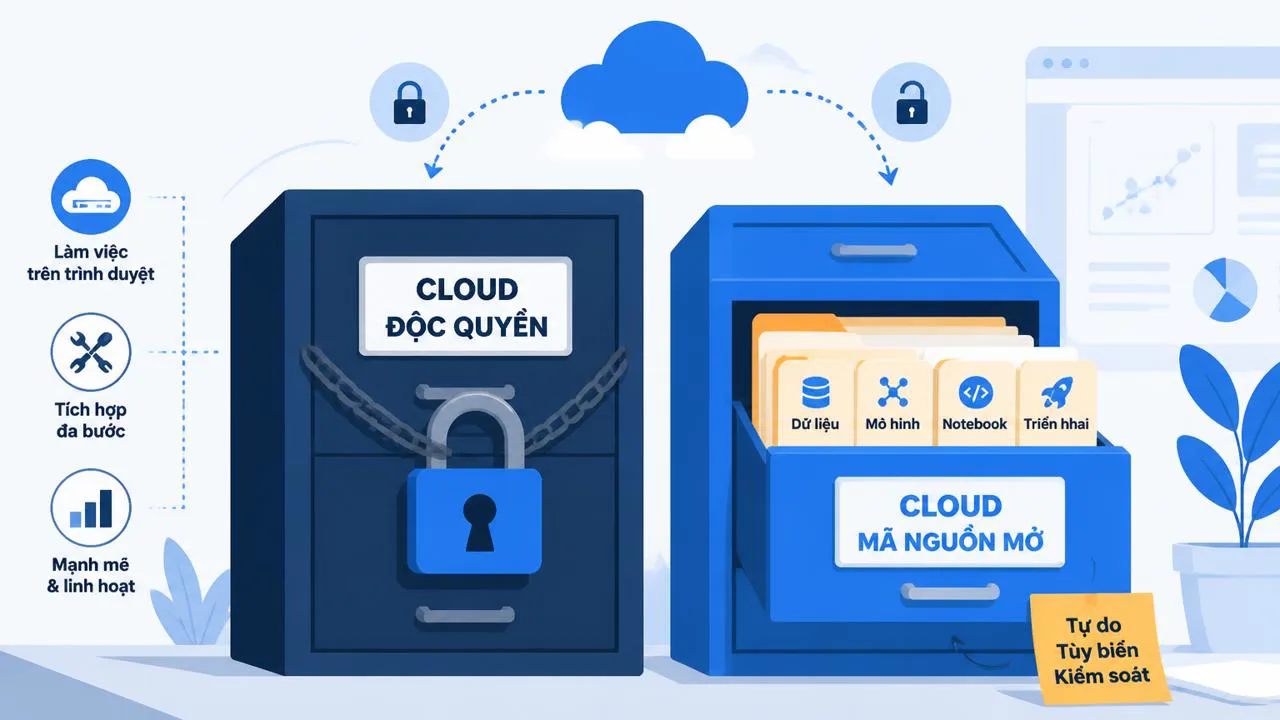
Cloud data integration: ETL và ELT
Sau khi dữ liệu đã ở trên cloud, bạn thường cần gom dữ liệu từ nhiều nguồn (file Excel, database cũ, API bên thứ ba, log hệ thống) về một chỗ để xử lý. Quy trình này có tên gọi phổ biến là ETL hoặc ELT.
- ETL (Extract-Transform-Load): rút dữ liệu ra → làm sạch, lọc, chuẩn hóa → nạp vào kho dữ liệu (data warehouse — nơi tập trung dữ liệu đã chuẩn hóa để phân tích).
- ELT (Extract-Load-Transform): nạp dữ liệu thô vào trước, làm sạch sau — nhờ cloud có sức mạnh tính toán lớn, việc làm sạch sau cũng không chậm.
Công cụ thương mại phổ biến cho bước này trên cloud gồm: Informatica Cloud Data Integration, IBM Data Refinery, Datameer, Talend Cloud, AWS Glue. Đối với SME, hai tên đáng chú ý là Informatica (nhiều năm kinh nghiệm, kết nối hầu hết mọi nguồn dữ liệu) và IBM Data Refinery (chạy gọn trong hệ sinh thái Watson). Nếu bạn muốn đi sâu hơn vào 6 nhóm công cụ data science, bài phân loại 6 nhóm công cụ data science sẽ giúp bạn nhìn tổng quan vị trí của từng nhóm.
Cloud visualization: vẽ biểu đồ và dashboard trên mây
Bước khám phá dữ liệu (exploratory data analysis — phân tích sơ bộ để hiểu dữ liệu trước khi train model) và báo cáo kết quả thường cần biểu đồ, dashboard (bảng điều khiển trực quan nhiều biểu đồ gom lại theo thời gian thực). Cloud visualization là các công cụ vẽ biểu đồ chạy trên cloud — bạn upload dữ liệu lên, chọn loại biểu đồ, hệ thống render (vẽ) trên server và gửi hình ảnh về trình duyệt.
Hầu như nhà cung cấp cloud nào cũng có công cụ visualization riêng. Vài ví dụ đáng chú ý:
- Datameer: giao diện bảng tính quen thuộc, kéo thả để vẽ biểu đồ trên dữ liệu lớn.
- IBM Cognos BI: nền tảng BI (Business Intelligence — trí tuệ kinh doanh, tức công cụ hỗ trợ ra quyết định từ dữ liệu) lâu đời, chuyên cho doanh nghiệp, có phiên bản cloud.
- Biểu đồ có sẵn trong Watson Studio: hỗ trợ bar chart 3D, scatter plot kết hợp heat map (biểu đồ nhiệt — dùng màu sắc để thể hiện mật độ giá trị), tree map (biểu đồ cây — các ô vuông tỷ lệ theo giá trị), word cloud (đám mây từ — chữ to nhỏ theo tần suất).
Nếu bạn cần nắm nguyên tắc chọn biểu đồ cho phù hợp (biểu đồ nào nên dùng khi nào), tham khảo thêm nguyên tắc trực quan hóa dữ liệu. Còn nếu đang so sánh giữa tool thương mại và open-source, bài công cụ thương mại trong data science nói chung sẽ cho bạn góc nhìn rộng hơn.
Cloud model building, deployment và monitoring
Đây là phần "trung tâm" của data science: train mô hình, đưa model vào sử dụng, theo dõi model đang chạy.
Build (xây dựng) model: thay vì train trên laptop, bạn gửi code và dữ liệu lên cloud để cụm máy chủ chạy. Một số platform còn có tính năng AutoML — tự động thử nhiều thuật toán và chọn cái tốt nhất, ví dụ H2O Driverless AI, Watson Machine Learning, Google Vertex AI Training. Bạn không cần biết sâu về từng thuật toán vẫn có model khá dùng được. Tuy nhiên, để hiểu bản chất và tránh chọn sai, bạn nên tham khảo các thuật toán machine learning phổ biến.
Deploy (triển khai) model: sau khi train xong, model cần được đặt lên một nơi để các app khác có thể gọi được. Cách phổ biến nhất là qua REST interface (giao thức giao tiếp web — bạn có thể hình dung như gọi điện cho shipper: bạn gửi yêu cầu qua điện thoại, shipper trả lời). Watson Machine Learning, Azure ML, SageMaker đều cho phép deploy model và tự sinh endpoint (điểm cuối — đường dẫn web cố định để truy vấn model).
Monitor (giám sát) model: model sau khi chạy thực tế có thể bị giảm chất lượng theo thời gian (hiện tượng "model drift" — model lạc hậu khi dữ liệu thực tế thay đổi so với dữ liệu lúc train). Ví dụ: model dự đoán nhu cầu sản phẩm được train trên dữ liệu 2023, đến 2025 dữ liệu khách hàng khác đi, model trở nên thiếu chính xác mà bạn không hay biết. Để tránh điều này, bạn cần công cụ giám sát: AWS SageMaker Model Monitor, IBM Watson OpenScale, Azure ML Model Monitor. Giám sát giúp bạn phát hiện sớm và retrain kịp thời.
Open format PMML và vì sao nó giúp tránh vendor lock-in
Một trong những rủi ro lớn nhất khi dùng cloud tool là vendor lock-in: dữ liệu và model của bạn bị "khóa" trong hệ sinh thái một nhà cung cấp, khó chuyển sang chỗ khác. Để giảm rủi ro, hãy ưu tiên các nền tảng hỗ trợ open format (định dạng mở — chuẩn chung ai cũng đọc được).
PMML (Predictive Model Markup Language — ngôn ngữ đánh dấu mô hình dự đoán) là một định dạng mở phổ biến để xuất model đã train. Nếu bạn dùng SPSS Modeler hoặc một số công cụ của IBM, bạn có thể xuất model ra file PMML. File này có thể import (nhập vào) vào nhiều nền tảng khác mà không phải train lại từ đầu. Đây là cách giữ quyền kiểm soát dữ liệu và model của bạn dù đang dùng cloud của ai.
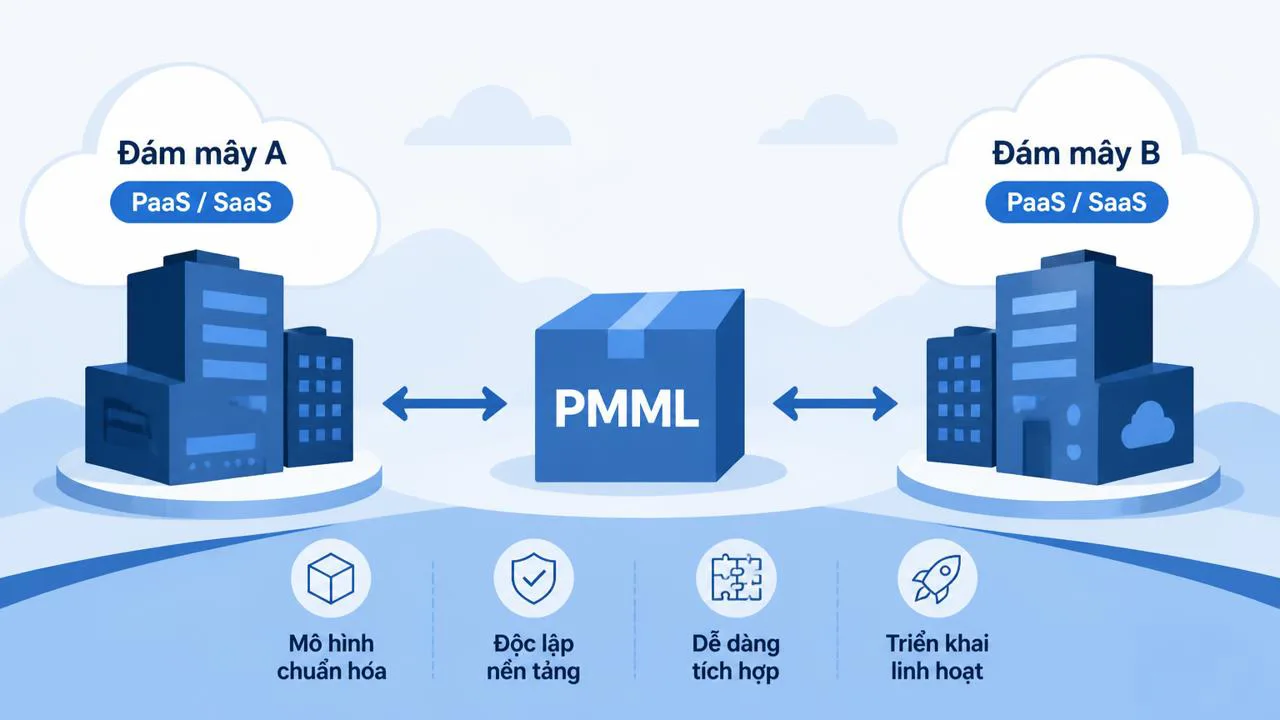
Bảng tóm tắt: cloud tool thương mại phổ biến theo từng nhóm việc
Dưới đây là bảng tham khảo nhanh, mỗi dòng là một công cụ thương mại phổ biến trên cloud theo từng nhóm việc data science. Giá và tính năng thay đổi theo thời gian, bạn nên kiểm tra trang chính hãng trước khi quyết định mua.
| Nhóm việc | Công cụ thương mại phổ biến trên cloud | Ghi chú cho người mới |
|---|---|---|
| Lưu trữ dữ liệu (data management) | IBM Db2, AWS DynamoDB, IBM Cloudant, Google BigQuery, Azure Cosmos DB | Cloudant dựa trên CouchDB mã nguồn mở (dễ chuyển); DynamoDB là độc quyền AWS (dễ bị lock-in) |
| Tích hợp dữ liệu (ETL / ELT) | Informatica Cloud Data Integration, IBM Data Refinery, Datameer, AWS Glue, Talend Cloud | Informatica kết nối nhiều nguồn; Data Refinery chạy trong hệ Watson |
| Trực quan hóa (visualization) | IBM Cognos BI, Datameer, Tableau Online, Power BI, biểu đồ trong Watson Studio | Power BI và Tableau Online quen thuộc với người dùng doanh nghiệp |
| Build model (training) | Watson Machine Learning, Azure Machine Learning, Google Vertex AI, AWS SageMaker, H2O Driverless AI | H2O Driverless AI có AutoML mạnh; Watson ML, Azure ML tích hợp cả build và deploy |
| Giám sát model (monitoring) | AWS SageMaker Model Monitor, IBM Watson OpenScale, Azure ML Model Monitor | Cần thiết để phát hiện model drift sau deploy |
Fully integrated platform (như Watson Studio, Azure ML) tiện cho người mới và SME; single-purpose cloud service (như DynamoDB, Cognos BI) phù hợp khi bạn cần giải pháp chuyên sâu cho một bước cụ thể.
Checklist chọn cloud tool cho người mới
Khi bạn đã hiểu cloud-based tools cho data science là gì và có những nhóm nào, đây là checklist thực tế giúp bạn quyết định nhanh hơn:
- Xác định bạn cần PaaS, SaaS hay one-click: nếu chưa biết quản trị server, chọn SaaS/PaaS có bản dùng thử miễn phí trước.
- Ưu tiên platform tích hợp nhiều bước nếu làm một mình hoặc SME: Watson Studio, Azure ML, Vertex AI giúp bạn có đủ data → train → deploy → monitor trong một chỗ.
- Tránh database độc quyền nếu chưa tính trước chi phí chuyển đổi: nếu dữ liệu có thể lớn dần, cân nhắc dùng database có nguồn gốc mã nguồn mở hoặc hỗ trợ PMML/open format.
- Luôn kèm giám sát model sau deploy: đừng để model "chạy rồi quên".
- Kiểm tra giá và tính năng mới trên trang chính hãng trước khi ký hợp đồng: cloud platform thay đổi giá và tính năng hàng quý, thông tin cũ có thể đã lỗi thời.
Những cảnh báo thường gặp
Có vài "bẫy" mà người mới rất hay vấp khi chọn cloud tool:
- Nhầm one-click deploy với
Tags
- machine learning
- vendor lock-in
- Watson Studio
- Azure ML
- ETL cloud
- SageMaker
- công cụ đám mây
- cloud data science
- Vertex AI
- PaaS SaaS
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.