Data Science
Các Định Dạng File Trong Data Science: CSV, TSV, XLSX, XML, PDF, JSON
Tổng hợp sáu định dạng file phổ biến trong data science — CSV, TSV, XLSX, JSON, XML, PDF — kèm tình huống dùng thực tế, bảng so sánh nhanh và checklist bốn câu hỏi để chọn đúng từ đầu, tránh mất thời gian xử lý.
 Phong Nguyen
PNTECH Writer · 14/09/2026
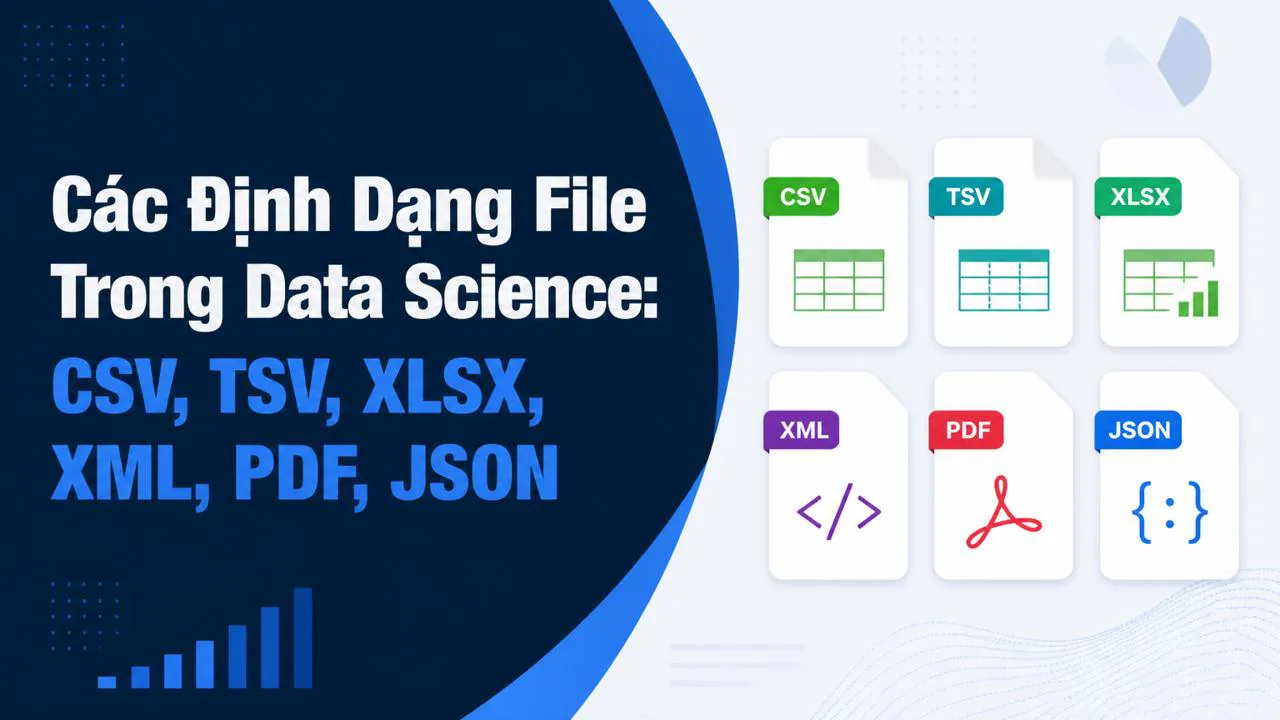
Chọn đúng định dạng file ngay từ đầu sẽ tiết kiệm cả ngày xử lý dữ liệu
Khi mới bắt đầu với data science, nhiều người mất thời gian không phải vì phân tích khó, mà vì mở file sai cách, lưu sai định dạng, hoặc chia sẻ file mà người nhận không đọc được. Một bảng danh sách đơn giản có thể thành hai dạng: mở bằng Excel thì gọn, nhưng gửi cho lập trình viên thì họ cần file CSV. Một báo cáo in đẹp thành PDF thì dễ đọc, nhưng lấy dữ liệu từ PDF để phân tích thì cả ngày chỉ ngồi gõ lại.
Hiểu được các định dạng file trong data science là bước đầu tiên để làm việc với dữ liệu nhẹ nhàng hơn. Bài viết này tổng hợp sáu định dạng thường gặp nhất — CSV, TSV, XLSX, JSON, XML và PDF — kèm tình huống dùng thực tế để bạn chọn đúng từ đầu, không cần đoán mò. Nếu bạn chưa nắm bức tranh lớn về data science là gì và quy trình làm việc ra sao, có thể đọc thêm bài định nghĩa data science và quy trình làm việc với dữ liệu trước khi đi vào chi tiết từng định dạng.
CSV và TSV — Hai định dạng bảng "vạn năng" cho người mới
CSV là viết tắt của Comma-Separated Values, tức "giá trị phân cách bằng dấu phẩy". Hãy tưởng tượng bạn có một danh sách đi chợ ghi trên giấy: trứng, sữa, bánh mì. Dấu phẩy chính là "delimiter" — dấu phân cách — giúp máy hiểu đâu là một ô, đâu là ô kế tiếp. CSV hoạt động đúng theo cách đó: mỗi dòng là một bản ghi, mỗi ô cách nhau bằng dấu phẩy.
Một file CSV điển hình trông như thế này:
ten,tuoi,thanh_pho
An,28,Ha_Noi
Binh,32,Da_Nang
Đây là định dạng được nhắc đến trong chuẩn RFC 4180, rất phổ biến vì gọn nhẹ, mở được bằng hầu hết phần mềm bảng tính và ngôn ngữ lập trình. Khi bạn tải một bộ dữ liệu công khai trên mạng, khả năng cao nó ở dạng CSV.
TSV là phiên bản "anh em" của CSV, nhưng dùng dấu tab (phím Tab trên bàn phím) thay cho dấu phẩy. Khi nào nên chọn TSV? Khi dữ liệu của bạn chứa nhiều dấu phẩy bên trong ô — ví dụ mô tả sản phẩm, địa chỉ đầy đủ — thì CSV sẽ dễ bị nhầm vì máy không biết dấu phẩy nào là phân cách. Dùng TSV sẽ tránh rắc rối này. Tuy nhiên, vì CSV phổ biến hơn nên phần lớn thời gian bạn chỉ cần CSV là đủ.
XLSX — Khi bạn cần làm việc trong Excel
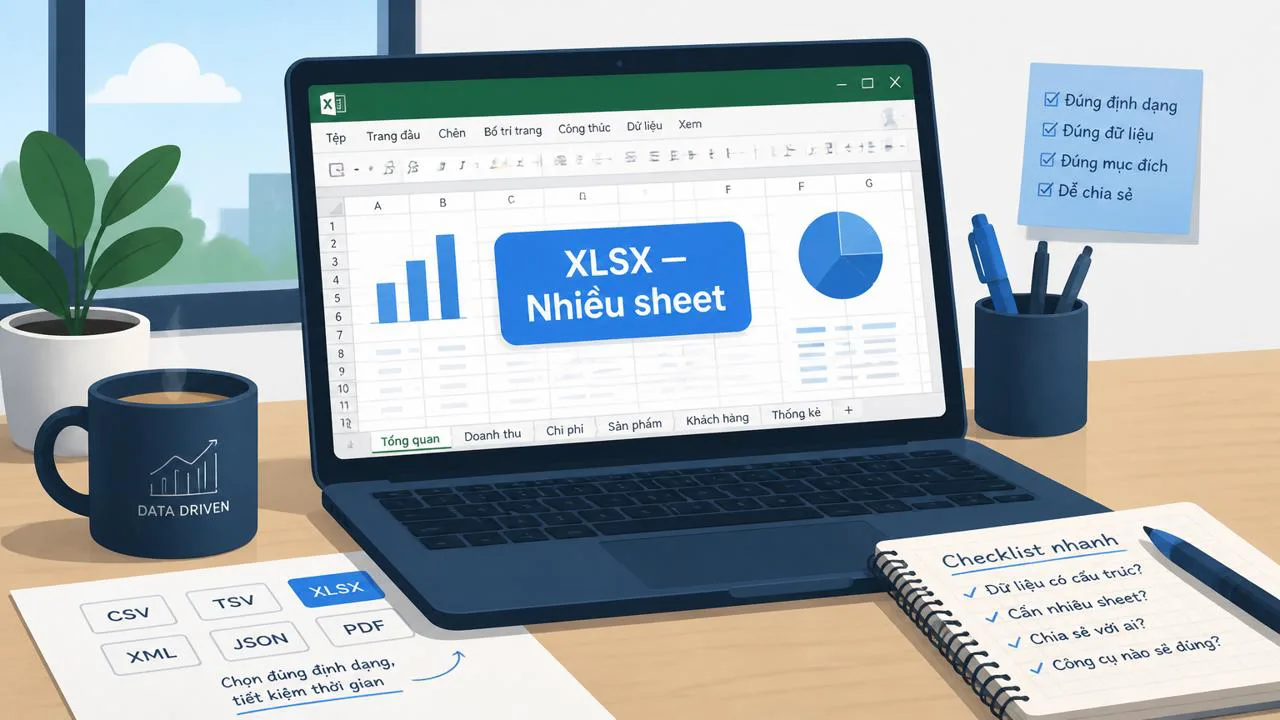
XLSX là định dạng bảng tính mặc định của Microsoft Excel từ phiên bản 2007 trở đi. Khác với CSV chỉ chứa văn bản thuần, XLSX là một gói nén chứa nhiều sheet, công thức, biểu đồ, màu sắc và định dạng ô. Về mặt kỹ thuật, XLSX dựa trên chuẩn Office Open XML Spreadsheet (ECMA-376), tức bên trong nó là một tập hợp các file XML được nén lại — đây là lý do tên gọi có chữ "X" ở cuối.
XLSX rất phù hợp khi bạn chia sẻ báo cáo cho sếp hoặc đồng nghiệp không rành kỹ thuật, vì giao diện Excel quen thuộc. Nhưng XLSX cũng có giới hạn: tối đa khoảng hơn một triệu dòng trên mỗi sheet (con số cụ thể cần kiểm tra lại trong tài liệu Microsoft vì có thể thay đổi theo phiên bản), và khi mở bằng phần mềm khác như Google Sheets hay LibreOffice, một số công thức hoặc định dạng có thể bị lệch. Với dữ liệu lớn hoặc cần xử lý tự động bằng code, thường người ta vẫn chuyển sang CSV hoặc JSON trước khi phân tích.
JSON — Ngôn ngữ chung giữa các hệ thống web
JSON, viết tắt của JavaScript Object Notation, là định dạng trao đổi dữ liệu phổ biến nhất giữa các ứng dụng web và API (API là cầu nối để hai phần mềm nói chuyện với nhau). Nếu CSV là bảng phẳng, thì JSON giống như một tờ phiếu mô tả có cấu trúc rõ ràng: mỗi mục có tên (gọi là key) và giá trị đi kèm (gọi là value). Ví dụ:
{
  "ten": "An",
  "tuoi": 28,
  "sothich": ["doc_sach", "di_bo"]
}
JSON được chuẩn hoá trong RFC 8259 và hỗ trợ cấu trúc lồng nhau — nghĩa là một trường có thể chứa cả một danh sách, hoặc chứa thêm một đối tượng JSON khác bên trong. Đây là điều CSV không làm được. Nhờ vậy, khi bạn gọi một API để lấy dữ liệu thời tiết, danh sách sản phẩm, hay thông tin người dùng, kết quả trả về thường ở dạng JSON.
Khi nào nên dùng JSON? Khi dữ liệu có cấu trúc phân cấp (như đơn hàng có nhiều sản phẩm, mỗi sản phẩm có nhiều thuộc tính), khi làm việc với API, hoặc khi muốn lưu dữ liệu để máy đọc nhanh. Tuy nhiên, JSON không lý tưởng để mở bằng Excel — Excel có thể mở nhưng cấu trúc lồng nhau sẽ bị làm phẳng và khó đọc.
JSON là định dạng sinh ra để máy đọc, không phải để người đọc. Nếu bạn muốn xem nhanh bằng mắt, hãy chuyển sang bảng; nếu muốn hai hệ thống trao đổi, cứ để JSON.
XML — "Anh cả" trong trao đổi dữ liệu doanh nghiệp
XML, viết tắt của Extensible Markup Language, là định dạng được W3C khuyến nghị từ cuối những năm 1990. Nếu JSON giống tờ phiếu có key–value, XML giống một sơ đồ cây với các thẻ mở và thẻ đóng. Một file XML điển hình có dạng:
<nguoi_dung>
  <ten>An</ten>
  <tuoi>28</tuoi>
</nguoi_dung>
XML rất phổ biến trong các hệ thống cũ của doanh nghiệp, ngân hàng, viễn thông, và trong các chuẩn như SOAP, RSS, file cấu hình phần mềm. So với JSON, XML dài dòng hơn nhưng hỗ trợ schema (bản mô tả cấu trúc) chặt chẽ hơn, nên vẫn được dùng ở những nơi cần kiểm tra dữ liệu nghiêm ngặt. Với người mới học data science, bạn sẽ gặp XML chủ yếu khi làm việc với dữ liệu cũ hoặc feed tin tức.
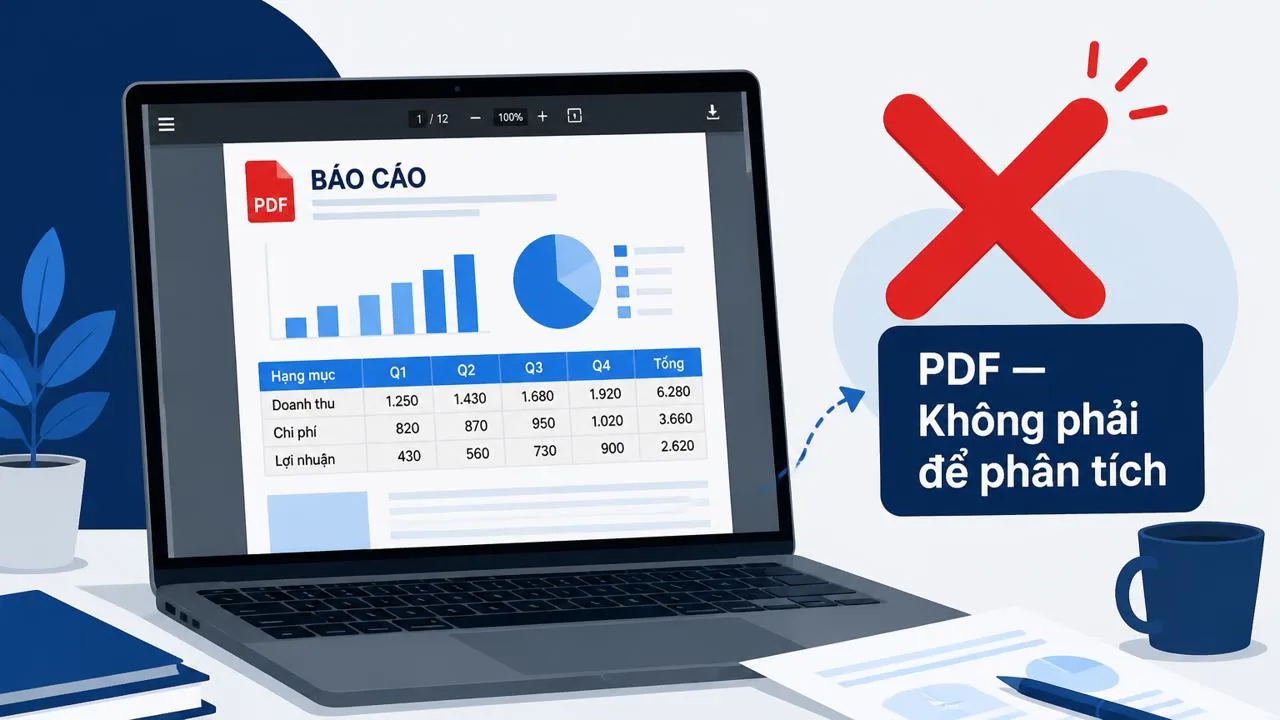
PDF — Đẹp để đọc, nhưng không phải để phân tích
PDF, viết tắt của Portable Document Format, được Adobe phát triển và hiện là chuẩn ISO 32000. Mục đích ban đầu của PDF rất rõ ràng: tạo một file hiển thị giống nhau trên mọi máy tính, mọi hệ điều hành, không lệch font, không xô lệch layout. Nhờ vậy, báo cáo, hợp đồng, sách điện tử gần như luôn ở dạng PDF.
Nhưng trong data science, PDF không phải là nguồn dữ liệu lý tưởng. Vì PDF được thiết kế để con người đọc chứ không phải để máy phân tích, nên việc trích xuất bảng số từ PDF thường mất thời gian và kết quả hay sai lệch. Chỉ nên dùng PDF khi bạn cần đọc hiểu nội dung hoặc đính kèm báo cáo cuối cùng. Khi muốn phân tích, hãy tìm file gốc ở CSV, XLSX hoặc JSON.
Bảng so sánh nhanh sáu định dạng
Dưới đây là bảng tóm tắt để bạn tra nhanh khi cần quyết định:
| Định dạng | Dùng cho việc gì | Ưu điểm | Nhược điểm | Mở bằng gì |
|---|---|---|---|---|
| CSV | Bảng phẳng, chia sẻ dữ liệu đơn giản | Gọn nhẹ, phổ biến, mọi phần mềm đọc được | Không hỗ trợ cấu trúc lồng nhau, dễ lỗi encoding | Excel, Google Sheets, LibreOffice, code |
| TSV | Bảng có nhiều dấu phẩy trong ô | Tránh xung đột dấu phẩy | Ít phổ biến hơn CSV, khó nhìn bằng mắt | Excel, Google Sheets, code |
| XLSX | Báo cáo nhiều sheet, công thức, biểu đồ | Quen thuộc với người làm văn phòng | Giới hạn dòng, có thể lệch khi mở bằng tool khác | Excel, Google Sheets, LibreOffice |
| JSON | Trao đổi dữ liệu giữa web và API | Cấu trúc lồng nhau, máy đọc nhanh | Khó đọc bằng mắt, mở bằng Excel không tiện | Trình duyệt, VS Code, code |
| XML | Hệ thống cũ, chuẩn doanh nghiệp | Có schema kiểm tra chặt, cấu trúc rõ | Dài dòng, ít dùng trong dự án mới | Trình duyệt, VS Code, code |
| Báo cáo, hợp đồng, tài liệu in | Hiển thị giống nhau mọi nơi | Khó trích xuất dữ liệu để phân tích | Adobe Reader, trình duyệt, Foxit |
Lỗi thường gặp khi chọn định dạng
Sai định dạng không phải lúc nào cũng rõ ràng ngay, nhưng sẽ "đẻ" ra một loạt rắc rối về sau. Dưới đây là những lỗi phổ biến nhất mà người mới hay mắc phải.
Thứ nhất, lưu CSV bằng Excel tiếng Việt dễ lệch encoding. Excel mặc định có thể dùng encoding khác UTF-8, khiến tiếng Việt bị lỗi font khi mở ở máy khác hoặc bằng code. Cách xử lý: khi lưu, chọn "CSV UTF-8 (Comma delimited)" trong Excel, hoặc dùng Google Sheets tải về CSV vì Google Sheets mặc định xuất UTF-8.
Thứ hai, dùng PDF để phân tích = tự làm khó mình. Nếu dữ liệu gốc có sẵn ở dạng bảng, đừng cố scrape (trích xuất thủ công) từ PDF trừ khi không còn lựa chọn nào khác. Thời gian gõ lại và sửa lỗi có khi còn lâu hơn việc nhờ bên phát hành cung cấp file gốc.
Thứ ba, gửi XLSX cho lập trình viên khi CSV là đủ. Lập trình viên thường cần file phẳng, dễ đọc bằng code. XLSX buộc họ phải cài thư viện xử lý và đôi khi công thức bị lệch. CSV sẽ là lựa chọn an toàn hơn.
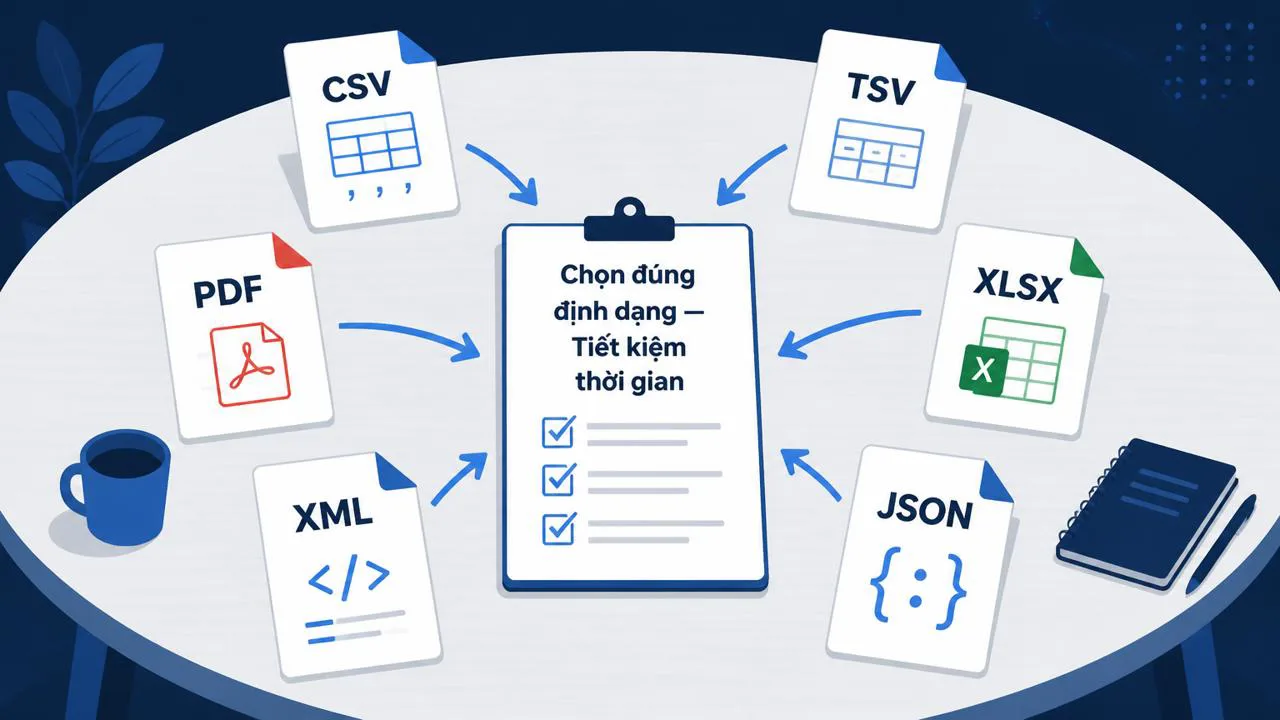
Trước khi chọn định dạng, hãy hỏi bốn câu: ai sẽ đọc, dùng để phân tích hay chỉ để xem, dữ liệu có cấu trúc lồng nhau không, và dung lượng khoảng bao nhiêu.
Checklist bốn câu hỏi trước khi chọn định dạng:
- Ai sẽ đọc? Sếp/đồng nghiệp không rành kỹ thuật → XLSX hoặc PDF. Lập trình viên hoặc hệ thống khác → CSV, JSON, XML.
- Dùng để phân tích hay chỉ chia sẻ? Phân tích → CSV, JSON, XLSX. Chia sẻ/đọc hiểu → PDF.
- Có cấu trúc lồng nhau không? Có → JSON hoặc XML. Không, chỉ là bảng phẳng → CSV hoặc XLSX.
- Dung lượng bao nhiêu? Vài MB đổ lại → CSV/XLSX thoải mái. Vài chục MB trở lên hoặc nhiều bản ghi → cân nhắc CSV nén (gzip) hoặc Parquet.
Sau khi đã chọn được định dạng phù hợp và mở file thành công, bước tiếp theo thường là làm sạch dữ liệu — loại bỏ giá trị thiếu, chuẩn hoá định dạng ngày tháng, xử lý trùng lặp. Bạn có thể tham khảo bài cách làm sạch và chuẩn hoá dữ liệu sau khi mở file để biết làm tiếp như thế nào. Còn nếu bạn muốn bắt tay vào thực hành với Python, bài đọc và xử lý CSV/JSON bằng Pandas trong Python sẽ hướng dẫn từng bước từ đọc file đến phân tích đầu tiên.
Tóm tắt một phút
CSV và TSV cho bảng phẳng, gọn nhẹ, phổ biến nhất. XLSX cho báo cáo nhiều sheet và công thức trong Excel. JSON và XML cho việc trao đổi dữ liệu giữa các hệ thống, đặc biệt khi có cấu trúc lồng nhau — JSON phổ biến trong web hiện đại, XML còn dùng nhiều trong hệ thống cũ. PDF dùng để in và chia sẻ báo cáo, không phải nguồn dữ liệu để phân tích. Khi phân vân, hãy quay lại bốn câu hỏi trong checklist ở trên — chúng sẽ giúp bạn chọn đúng trong hầu hết tình huống thực tế.
Tags
- Pandas
- data science
- định dạng file
- CSV
- JSON
- làm sạch dữ liệu
- XLSX
- XML
Câu hỏi thường gặp
Tiếp theo
Xem phần mềm — hoặc nhận tư vấn
Đọc xong thì chọn: phần mềm PN, công cụ khuyên dùng, hoặc nhờ mình làm theo nhu cầu.