Data Science
Data Science Skills & Big Data: Bài Học Từ Sự Nghiệp Của Giáo Sư Norman White
Tự học data science không khó nếu đi đúng thứ tự: dùng môi trường chuẩn chung, học Linux → Python → SQL → Pandas → Big Data, và làm dự án thật mỗi tuần thay vì chờ học xong mới làm.
 Phong Nguyen
PNTECH Writer · 18/09/2026
Nếu bạn đang phân vân "học data science cần những kỹ năng gì, bắt đầu từ đâu", thì một giáo sư đã dành nhiều năm dạy và nghiên cứu về lĩnh vực này có một câu trả lời khá rõ: cứ bắt tay vào tự học, dùng môi trường chuẩn chung cho cả lớp, rồi đi theo một chuỗi kỹ năng từ đơn giản đến nâng cao. Bài viết này tổng hợp lại lộ trình đó — đúc từ kinh nghiệm của Giáo sư Norman White — để bạn có thể bắt đầu ngay hôm nay mà không bị lạc hướng.
Bắt đầu từ số không và tự học là bình thường
Giáo sư Norman White từng học Applied Physics (vật lý ứng dụng) trước khi chuyển sang lập trình, rồi mới học thêm về kinh tế, thống kê và ứng dụng máy tính ở IBM. Nghĩa là ông không khởi đầu với tấm bằng "data scientist" — ông tự lắp ghép kiến thức qua từng giai đoạn làm việc.
Điều này có hai ý nghĩa thực tế cho người mới. Một, bạn không cần phải biết trước mọi thuật ngữ (như "machine learning", "data pipeline"...). Hai, thói quen tự học liên tục quan trọng hơn "học giỏi ngay lần đầu". Khi công cụ đổi — và data science đổi rất nhanh — ai biết cách tự dò tài liệu, tự cài phần mềm, tự sửa lỗi sẽ đi xa hơn [S1][S2].
Không ai bắt đầu với tất cả mọi thứ. Tự học không phải điểm yếu, mà là cách vào nghề.
Môi trường học chuẩn hoá: ai cũng dùng được, không lo máy yếu
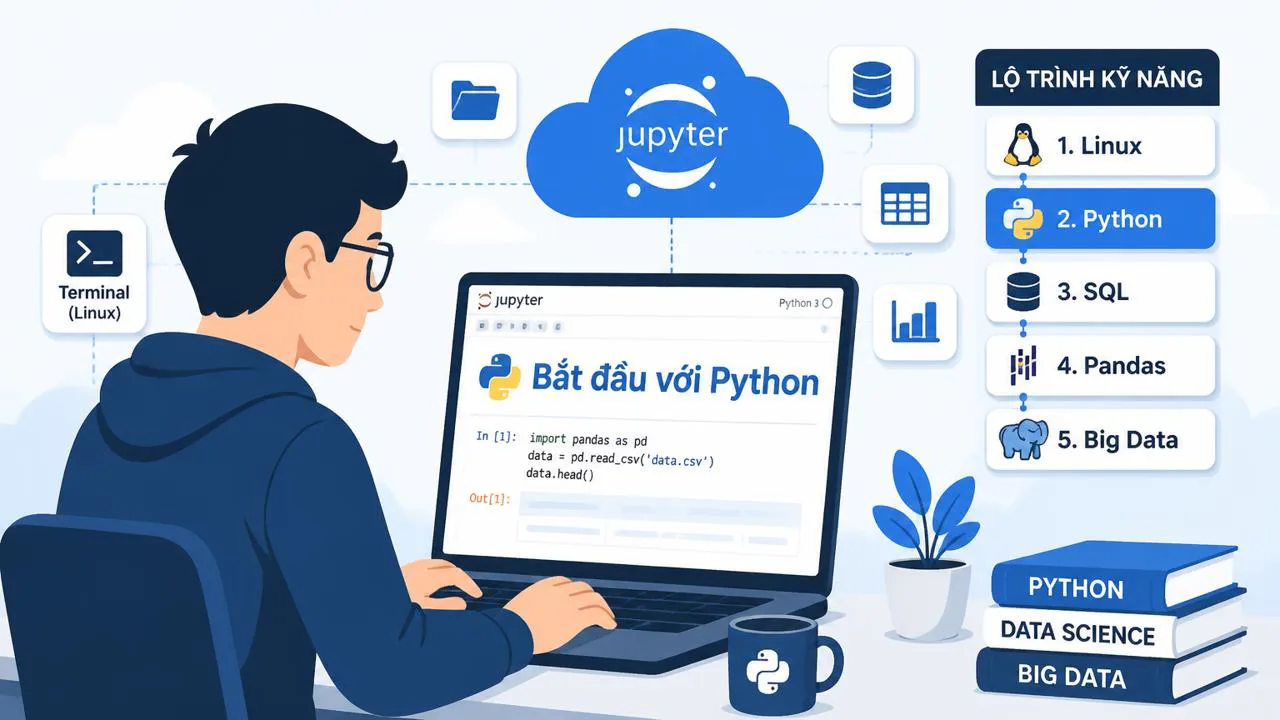
Một trong những điểm tinh tế trong cách dạy của Giáo sư White là chuẩn hoá ngay từ đầu. Cụ thể, ông cho cả lớp dùng chung một môi trường chạy code trên đám mây, ví dụ như Jupyter notebook trên AWS — bạn có thể hình dung nó như một "phòng lab trực tuyến", mở trình duyệt là vào được, phần mềm đã cài sẵn.
Ví dụ đời thường: tưởng tượng giáo viên phát cho cả lớp cùng một bộ đồ nghề đã chuẩn bị sẵn. Học sinh mở hộp ra là bắt tay vào làm, không phải đi mua kìm, mua tua-vít cho khớp. Cũng không có chuyện "nhóm A dùng Windows, nhóm B dùng Mac, nhóm C cài lỗi" — ai cũng thấy cùng một giao diện, chạy cùng một dòng lệnh ra cùng một kết quả.
Lợi ích rất rõ với người tự học: bạn tiết kiệm hàng giờ chỉ để cài đặt, và dành thời gian cho phần quan trọng — viết code, chạy thử, đọc kết quả. Nếu bạn đang bắt đầu một mình, hãy tìm một môi trường tương tự (Google Colab, Kaggle Notebooks...) trước khi cài Python trên máy cá nhân.
Chuỗi kỹ năng đi từ nền tảng đến Big Data
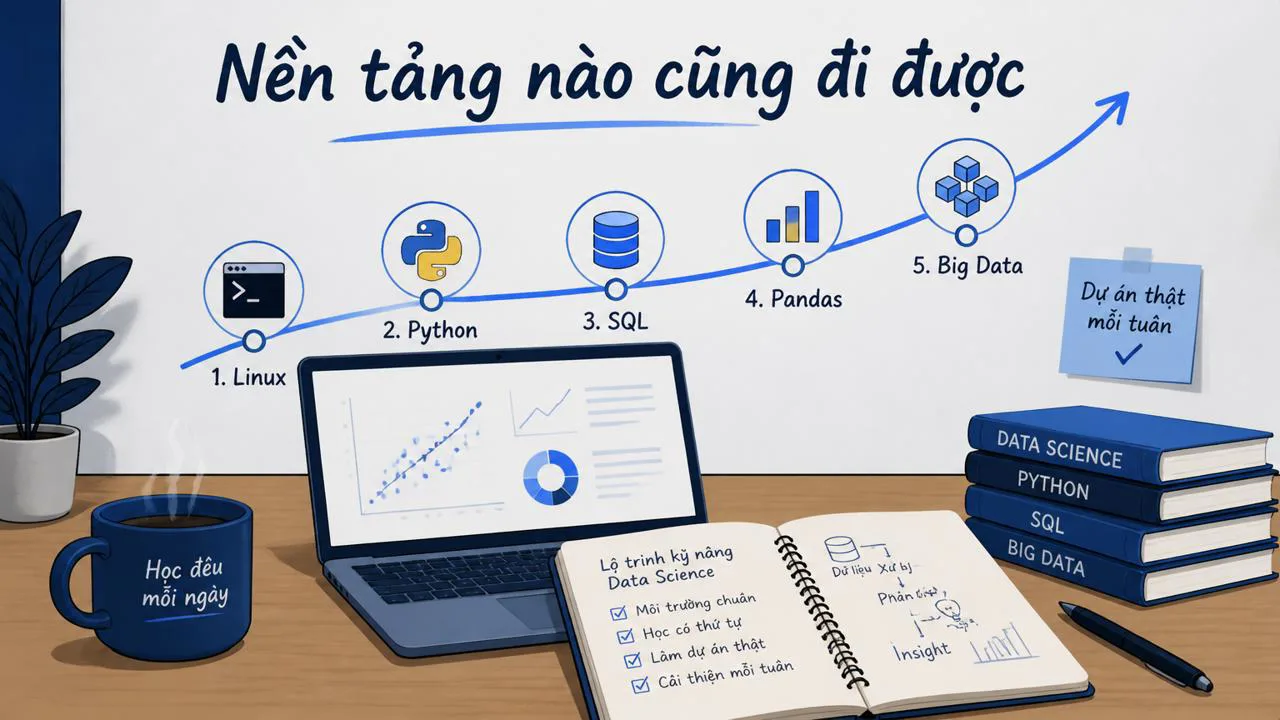
Khi môi trường đã ổn, việc tiếp theo là chọn đúng thứ tự học. Giáo sư White gợi ý một chuỗi khá cụ thể: Linux/Unix cơ bản → Python → cơ sở dữ liệu quan hệ → Pandas → Big Data. Mỗi mắt xích đều có lý do.
Linux/Unix cơ bản: làm quen với "dòng lệnh"
Hầu hết máy chủ và hệ thống dữ liệu lớn chạy trên Linux. "Dòng lệnh" (command line) là cách bạn gõ chữ để máy thực hiện thay vì bấm chuột vào biểu tượng. Ví dụ thay vì kéo cửa sổ để mở thư mục, bạn gõ ls để xem danh sách file. Nghe có vẻ cũ kỹ, nhưng đây là kỹ năng nền: khi dữ liệu lớn, bạn sẽ dùng dòng lệnh để chạy script, đẩy file lên đám mây, xem log lỗi — không có chuột nào để bấm trên máy chủ từ xa.
Python: ngôn ngữ phổ biến nhất cho phân tích dữ liệu
Python được chọn vì cú pháp gần tiếng Anh, dễ đọc. Một dòng code đơn giản có thể lọc, tính tổng, vẽ biểu đồ. Cộng đồng rất lớn, nên hỏi gì cũng có người trả lời — đây là điểm cộng lớn cho người tự học. Nếu bạn mới hoàn toàn, bắt đầu bằng cách chạy thử vài đoạn code ngắn trên notebook trực tuyến là đủ [S4][S5].
Cơ sở dữ liệu quan hệ: dữ liệu xếp vào bảng
Dữ liệu trong doanh nghiệp thường nằm trong cơ sở dữ liệu quan hệ — tức là xếp vào các bảng có hàng và cột, giống một bảng Excel nhưng chặt chẽ hơn nhiều (có khoá chính, có quan hệ giữa các bảng). Ví dụ: bảng "khách hàng" có mã, tên, email; bảng "đơn hàng" có mã đơn, mã khách, ngày mua. Khi muốn biết "khách nào mua nhiều nhất tháng 9", bạn ghép hai bảng lại rồi tính. Học ít nhất một công cụ cơ sở dữ liệu quan hệ (SQL là chuẩn chung) và đọc thêm về cách truy vấn là đủ làm nền [S2].
Pandas: "bàn làm việc" cho dữ liệu trong Python
Pandas là thư viện (tập code viết sẵn) của Python, chuyên xử lý dữ liệu dạng bảng. Bạn có thể tưởng tượng nó như một "bàn làm việc" thông minh: đưa bảng dữ liệu vào, lọc hàng, gộp cột, tính trung bình, xuất ra file — tất cả bằng vài dòng lệnh. Đây là mảnh ghép bạn sẽ dùng nhiều nhất ở giai đoạn đầu, và đã được hướng dẫn chi tiết trong Phân tích dữ liệu với Pandas.
Đi theo thứ tự: nền tảng trước, công cụ sau. Nhảy vào Big Data khi chưa quen Pandas là cách học dễ nản nhất.
Big Data: khi một máy không đủ
Khi dữ liệu lớn đến mức một máy tính cá nhân không chứa nổi hoặc chạy quá lâu, bạn cần cách khác: chia việc cho nhiều máy cùng làm. Đó là lúc Big Data xuất hiện. Hai công cụ hay được nhắc đến là Hadoop (chia dữ liệu và xử lý phân tán) và Spark (xử lý nhanh hơn, thân thiện với Python). Bạn chưa cần học sâu ngay — chỉ cần hiểu ý tưởng, làm quen một ví dụ nhỏ, rồi đào sâu khi thực sự cần. Hướng dẫn chi tiết có trong Big Data với Hadoop và Spark.
Kỹ năng mềm: học đi đôi với làm thật
Kỹ năng kỹ thuật chỉ chiếm một nửa câu chuyện. Nửa còn lại là cách bạn làm việc. Giáo sư White nhấn mạnh vài điểm mà người mới hay bỏ qua.
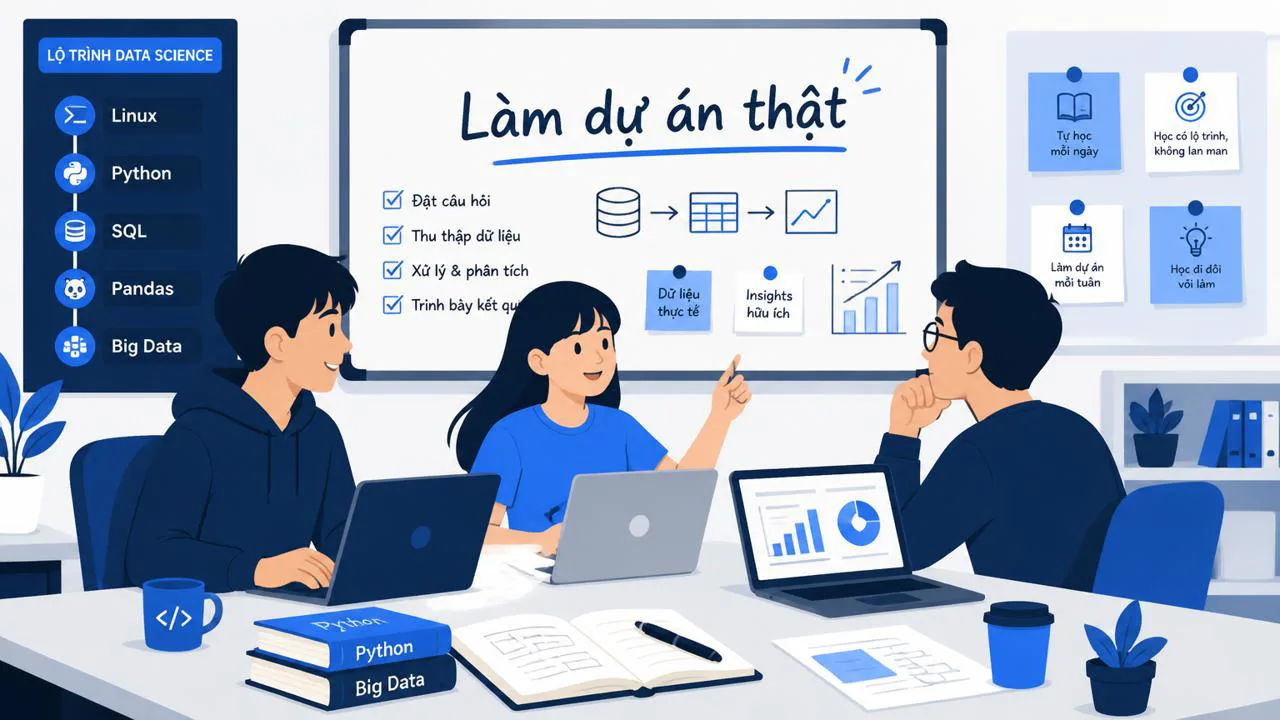
Thứ nhất, làm bài tập hàng tuần đều đặn. Mỗi tuần làm một bài nhỏ giữ nhịp tốt hơn cả việc dồn ôn cuối kỳ. Thứ hai, làm dự án nhóm cuối khoá — buộc bạn đụng vấn đề thật (dữ liệu bẩn, deadline, chia việc) thay vì chỉ đọc lý thuyết. Thứ ba, biết dùng hạ tầng chung thay vì gồng một mình. Các trường đại học thường có tài khoản đám mây giáo dục hoặc phòng máy chuyên dụng — sinh viên nên tận dụng, vì đây là nguồn lực mà sau này doanh nghiệp cũng dùng.
Bắt đầu thực tế: checklist năm bước
Lấy cảm hứng từ chuỗi kỹ năng trên, dưới đây là năm việc cụ thể bạn có thể làm trong tuần tới — không cần cài gì phức tạp, không cần máy xịn.
| Bước | Làm gì | Đầu ra mong đợi |
|---|---|---|
| 1 | Mở notebook trực tuyến (Colab/Kaggle), in dòng "Hello" | Chạy được dòng code đầu tiên, xác nhận môi trường hoạt động |
| 2 | Học 5 lệnh Linux: ls, cd, mkdir, rm, cp | Di chuyển file, tạo thư mục bằng dòng lệnh |
| 3 | Tải một file CSV mẫu, mở bằng Pandas, in 5 dòng đầu | Quen thao tác với bảng dữ liệu thật |
| 4 | Chạy thử một bài Spark mini trên Colab hoặc EMR | Hiểu cách lệnh chạy trên nhiều máy thay vì một máy |
| 5 | Chọn một câu hỏi đời thường (ví dụ: tháng nào bán nhiều quần áo nhất?) và mổ xẻ từ dữ liệu công khai | Có sản phẩm nhỏ để kể lại trong portfolio |
Mỗi bước có thể gọn trong vài giờ. Chìa khoá là đi đều, không cần hiểu hết ngay lần đầu. Kỹ năng data science tích luỹ qua việc làm, không phải qua việc đọc xong rồi đóng sách [S4][S5].
Hạ tầng chung: khi nào nên dùng, khi nào đủ tự xử
Một quan điểm đáng chú ý từ Giáo sư White là không phải lúc nào cũng tự làm. Với dữ liệu nhỏ, một chiếc laptop là đủ. Khi dữ liệu lớn dần, hoặc khi cần chạy mô hình nặng (train machine learning lâu), bạn nên chuyển sang dịch vụ đám mây hoặc dùng phần cứng chuyên dụng. Với doanh nghiệp nhỏ, đây là cách tiết kiệm chi phí: trả theo lượng dùng, không phải mua máy chủ đặt trong kho.
Biết nhờ hạ tầng chung không phải yếu — đó là cách người làm thật tiết kiệm thời gian và tiền.
Lưu ý nhỏ: giá các dịch vụ đám mây thay đổi theo chính sách nhà cung cấp. Trước khi đăng ký gói trả phí, hãy kiểm tra trang chính hãng để biết mức giá và chương trình miễn phí hiện tại — đặc biệt nếu bạn là sinh viên hoặc mới khởi nghiệp [S1][S6].
Nếu bạn đã có nền tảng khác, đừng phí nó
Câu chuyện của Giáo sư White cho thấy ngành data science không "sản xuất" từ một khuôn mẫu. Người có nền vật lý, kinh tế, kế toán, marketing — đều có thể tự học thêm Python và SQL rồi chuyển hướng. Cái bạn đã biết ở lĩnh vực cũ chính là "domain knowledge" (hiểu nghiệp vụ) mà nhiều người học data science thuần kỹ thuật phải mất thời gian lắp vào. Tận dụng nó là lợi thế thật sự [S3].
Ngược lại, nếu bạn là sinh viên công nghệ thuần, đừng quên bồi phần "hiểu nghiệp vụ" — hỏi chuyên gia marketing, bán hàng, tài chính... xem họ ra quyết định dựa trên dữ liệu nào. Phần mềm chỉ là công cụ, hiểu vấn đề mới là giá trị.
Tóm lại và bước tiếp theo
Từ trải nghiệm của Giáo sư Norman White, có thể rút ra một lộ trình khá rõ cho người mới: chấp nhận tự học, dùng môi trường chuẩn chung để bớt cản trở kỹ thuật, đi theo chuỗi Linux → Python → cơ sở dữ liệu quan hệ → Pandas → Big Data, đồng thời luyện kỹ năng mềm qua dự án thật. Kỹ năng data science không phải tài năng bẩm sinh, mà là kết quả của việc làm đều, làm nhiều lần [S2][S4].
Nếu bạn muốn hình dung tổng thể, đọc thêm Data Science là gì để nắm khái niệm, hoặc Lộ trình học Data Science cho người mới để so sánh với lộ trình tổng quát. Khi đã có nền tảng, bạn có thể bắt đầu làm việc thực tế với Mastering Data Science — hướng dẫn toàn tập.
Một gợi ý nhỏ để kết thúc: đừng đợi "học xong mới làm". Mở notebook, tải một bảng dữ liệu công khai, và đặt câu hỏi đầu tiên — chính câu hỏi đó sẽ kéo bạn đi qua từng kỹ năng cần thiết.
Tags
- học lập trình
- Linux cơ bản
- kỹ năng phân tích dữ liệu
- Big Data
- data science
- tự học data science
- python cho người mới
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.