Data Science
Data Collection Trong Data Science: Thu Thập Dữ Liệu Theo Vòng Lặp, Không Làm Một Lần
Data Collection trong data science là vòng lặp, không phải việc làm một lần. Bài hướng dẫn 7 bước thu thập, cách đánh giá chất lượng sơ bộ, nguyên tắc hoãn lấy khi nguồn chưa sẵn, và vai trò phối hợp giữa Data Scientist, DBA, lập trình viên.
 Phong Nguyen
PNTECH Writer · 22/09/2026
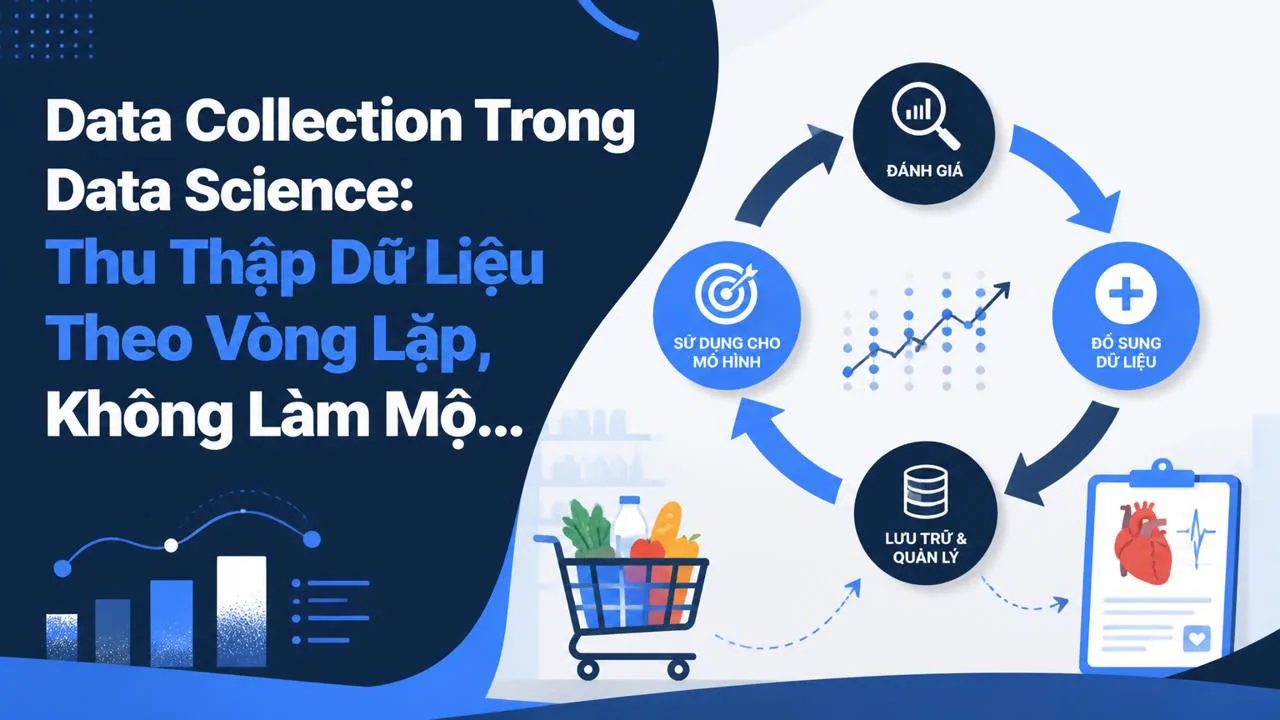
Bạn đã xác định xong yêu cầu dữ liệu ở bước trước — tức là đã biết cần mua gì cho bữa nấu hôm nay. Bước tiếp theo mang tên Data Collection, nhưng đừng hiểu đơn giản là "cứ lấy tất cả về đã". Đây là lúc bạn đi chợ thật: chọn đúng quầy, đúng chất lượng, và sẵn sàng quay lại nếu thấy thiếu món. Đúng cách, bạn sẽ có tập dữ liệu đủ tốt để bước Data Understanding phía sau diễn ra suôn sẻ. Làm sai, bạn sẽ vừa tốn thời gian vừa nghẹn ở những bước kế tiếp.
Bài viết này giải thích Data Collection theo cách đời thường nhất có thể — không cần biết trước thuật ngữ data science. Bạn đọc xong sẽ hiểu vì sao đây là vòng lặp chứ không phải việc làm một lần, khi nào nên hoãn lấy thêm dữ liệu, và cần phối hợp với ai trong lúc thu thập.
Data Collection đứng ở đâu trong quy trình data science
Trong bản đồ 10 giai đoạn Data Science Methodology (do John Rollins tại IBM đề xuất), Data Collection nằm ngay sau Data Requirements — bước lên danh sách dữ liệu cần thu thập và ngay trước Data Understanding. Tóm gọn:
- Data Requirements trả lời câu hỏi "cần dữ liệu gì, để giải bài toán nào".
- Data Collection đi lấy dữ liệu đó, kèm đánh giá sơ bộ chất lượng.
- Data Understanding phân tích kỹ hơn trước khi chạy mô hình.
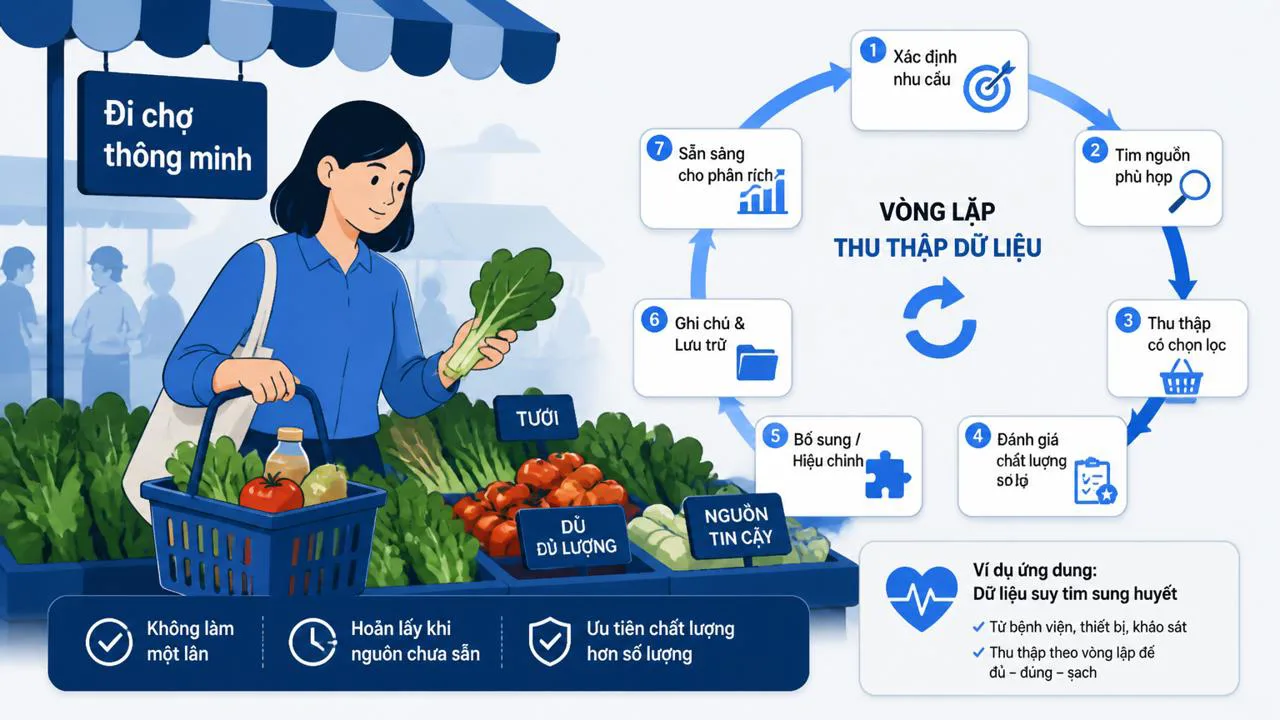
Nếu ví quy trình data science như nấu một bữa cơm, thì Data Requirements là lên thực đơn, Data Collection là phi ra chợ mua đồ. Mua xong mà không kiểm tra lại, bạn sẽ phát hiện thiếu hành, thừa ngò, hay có cọng rau héo ngay khi bắt đầu sơ chế. Đó là lý do phải đánh giá ngay từ lúc thu thập.
Một điểm dễ nhầm: "Data Collection" ở đây là giai đoạn trong methodology tổng quát, không trùng với bước "chọn dữ liệu" trong quy trình 7 bước của Data Mining. Bạn có thể đọc thêm về quy trình đó tại Data Mining — quy trình 7 bước từ dữ liệu thô đến quyết định để phân biệt. Còn nếu muốn nắm tổng thể 10 giai đoạn, tham khảo Data Science Methodology — bản đồ 10 giai đoạn.
Vì sao Data Collection là vòng lặp, không phải bước một lần
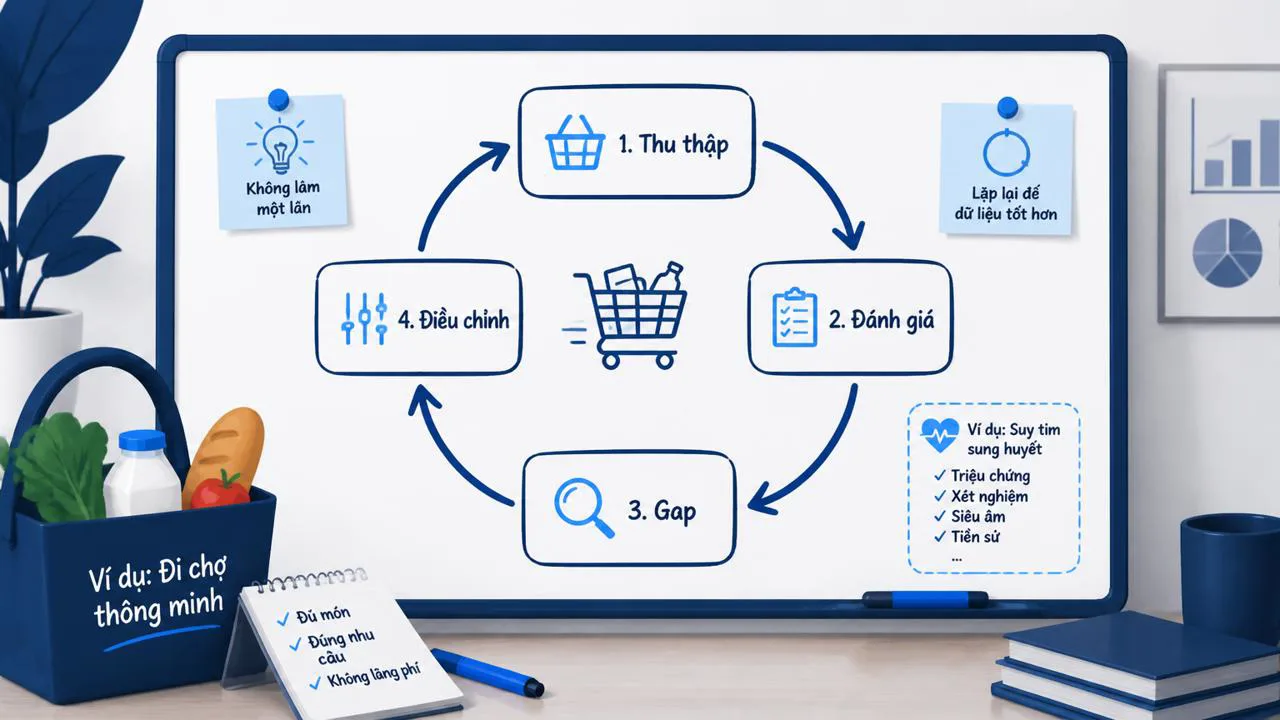
Nhiều người mới học tưởng Data Collection giống "viết SQL một phát là xong". Thực tế rất khác: bạn thu thập xong, nhìn lại, thấy thiếu — rồi quay lại lấy thêm. Hoặc phát hiện thừa — rồi quay lại lược bớt. Đó là lý do nó được vẽ thành vòng lặp chứ không phải mũi tên đi thẳng.
Cụ thể, vòng lặp gồm bốn nhịp:
- Thu thập dữ liệu thô từ các nguồn đã chốt ở bước trước.
- Đánh giá sơ bộ bằng thống kê mô tả và biểu đồ để xem dữ liệu có đúng kỳ vọng không.
- Phát hiện khoảng trống (gap) — thiếu biến, thiếu nhóm đối tượng, hoặc dư những cột trùng nội dung.
- Quay lại Data Requirements để điều chỉnh danh sách cần lấy, rồi thu thập lại.
Hệ quả quan trọng: ngân sách và thời gian dành cho Data Collection không "nuốt trọn" một lần. Bạn có thể dừng vòng lặp sớm nếu dữ liệu hiện có đã đủ tốt cho bước tiếp theo — và đó chính là nguyên tắc "hoãn lấy khi chưa chắc cần" mình sẽ nói ở phần sau.
Hai kỹ thuật đánh giá dữ liệu ban đầu
Đánh giá sơ bộ ở đây không yêu cầu bạn biết lập trình hay xây dựng mô hình. Hai kỹ thuật cốt lõi ai cũng có thể hiểu:
Thứ nhất, thống kê mô tả (descriptive statistics — tức những con số tóm tắt dữ liệu). Bạn chỉ cần nhìn vài chỉ số quen thuộc: trung bình (mean), trung vị (median — giá trị nằm giữa khi sắp xếp), nhỏ nhất, lớn nhất, và số lượng giá trị bị trống trong mỗi cột. Ví dụ: cột "tuổi bệnh nhân" có trung bình 62, nhưng lại xuất hiện vài giá trị 200 — rõ ràng có lỗi nhập liệu, và bạn cần quay lại xử lý.
Thứ hai, trực quan hóa dữ liệu (visualization — vẽ thành biểu đồ). Một biểu đồ phân tán hoặc histogram (biểu đồ tần suất) có thể cho thấy ngay những mẫu bất thường — như một nhóm điểm tách hẳn khỏi phần còn lại (gọi là outlier — giá trị "lạc" so với đám đông), hay phân phối bị lệch hẳn về một phía. Mắt thường phát hiện cái bất thường nhanh hơn bảng số rất nhiều.
Hai kỹ thuật này bổ sung cho nhau: thống kê mô tả cho bạn biết "có gì đó sai", còn biểu đồ giúp bạn chỉ ra "nó sai ở đâu, sai kiểu nào". Cả hai cùng được dùng song song trong Data Collection, không phải thay thế nhau.
Thu thập dữ liệu không phải lấy cho đầy kho — mà là lấy đúng thứ, đủ chất lượng, và biết dừng lại khi đã đủ.
Quy trình 7 bước để thu thập dữ liệu trong data science
Mình tách thành 7 bước để bạn dễ theo dõi. Mỗi bước có một câu hỏi tự kiểm tra cuối đoạn.
Bước 1 — Xác định nguồn dữ liệu. Dựa trên danh sách ở Data Requirements, bạn liệt kê đâu là nguồn chính (ví dụ: hệ thống CRM nội bộ), đâu là nguồn phụ (ví dụ: file Excel phòng kế toán gửi hàng tháng). Câu hỏi: bạn đã biết chính xác lấy từ đâu, ai giữ dữ liệu đó chưa?
Bước 2 — Thu thập dữ liệu thô. Giai đoạn này cần DBA (Database Administrator — người quản trị cơ sở dữ liệu, chuyên viết truy vấn và đảm bảo dữ liệu an toàn) cùng lập trình viên viết truy vấn, kết nối API, hoặc xuất file. Đây là phần "tay chân" nặng nhất. Câu hỏi: truy vấn đã chạy ổn chưa, có lỗi mất dòng nào không?
Bước 3 — Gộp dữ liệu và làm sạch sơ bộ. Khi dữ liệu đến từ nhiều nguồn, sẽ có chỗ trùng khớp và chỗ xung đột. Bạn gộp lại rồi loại bỏ những dòng/cột trùng nội dung (redundant data — dữ liệu dư thừa, lặp lại không cung cấp thông tin mới). Đừng cố làm sạch sâu — đó là việc của giai đoạn preprocessing sau. Câu hỏi: còn cột nào trùng 100% nội dung với cột khác không?
Bước 4 — Đánh giá chất lượng. Dùng thống kê mô tả và biểu đồ như phần trên. Câu hỏi: cột nào có tỷ lệ trống cao bất thường, hay có outlier rõ rệt?
Bước 5 — Phát hiện gap. Gap là khoảng trống giữa dữ liệu bạn đang có và dữ liệu cần có để giải bài toán. Ví dụ: bạn cần phân loại khách hàng theo vùng miền nhưng cột "tỉnh thành" trống 40%. Câu hỏi: có biến quan trọng nào đang bị thiếu, hoặc nhóm đối tượng nào chưa xuất hiện trong dữ liệu?
Bước 6 — Quyết định lấp, thay thế, hoặc hoãn. Với mỗi gap, bạn có ba lựa chọn: đầu tư thêm nguồn để lấp, thay bằng biến khác gần tương đương, hoặc hoãn — chạy mô hình thử trước rồi quyết định sau. Câu hỏi: chi phí lấp gap này có tương xứng với lợi ích mang lại không?
Bước 7 — Bàn giao cho Data Understanding. Khi bạn tin rằng dữ liệu đã đủ chất lượng cơ bản để phân tích kỹ hơn, bạn chuyển sang Data Understanding. Đừng quên rằng giai đoạn sau có thể phát hiện thêm gap, và lúc đó lại quay về Data Collection — bạn có thể đọc chi tiết tại hiểu dữ liệu xong có thể phải quay lại thu thập.
Hoãn lấy dữ liệu khi nguồn chưa sẵn có
Đây là nguyên tắc thường bị bỏ qua nhất. Khi thấy một nguồn dữ liệu quan trọng chưa sẵn sàng — ví dụ phải chờ phê duyệt pháp lý, hoặc đối tác chưa mở API — phản xạ thường là "vậy dừng hết, chờ nguồn đó". Nhưng trong data science, hoãn một biến quan trọng không có nghĩa dừng mọi thứ.
Cách làm khác: chạy predictive modeling (mô hình dự đoán — tức thử dựng một phiên bản mô hình đơn giản) với tập dữ liệu hiện có, đánh giá kết quả trung gian. Nếu mô hình đã đủ tốt cho bài toán của bạn, bạn có thể quyết định không đầu tư thêm nguồn dữ liệu kia — và phân bổ nguồn lực vào việc khác. Ngược lại, nếu mô hình tệ hẳn vì thiếu biến đó, đó mới là lúc đầu tư thật sự vào việc lấy thêm.
Lý do nguyên tắc này hiệu quả: lấy dữ liệu tốn tiền, tốn thời gian, và đôi khi tốn cả tháng chờ đợi. Bạn không nên đốt những nguồn lực đó trước khi biết dữ liệu đó có thật sự cần thiết. Một kết quả tốt với dữ liệu hiện có luôn đáng giá hơn một kết quả "có thể tốt hơn" với dữ liệu phải chờ thêm hai tháng.
Case study: bệnh nhân suy tim sung huyết
Một case study kinh điển trong tài liệu của IBM về Data Science Methodology là bài toán dự đoán biến chứng ở bệnh nhân suy tim sung huyết (congestive heart failure). Đội dự án đã khảo sát 6 nhóm nguồn dữ liệu:
- Nhân khẩu học: tuổi, giới, nghề nghiệp, khu vực sinh sống.
- Lâm sàng: chẩn đoán, xét nghiệm, chỉ số sinh hiệu từ bệnh viện.
- Bảo hiểm: thông tin hợp đồng, mức chi trả, lịch sử đóng.
- Hồ sơ bác sĩ: ghi chú khám, đơn thuốc lịch sử, kết luận của bác sĩ điều trị.
- Claims (hóa đơn y tế): chi phí khám chữa, thủ thuật, nhập viện.
- Dược phẩm: lịch sử dùng thuốc, liều lượng, phản ứng phụ.
Điểm thú vị: ở lần chạy mô hình đầu, nguồn "dược phẩm" chưa tích hợp được vì hệ thống nhà thuốc tách biệt và việc kết nối mất thêm nhiều tháng. Đội dự án quyết định thử chạy với 5 nhóm còn lại trước.
Kết quả: mô hình với 5 nhóm đã cho độ chính xác khá tốt cho mục tiêu dự đoán ban đầu. Họ quyết định hoãn tích hợp nguồn dược phẩm và chuyển sang Data Understanding sớm hơn dự kiến — tiết kiệm hàng tháng làm việc và vẫn đạt yêu cầu bài toán.
Bài học rút ra: không phải cứ thu thập đủ mọi nguồn thì mới chạy mô hình. Chạy thử sớm với dữ liệu hiện có là cách phát hiện nhanh những nguồn nào thật sự cần và nguồn nào có thể bỏ qua.
Vai trò phối hợp khi thu thập dữ liệu
Data Collection hiếm khi là việc của một người. Bạn cần phối hợp ít nhất ba vai:
- Data Scientist — định hướng: xác định nguồn nào ưu tiên, biến nào cần lấy, tiêu chí chất lượng ra sao.
- DBA — thực thi: viết truy vấn (query) từ cơ sở dữ liệu, đảm bảo không ảnh hưởng hệ thống production, xử lý phân quyền.
- Lập trình viên — kết nối: viết script lấy dữ liệu từ API, gộp file, tự động hóa đường ống (pipeline) để lần sau chạy lại nhanh hơn.
Một checklist 4 việc nên làm cùng team kỹ thuật trước khi bắt đầu:
- Liệt kê nguồn dữ liệu kèm tên người giữ (data owner) từng nguồn.
- Thống nhất định dạng đầu ra (tên cột, đơn vị, timestamp) để tránh gộp xong phải đổi tay.
- Thiết lập cơ chế tự động hóa cho những nguồn cần lấy định kỳ.
- Thống nhất cách ghi log khi truy vấn lỗi hoặc dữ liệu bất thường.
Không phối hợp chặt, kết quả thường là dữ liệu đến trễ, định dạng lệch nhau, hoặc truy vấn chạy mà không ai dám tin cậy.
4 sai lầm phổ biến và cách tránh
Dưới đây là bốn sai lầm mình thấy lặp đi lặp lại ở người mới làm data science. Mỗi cái kèm theo cách tránh cụ thể.
Sai lầm 1 — Làm một lần rồi xong. Nghĩ rằng cứ lấy dữ liệu xong là chuyển sang bước sau. Thực tế Data Collection là vòng lặp, và bạn sẽ phải quay lại ít nhất một lần. Cách tránh: chấp nhận vòng lặp, dành thời gian buffer cho việc thu thập lại.
Sai lầm 2 — Cố lấy mọi nguồn ngay từ đầu. Tham lam dữ liệu, lấy cả những nguồn chưa chắc cần. Cách tránh: ưu tiên nguồn nào đã có trong danh sách Data Requirements, và chạy thử mô hình trước khi đầu tư nguồn mới.
Sai lầm 3 — Bỏ qua đánh giá chất lượng. Lấy xong đưa thẳng cho team chạy mô hình. Kết quả: lỗi phát hiện muộn, đổ lỗi qua lại. Cách tránh: luôn chạy thống kê mô tả và visualization ngay khi có dữ liệu — đây là phần không thể bỏ qua.
Sai lầm 4 — Không phối hợp DBA và lập trình viên. Data Scientist tự mày mò truy vấn, chậm và rủi ro. Cách tránh: mời DBA và lập trình viên ngồi vào ngay từ khi lên kế hoạch thu thập, không phải đợi đến lúc cần.
Lưu ý về chính sách và bảo mật dữ liệu (2025–2026)
Với dữ liệu nhạy cảm như case suy tim ở trên, bạn cần lưu ý thêm về chính sách và pháp lý tại quốc gia mình làm việc. Các điểm thường gặp:
- PII (Personally Identifiable Information) — thông tin cá nhân nhận diện được (tên, CMND, số điện thoại). Nhiều nơi quy định phải mã hóa hoặc ẩn danh trước khi chia sẻ.
- Dữ liệu y tế — thường thuộc nhóm nhạy cảm nhất. Ví dụ chuẩn HIPAA ở Mỹ, GDPR ở EU, và Nghị định 13/2023/NĐ-CP về bảo vệ dữ liệu cá nhân ở Việt Nam.
- Quyền truy cập — không phải ai cũng có quyền xem dữ liệu gốc. Cần cơ chế phân quyền và log lại ai đã truy cập khi nào.
Vì quy định thay đổi theo thời gian và khác nhau giữa các quốc gia, bạn nên kiểm tra với phòng pháp chế hoặc chuyên gia tuân thủ (compliance) trước khi thu thập. Phần này cần verify chi tiết theo ngữ cảnh cụ thể của bạn, không nên áp dụng máy móc từ case study nước ngoài.
Điểm cần nhớ và checklist tự kiểm tra
Bảy ý chính bạn có thể mang theo sau khi đọc xong:
- Data Collection đứng giữa Data Requirements và Data Understanding trong methodology 10 giai đoạn.
- Đây là vòng lặp, không phải bước một lần.
- Hai kỹ thuật đánh giá cốt lõi: thống kê mô tả và visualization.
- Bảy bước thu thập giúp bạn biết mình đang ở đâu và cần hỏi gì tiếp theo.
- Nguyên tắc hoãn: chạy mô hình thử trước khi đầu tư thêm nguồn dữ liệu.
- Phối hợp Data Scientist, DBA, lập trình viên từ đầu — không phải cuối.
- Tuân thủ chính sách bảo mật dữ liệu (PII, y tế) theo quy định hiện hành.
Checklist ngắn để tự kiểm tra sau khi thu thập xong một đợt dữ liệu:
- Mình đã chạy thống kê mô tả cho mọi cột quan trọng chưa?
- Mình đã vẽ ít nhất một biểu đồ để phát hiện outlier chưa?
- Mình đã kiểm tra tỷ lệ giá trị thiếu của từng biến chưa?
- Mình đã gộp dữ liệu và loại bỏ cột/dòng redundant chưa?
- Mình đã rà soại gap và quyết định lấp/thay/hoãn cho từng gap chưa?
- Mình đã ghi log lý do điều chỉnh trong vòng lặp này chưa?
Lời kết
Data Collection giống như đi chợ thông minh: bạn không phải gói hết mọi thứ có trong quầy, cũng không nên về nhà với giỏ rỗng chỉ vì chưa có một món. Mua đúng thứ, đúng chất lượng, và biết quay lại khi cần — đó mới là cách bạn có được tập dữ liệu đủ tốt để nấu nên một mô hình đáng tin. Bước tiếp theo sau khi có dữ liệu sơ bộ là Data Understanding — nơi bạn sẽ đọc kỹ từng cột trước khi giao cho mô hình.
Tags
- chất lượng dữ liệu
- dba
- tiền xử lý
- data collection
- data science methodology
- outlier
- data science
- vòng lặp dữ liệu
- bảo mật dữ liệu
- thu thập dữ liệu
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.