Data Science
Data Science Methodology Là Gì: 10 Giai Đoạn Và 10 Câu Hỏi Vàng Để Giải Bài Toán Đúng
Data Science Methodology của John Rollins là bộ 10 giai đoạn giúp người mới giải bài toán dữ liệu đúng hướng. Bài gom 10 bước, 10 câu hỏi vàng, ví dụ churn viễn thông và 4 sai lầm phổ biến cần tránh.
 Phong Nguyen
PNTECH Writer · 20/09/2026
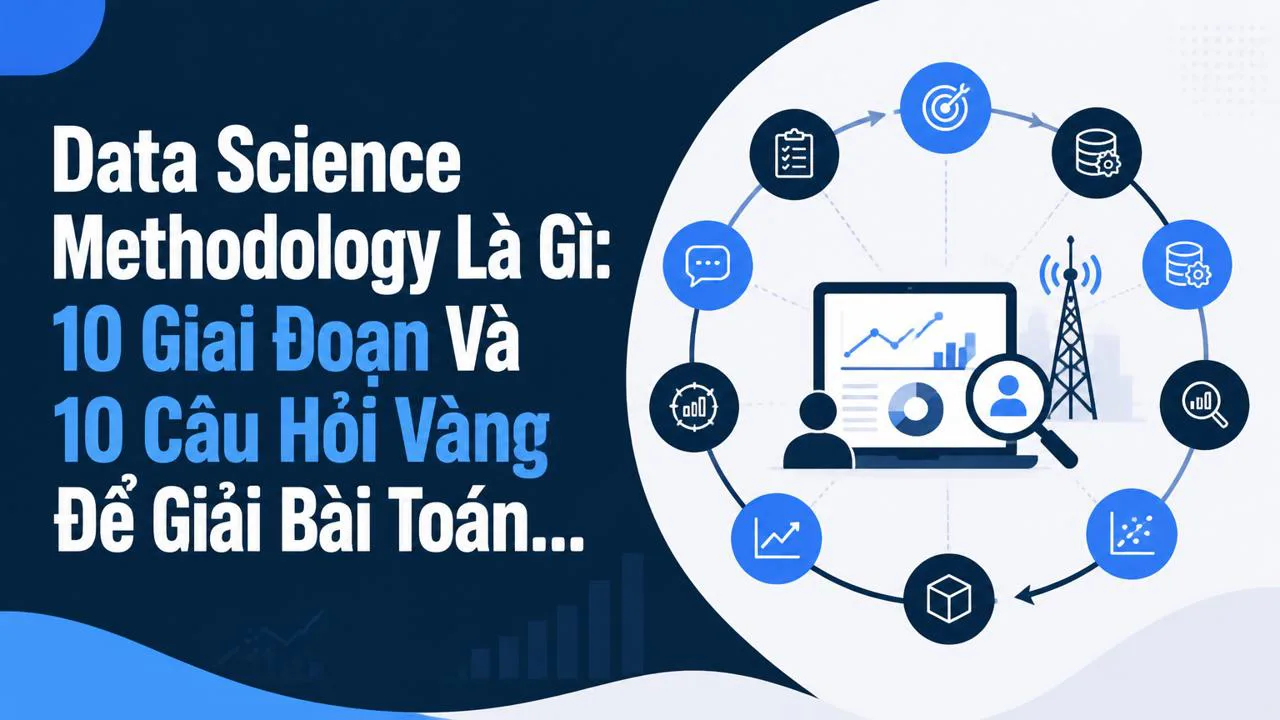
Data Science Methodology là gì và vì sao người mới hay thiếu nó
Nếu bạn đã mở Python, kéo dữ liệu vào notebook và chạy model đầu tiên — bạn đang làm đúng thứ mà 90% người mới làm. Nhưng nếu kết quả cuối cùng không ai dùng, vấn đề nằm ở chỗ bạn đã bỏ qua Data Science Methodology — tức là bộ khung các bước có thứ tự để giải một bài toán dữ liệu từ đầu đến cuối, thay vì nhảy thẳng vào thuật toán. Có thể hiểu nôm na: methodology giống bản đồ đường đi từ nhà tới chỗ làm, còn thuật toán chỉ là chiếc xe bạn lái trên đường. Không có bản đồ, bạn vẫn chạy được, nhưng dễ đi nhầm hướng hoặc tới nơi rồi mới biết không phải điểm đến [S1][S2].
Với người mới học data science (khoa học dữ liệu — lĩnh vực kết hợp thống kê, lập trình và kiến thức nghiệp vụ để rút thông tin có giá trị từ dữ liệu), lý do phổ biến nhất khiến dự án "xong rồi mà không ai xài" là nhảy thẳng vào model trước khi hiểu bài toán. Methodology không thay thế thuật toán; nó là thứ giúp bạn biết dùng thuật toán nào, lúc nào, để làm gì. Nếu bạn chưa nắm khái niệm nền tảng, có thể xem lại xem lại toàn bộ hướng dẫn mastering data science hoặc bài data science là gì và vì sao cần methodology.
Methodology của John Rollins (IBM) — bản đồ 10 giai đoạn
Trong cộng đồng khoa học dữ liệu có nhiều bộ khung quy trình, nhưng một bộ rất phù hợp cho người mới là Data Science Methodology của John Rollins từ IBM. Đây là chuỗi 10 bước có thứ tự, sinh ra từ thực tế dự án của IBM và được dùng trong các khóa học nền tảng [S3][S5]. Ý tưởng cốt lõi: data science không chỉ là kỹ thuật, mà là một quy trình ra quyết định dựa trên dữ liệu — trong đó ba yếu tố phải đi cùng nhau:
- Thống kê & toán học: để tìm pattern và đo độ tin cậy.
- Công nghệ & lập trình: để xử lý dữ liệu lớn và chạy mô hình.
- Kiến thức nghiệp vụ: để biết bài toán đáng giải theo hướng nào.
Điểm đặc biệt của methodology này là nó đi ghép đôi 10 giai đoạn với 10 câu hỏi cụ thể — câu hỏi là động lực để bạn không đi lệch. Bộ khung này khác với CRISP-DM (một framework 6 bước phổ biến trong data mining) và quy trình 7 bước trong data mining để so sánh; bạn không cần chọn một, mà hiểu rằng cùng một bài toán có thể đi bằng nhiều bản đồ khác nhau.
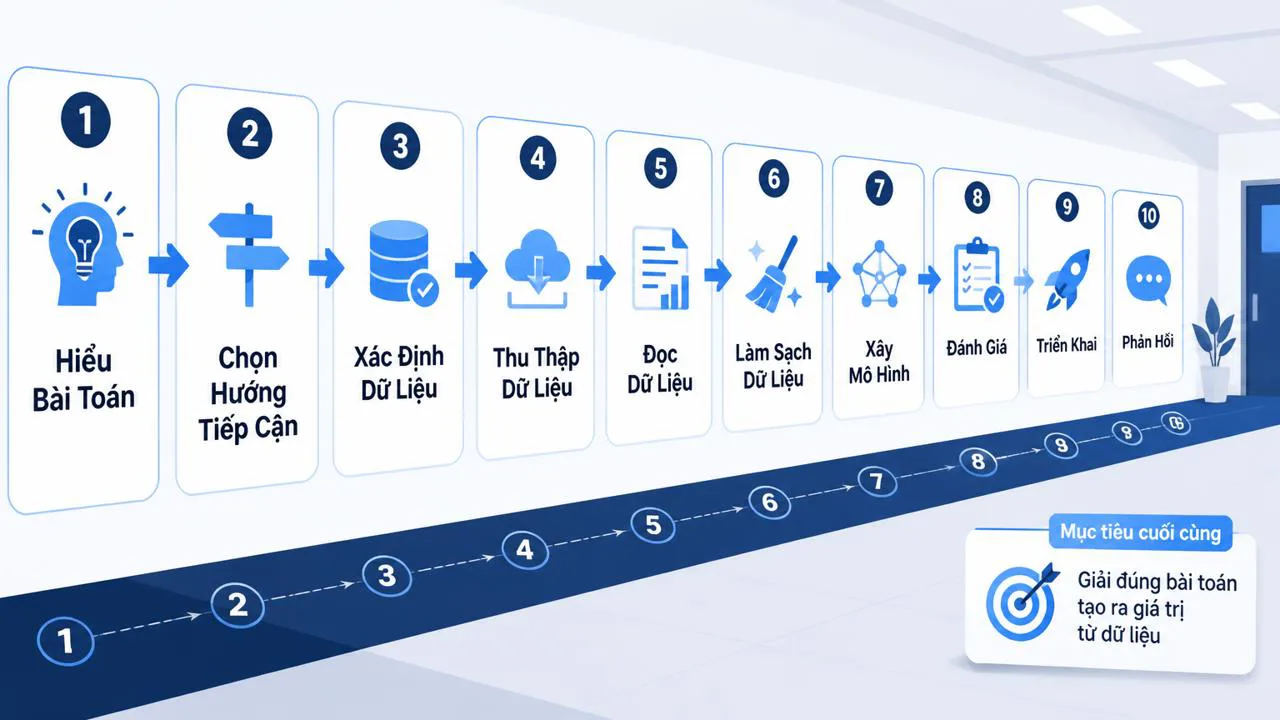
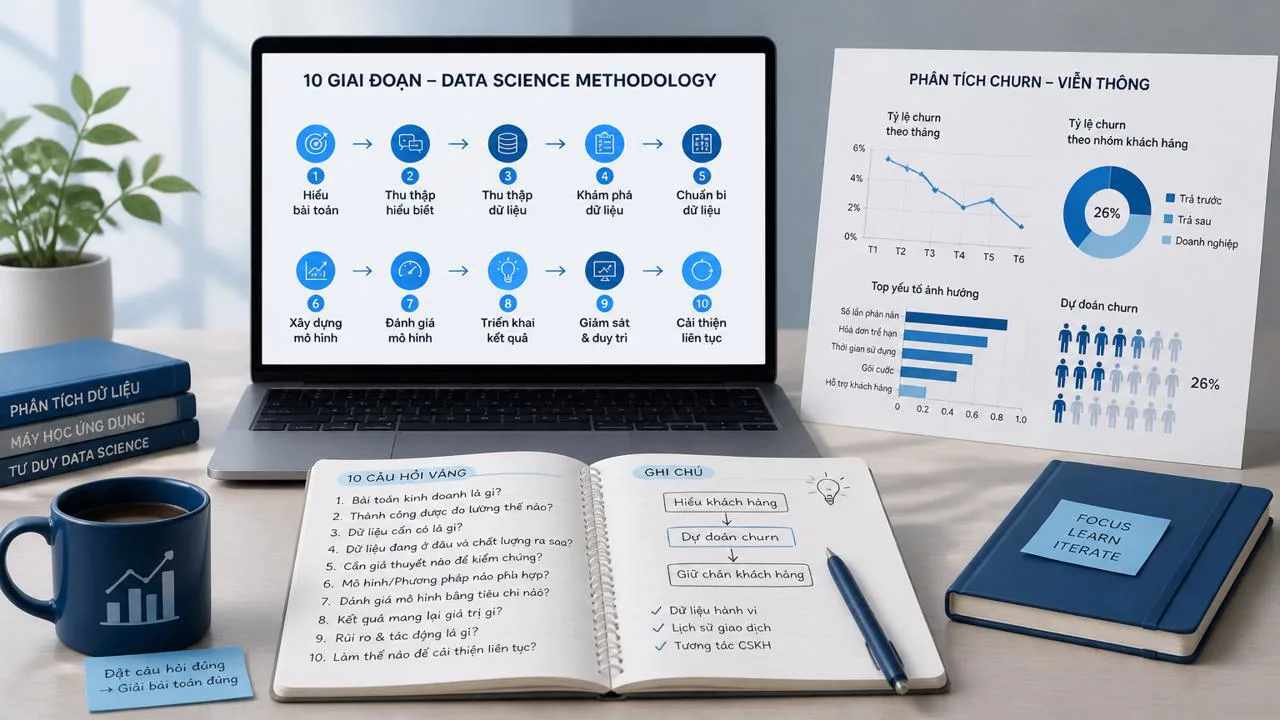
10 giai đoạn theo thứ tự
Dưới đây là 10 giai đoạn của methodology, kèm một câu đời thường cho mỗi bước để bạn dễ nhớ:
| # | Giai đoạn (tiếng Anh) | Nghĩa tiếng Việt | Một câu đời thường |
|---|---|---|---|
| 1 | Business Understanding | Hiểu bài toán | Bệnh nhân kêu đau đầu — bạn phải khám trước khi kê thuốc. |
| 2 | Analytic Approach | Chọn hướng tiếp cận | Sau khi biết bệnh, chọn dùng thuốc hay phẫu thuật. |
| 3 | Data Requirements | Xác định dữ liệu cần | Chuẩn bị danh sách xét nghiệm cần làm. |
| 4 | Data Collection | Thu thập dữ liệu | Lấy máu, chụp phim, gửi mẫu đi. |
| 5 | Data Understanding | Đọc hiểu dữ liệu | Nhìn kết quả xét nghiệm, tìm chỗ bất thường. |
| 6 | Data Preparation | Làm sạch dữ liệu | Lọc bỏ giá trị lỗi, điền chỗ thiếu, chuẩn hóa đơn vị. |
| 7 | Modeling | Xây mô hình | Đưa dữ liệu vào thuật toán để dự đoán. |
| 8 | Evaluation | Đánh giá mô hình | Xem thuốc có hết đau thật không, có tác dụng phụ không. |
| 9 | Deployment | Triển khai | Đưa thuốc vào toa chính thức, bệnh nhân bắt đầu dùng. |
| 10 | Feedback | Phản hồi | Tái khám, xem thuốc còn tác dụng không, cần đổi không. |
Với một số bước, bạn có thể đọc chi tiết ở các bài chuyên sâu: đi sâu vào bước Business Understanding — hiểu đúng bài toán trước khi chạm vào dữ liệu, giai đoạn 2 Analytic Approach chi tiết, data requirements trong data science, Chi tiết giai đoạn thứ 2: Data Collection trong Methodology, đi sâu vào giai đoạn Data Understanding, và giai đoạn Modeling trong Data Science Methodology.
10 câu hỏi vàng — chia thành 3 nhóm
Điểm độc đáo của Rollins là mỗi giai đoạn được gắn với một câu hỏi. 10 câu hỏi này có thể gom thành 3 nhóm lớn:
Nhóm 1 — Xác định vấn đề (bước 1–2)
- Bài toán kinh doanh thực sự là gì, ai là stakeholder (người quan tâm — ví dụ phòng marketing, phòng bán hàng) và tiêu chí thành công đo bằng gì?
- Có thể giải bằng cách tiếp cận nào: classification (phân loại — ví dụ churn / không churn), regression (dự đoán con số liên tục — ví dụ doanh thu), hay clustering (gom nhóm)?
Nhóm 2 — Tổ chức dữ liệu (bước 3–6)
- Cần dữ liệu gì, từ nguồn nào, định dạng ra sao? >Dữ liệu đã có sẵn chưa, cần thu thập thêm không, có thể tái sử dụng không?
- Dữ liệu trông như thế nào: có giá trị thiếu, có outlier (giá trị bất thường — ví dụ một người 200 tuổi trong tập khách hàng) không?
- Dữ liệu đã đủ "sạch" để đưa vào mô hình chưa, hay phải biến đổi thêm?
Nhóm 3 — Xác thực cách tiếp cận (bước 7–10)
- Mô hình có trả lời đúng câu hỏi kinh doanh không, hay chỉ "đẹp" trên giấy?
- Mô hình có dùng được trong thực tế không (tốc độ, chi phí, cách triển khai)?
- Sau khi deployment (triển khai — đưa mô hình vào hệ thống thật), cần thu thập feedback (phản hồi từ người dùng thật) như thế nào để cải thiện?
Câu hỏi là động lực của quy trình: nếu bạn không biết phải hỏi gì ở bước 1, bạn sẽ chọn sai thuật toán ở bước 7.
Ví dụ minh hoạ: bài toán churn viễn thông
Để thấy 10 giai đoạn hoạt động ra sao, hãy đi cùng một bài toán cụ thể: churn viễn thông — tức là dự đoán khách hàng nào sắp rời mạng để đội retention giữ chân kịp thời.
- Business Understanding: Phòng kinh doanh muốn giảm churn 10% trong quý tới. Câu hỏi đầu tiên không phải "model gì", mà là "đo churn như thế nào: theo tháng, theo quý, có tính khách hàng tạm ngưng không".
- Analytic Approach: Vì đầu ra là "rời / không rời", bài toán thuộc dạng classification. Một lựa chọn quen thuộc là logistic regression (một mô hình thống kê đơn giản, dự đoán xác suất khách hàng thuộc nhóm rời mạng) vì dễ giải thích cho stakeholder [S1].
- Data Requirements: Cần dữ liệu về hợp đồng (thời hạn, gói cước), lịch sử dùng (cuộc gọi, data, thanh toán), tương tác dịch vụ (khiếu nại, CSAT — điểm hài lòng).
- Data Collection: Lấy từ hệ thống CRM (phần mềm quản lý khách hàng), hệ thống billing (hóa đơn) và log cuộc gọi. Một số trường phải kéo thủ công vì hệ thống cũ không có API.
- Data Understanding: Mở từng cột, đếm giá trị thiếu, vẽ biểu đồ phân phối. Phát hiện cột "tuổi" có người 200, cột "ngày kích hoạt" có dòng trống — chính là outlier và missing value.
- Data Preparation: Bỏ outlier, điền giá trị thiếu bằng trung vị, mã hoá biến phân loại (ví dụ gói cước thành số), tạo thêm biến "số tháng còn lại của hợp đồng".
- Modeling: Chạy logistic regression, sau đó thử thêm decision tree để so sánh. Chia tập train/test theo tỉ lệ 70/30.
- Evaluation: Đo AUC (diện tích dưới đường cong ROC — thước đo khả năng phân loại đúng của mô hình, càng gần 1 càng tốt), precision (trong số người mô hình đoán "sẽ rời", bao nhiêu % thật sự rời), recall (trong số người thật sự rời, mô hình tìm ra bao nhiêu %). Mô hình đạt AUC 0.78 trên tập test — chấp nhận được.
- Deployment: Đưa model vào hệ thống, mỗi đêm xuất danh sách khách hàng có xác suất churn cao cho đội retention gọi tư vấn.
- Feedback: Sau 1 tháng, xem lại: danh sách dự đoán có đúng không, tỉ lệ churn giảm chưa. Phát hiện nhóm khách hàng trả sau có pattern khác — cần bổ sung dữ liệu và huấn luyện lại.
Qua ví dụ này bạn thấy: model chỉ là một phần nhỏ (bước 7–8). Phần lớn thời gian nằm ở hiểu bài toán, làm sạch dữ liệu và vận hành sau triển khai. Đây là điều một một data scientist làm gì mỗi ngày theo từng giai đoạn đã phản ánh — không phải ngày nào cũng "chạy model".
4 sai lầm thường gặp khi bỏ methodology
Nhiều người mới không phải thiếu kiến thức, mà là thiếu kỷ luật đi theo quy trình. Bốn sai lầm phổ biến nhất:
- Jumping to solutions (nhảy tới giải pháp): Nghe "cần dự đoán churn" là nghĩ ngay tới XGBoost, neural network. Sai ở chỗ chưa hiểu bài toán thực sự (Business Understanding) nên có thể giải sai câu hỏi.
- Bỏ qua Business Understanding: Nhảy thẳng vào Analytic Approach, chọn sai loại mô hình. Ví dụ: dùng regression cho bài toán phân loại.
- Giả định dữ liệu sạch: Mở file CSV là chạy model luôn, không kiểm tra missing value, outlier, đơn vị đo. Kết quả thường đẹp trên tập train nhưng thảm ở thực tế.
- Không lắng nghe Feedback: Triển khai xong là xong, không quay lại xem mô hình còn đúng không. Dữ liệu thay đổi theo thời gian, mô hình cũng "cũ" theo.
Checklist 10 giai đoạn — in ra dán góc bàn
Để dễ áp dụng, đây là phiên bản rút gọn bạn có thể in ra hoặc lưu vào Notion:
- [ ] Bài toán kinh doanh đã rõ, stakeholder đã xác nhận, tiêu chí thành công đã đo được?
- [ ] Hướng tiếp cận (classification/regression/clustering) đã chọn và giải thích được vì sao?
- [ ] Danh sách dữ liệu cần có đã liệt kê, nguồn và định dạng đã rõ?
- [ ] Đã thu thập dữ liệu (đủ số lượng, đúng thời gian, đúng trường)?
- [ ] Đã đọc dữ liệu: missing, outlier, phân phối, tương quan sơ bộ?
- [ ] Đã làm sạch, biến đổi, tạo biến mới nếu cần?
- [ ] Đã chạy model, so sánh ít nhất 2 phương pháp?
- [ ] Đã đánh giá bằng metric phù hợp, kiểm tra trên tập test chưa thấy?
- [ ] Đã lên kế hoạch triển khai (ai dùng, ở đâu, bao lâu cập nhật)?
- [ ] Đã có cơ chế thu feedback và lịch cập nhật mô hình?
Methodology không làm bạn chậm đi — nó làm bạn đi đúng hướng ngay từ bước đầu, nên tổng thể nhanh hơn.
Điểm cần nhớ trước khi bắt tay vào bài toán tiếp theo
Data Science Methodology của Rollins là một trong nhiều bộ khung có sẵn, nhưng đủ gọn cho người mới. Nó không phải công thức cứng: bạn có thể quay lại bước trước nếu phát hiện dữ liệu chưa đủ, hoặc rẽ nhánh nếu stakeholder đổi yêu cầu. Quan trọng là không bỏ bước nào — đặc biệt là Business Understanding và Feedback.
Nếu bạn muốn đào sâu tiếp, hãy bắt đầu từ bước thường bị bỏ qua nhất: đi sâu vào bước Business Understanding — hiểu đúng bài toán trước khi chạm vào dữ liệu. Đây là bài mà nếu bạn hiểu rõ ngay từ đầu, các bước còn lại sẽ tự nhiên rõ ràng hơn.
Lưu ý 2025–2026: Methodology của Rollins được IBM công bố từ lâu và đã được cập nhật qua nhiều khóa học. Nếu bạn cần trích dẫn nguyên văn câu hỏi tiếng Anh, nên kiểm tra lại trang IBM SkillsBuild hoặc tài liệu gốc, vì một số khóa học cũ đã chỉnh sửa cách diễn đạt.
Tags
- data science
- IBM
- người mới
- Methodology
- John Rollins
- Churn
- Quy trình
- phân tích dữ liệu
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.