Data Science
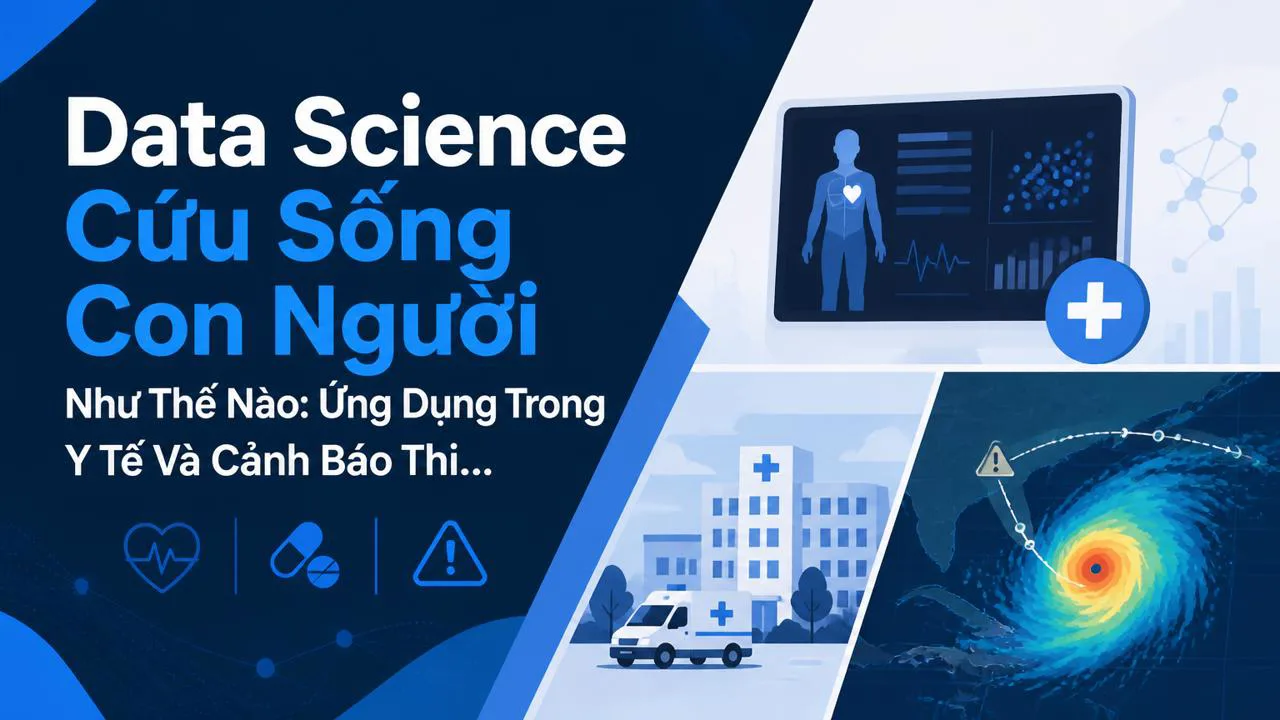
Data Science Cứu Sống Con Người Như Thế Nào: Ứng Dụng Trong Y Tế Và Cảnh Báo Thiên Tai
Data science giúp bác sĩ tuyến tỉnh tiếp cận phác đồ điều trị ung thư mới nhất và giúp hệ thống cảnh báo lũ sớm hơn 6 tiếng nhờ kết hợp dữ liệu truyền thống với mạng xã hội.
 Phong Nguyen
PNTECH Writer · 17/09/2026
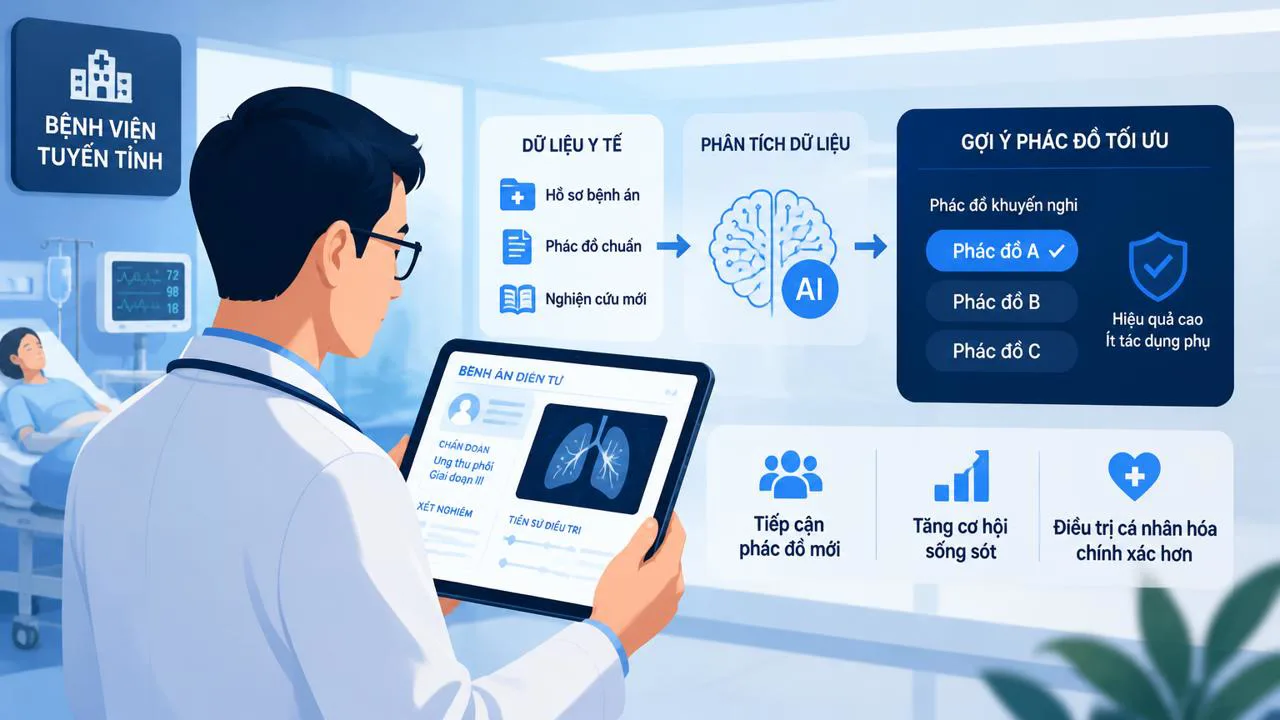
Bác sĩ ở một bệnh viện tuyến tỉnh vừa nhận ca ung thư phổi mới. Anh không biết rằng có một xét nghiệm gene cụ thể có thể gợi ý loại thuốc nhắm trúng đích cho bệnh nhân này. Nếu không có ai nhắc, bệnh nhân có thể bỏ lỡ phương án điều trị tốt nhất — chỉ vì bác sĩ điều trị chưa cập nhật kịp tài liệu. Trong cùng thời điểm đó, ở một tỉnh miền núi, hệ thống cảnh báo lũ chạy trên dữ liệu mạng xã hội và trạm đo kết hợp lại với nhau phát tín hiệu sớm hơn 6 tiếng — đủ để cả ngàn người sơ tán kịp trước khi nước dâng.
Cả hai tình huống trên đều có một điểm chung: data science cứu sống con người — không phải trên phim ảnh, mà trong đời thực. Nếu bạn từng nghĩ data science chỉ là mấy cái biểu đồ và bảng dashboard khô khan, bài này sẽ cho bạn thấy lý do vì sao ngành này đang được cả ngành y tế và khí tượng đầu tư nghiêm túc.
Data science là gì, nói ngắn cho người mới
Data science là cách thu thập, làm sạch và phân tích dữ liệu lớn để tìm ra mẫu (pattern) ẩn bên trong, từ đó dự đoán hoặc gợi ý hành động. Ngành này kết hợp ba thứ: thống kê (để tính toán xác suất), khoa học máy tính (để xử lý lượng dữ liệu khổng lồ) và hiểu biết ngành dọc — ví dụ hiểu bệnh học nếu làm trong y tế, hiểu khí tượng nếu làm cảnh báo thiên tai. Thiếu một trong ba, mô hình sẽ ra kết quả đẹp trên lý thuyết nhưng vô dụng ngoài thực tế.
Chính vì kết hợp cả ba, data science giải quyết được bài toán mà một mình bác sĩ giỏi hay nhà khí tượng giàu kinh nghiệm không kham nổi: lượng thông tin cần đọc và đối chiếu đã vượt quá khả năng xử lý của con người. Nếu bạn chưa rõ data science là gì ở mức tổng quát, đọc lại bài nền tảng trước để có khung khái niệm đầy đủ hơn, rồi quay lại bài này xem nó đi vào đời thực ra sao.
Predictive analytics và data mining — hai khái niệm cốt lõi
Trước khi vào ví dụ, bạn cần hiểu hai thuật ngữ sẽ đi xuyên suốt bài.
Predictive analytics (phân tích dự đoán) là dùng dữ liệu quá khứ và hiện tại để đoán điều sắp xảy ra. Ví dụ đời thường dễ nhớ: ứng dụng gọi xe nhìn lịch sử đặt xe của bạn để đoán mai bạn sẽ đặt lúc 7h15 đi công ty, từ đó chuẩn bị tài xế sẵn. Trong y tế, predictive analytics nhìn vào hàng vạn bệnh án để đoán: bệnh nhân ung thư có gene marker X thường đáp ứng tốt với thuốc Y. Trong khí tượng, nó nhìn vào dữ liệu trạm đo và ảnh vệ tinh để đoán: lũ ở thung lũng này có khả năng dâng 1,5 mét trong 12 giờ tới.
Data mining (khai phá dữ liệu) là mò trong đống dữ liệu lớn để tìm ra mẫu ẩn mà trước đó chưa ai nhìn ra. Nếu predictive analytics là đoán, thì data mining là bước khám phá để có cái gì để mà đoán. Cụ thể: rà lại hàng triệu bệnh án ẩn danh để tìm xem nhóm bệnh nhân có biến thể gene nào đó lại đáp ứng thuốc tốt bất thường — mẫu này chính là "mỏ vàng" để xây mô hình dự đoán. Nếu bạn muốn đi sâu kỹ thuật, Quy trình 7 bước của data mining — kỹ thuật cốt lõi được nhắc trong bài sẽ giải thích chi tiết hơn.
Data science cứu sống con người không phải vì nó làm được phép màu, mà vì nó giúp bác sĩ và nhà khí tượng xử lý lượng thông tin mà trước đây họ không có cách nào đọc hết.
Ứng dụng trong y tế: bác sĩ ở đâu cũng tiếp cận được kiến thức mới nhất
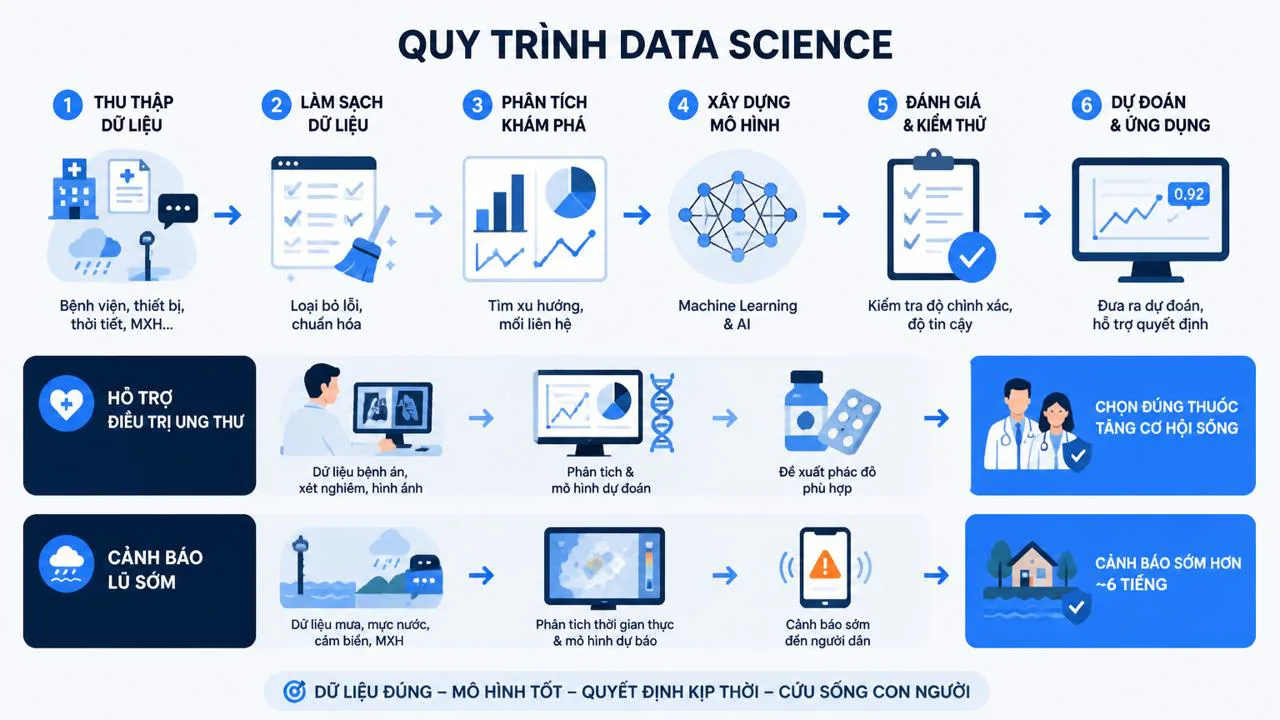
Trong ung thư nói riêng, một bệnh nhân có thể có nhiều lựa chọn điều trị — phẫu thuật, hóa trị, xạ trị, thuốc nhắm trúng đích, thử nghiệm lâm sàng. Vấn đề là bác sĩ tuyến tỉnh không có thời gian đọc hết các nghiên cứu mới công bố mỗi tuần. Data science bước vào theo trình tự sau:
- Bước 1 — Gom dữ liệu bệnh nhân: gene marker (một biến thể trong gene gợi ý nguy cơ bệnh hoặc đáp ứng thuốc), bệnh nền, môi trường sống, tiền sử dùng thuốc.
- Bước 2 — Chạy predictive analytics: kết hợp data mining, mô hình thống kê và machine learning (máy học) để tìm ra bệnh nhân này giống nhóm nào trong dữ liệu cũ.
- Bước 3 — Hệ thống gợi ý: bệnh nhân nên làm xét nghiệm gene tiếp theo, thử thuốc nào, hoặc có phù hợp thử nghiệm lâm sàng không. Bạn có thể hình dung hệ thống này giống như một trợ lý đã đọc hết tài liệu y khoa mới nhất rồi gợi ý bác sĩ bước đi tiếp theo.
- Bước 4 — Bác sĩ ra quyết định: dựa trên gợi ý, kết hợp kinh nghiệm cá nhân và hiểu biết về bệnh nhân thực tế.
- Bước 5 — Rút ngắn khoảng cách chuyên môn: bác sĩ ở thành phố hay vùng quê đều tiếp cận được cùng một lớp thông tin — đây là điểm mấu chốt giúp cứu nhiều bệnh nhân hơn.
Hai ví dụ y tế đáng chú ý
Một nghiên cứu của Boston Consulting Group kết hợp với AdvaMedDx (hiệp hội các hãng chẩn đoán y tế tại Mỹ) chỉ ra điều đáng suy nghĩ: yếu tố quyết định một bệnh nhân ung thư có được xét nghiệm gene cứu mạng hay không — không phải tình trạng bệnh nhân — mà là bác sĩ điều trị có biết đến xét nghiệm đó hay không. Nói cách khác, khoảng cách nằm ở thông tin, không phải ở bệnh nhân. Hệ thống predictive analytics chính là cầu nối lấp khoảng cách đó.
Hệ thống y tế NorthShore University HealthSystem ở Chicago (Mỹ) từng được biết đến như một trong những nơi tiên phong triển khai EMR đạt cấp cao cho cả bệnh nhân nội trú lẫn ngoại trú. Lượng dữ liệu ẩn danh sinh ra từ hệ thống này trở thành nền tảng cho nhiều nghiên cứu phân tích, giúp nhóm nghiên cứu phát hiện các mẫu bệnh mới mà trước đó khó nhìn ra bằng mắt thường.
Bạn cũng có thể xem thêm Các ứng dụng khác trong kinh doanh và vận hành doanh nghiệp để thấy data science không chỉ dừng ở y tế, và Phân biệt AI và data science, và các thuật ngữ cốt lõi để tránh nhầm lẫn khi đọc tài liệu.
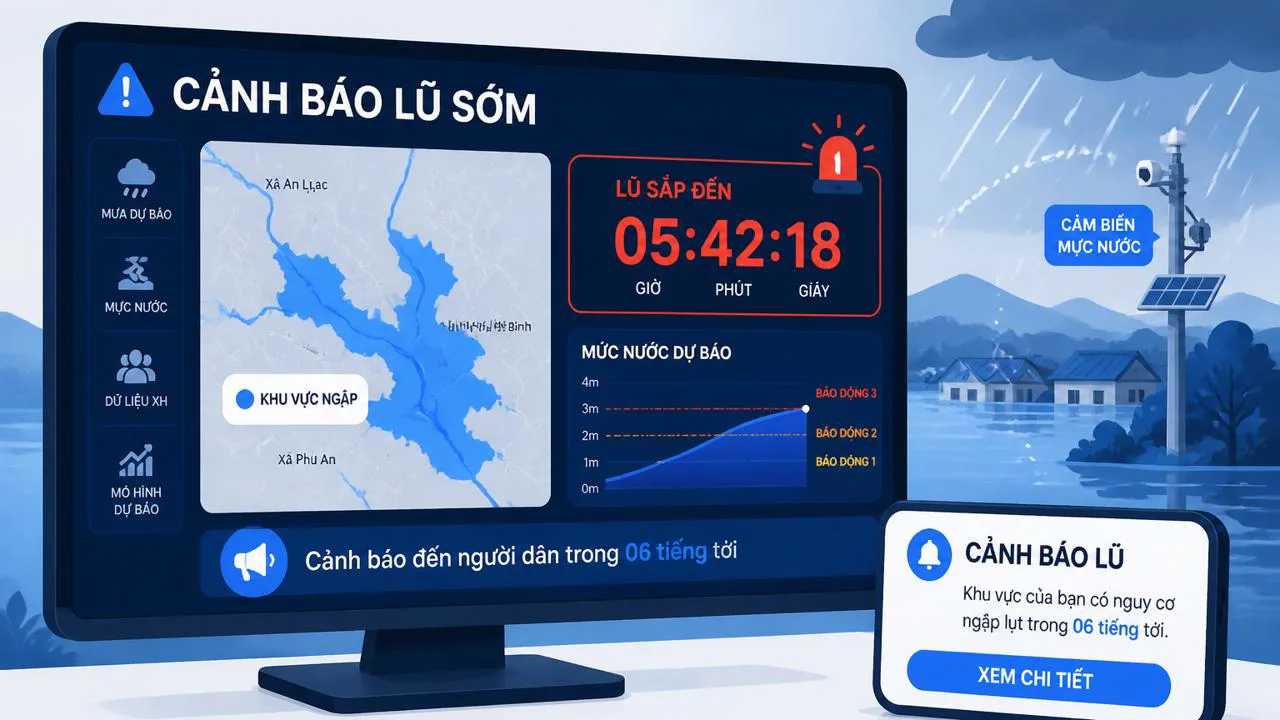
Ứng dụng trong cảnh báo thiên tai: thêm 6 tiếng là thêm hàng ngàn mạng sống
Trong cảnh báo thiên tai, nguyên tắc "sớm hơn một phút, cứu thêm nhiều người" là tối quan trọng. Data science tham gia theo trình tự:
- Bước 1 — Gom dữ liệu truyền thống: trạm khí tượng, vệ tinh, cảm biến mực nước, thiết bị đo địa chấn.
- Bước 2 — Thêm dữ liệu không chính thống: ảnh chụp, từ khóa, bài đăng trên mạng xã hội mô tả tình hình tại chỗ (mưa lớn, nước dâng, đường ngập).
- Bước 3 — Gộp vào mô hình dự đoán: tất cả nguồn dữ liệu được kết hợp để dự báo động đất, bão, lũ, núi lửa với độ chính xác cao hơn và cảnh báo cục bộ hơn.
- Bước 4 — Phát cảnh báo sớm hơn: thay vì chờ dữ liệu chính thống cập nhật theo chu kỳ, hệ thống nhận tín hiệu từ cộng đồng theo thời gian thực.
- Bước 5 — Cộng đồng và lực lượng cứu hộ sơ tán: người dân có thêm vài giờ chuẩn bị — di dời tài sản, đưa người già và trẻ nhỏ đến nơi an toàn.
Điểm đáng chú ý là dữ liệu mạng xã hội — tưởng như chỉ là status Facebook — lại trở thành nguồn tín hiệu thời gian thực cực kỳ giá trị. Một tấm ảnh chụp đường ngập kèm hashtag địa điểm có thể giúp mô hình nhận diện khu vực lũ nhanh hơn cảm biến chính thống ở vùng sâu vùng xa.
Ví dụ thiên tai thật và bài học rút ra
Nhóm nghiên cứu tại Đại học Warwick (Anh) đã công bố nghiên cứu dùng ảnh và từ khóa trên mạng xã hội để theo dõi diễn biến lũ và bão theo thời gian thực. Khi kết hợp với dữ liệu trạm khí tượng truyền thống, dự báo cục bộ trở nên chính xác hơn — đặc biệt ở những vùng mà hệ thống đo chính thống thưa thớt. Đây là minh chứng rõ ràng: dữ liệu lớn (big data — tức dữ liệu to và phức tạp đến mức Excel không xử lý nổi) khi kết hợp đúng cách sẽ tạo ra giá trị vượt xa từng nguồn riêng lẻ.
Ở Việt Nam và Đông Nam Á, Trung tâm Dự báo Khí tượng Thủy văn Quốc gia đã từng đưa tin về mô hình dự báo bão và lũ có sử dụng dữ liệu lớn kết hợp, nhưng chi tiết cụ thể về số liệu cải thiện dự báo cần được xác minh từ nguồn chính thống trước khi đưa vào bài — nếu bạn đang theo dõi chủ đề này, nên đọc trực tiếp từ trang của cơ quan dự báo.
Cảnh báo sớm hơn 6 tiếng không phải con số ấn tượng trên slide — nó là hàng ngàn gia đình kịp đưa người thân đến nơi an toàn trước khi nước dâng.
Lưu ý quan trọng để không thổi phồng vai trò của data science
Data science là công cụ rất mạnh, nhưng nó không phải phép màu. Để tránh hiểu sai, bạn cần nhớ bốn điểm:
- Predictive analytics chỉ là trợ lý, không thay bác sĩ hay nhà khí tượng. Quyết định cuối cùng vẫn là con người chịu trách nhiệm — bác sĩ vẫn là người hiểu bệnh nhân, nhà khí tượng vẫn là người hiểu địa hình.
- Dữ liệu y tế cực kỳ nhạy cảm. Phải ẩn danh (anonymize) trước khi dùng cho nghiên cứu. Vi phạm quyền riêng tư là rủi ro đạo đức lớn nhất, không phải sai số kỹ thuật.
- Không nên chỉ dựa một nguồn dữ liệu. Dự báo thiên tai chính xác nhất khi kết hợp nhiều nguồn — chính thống và không chính thống — thay vì chỉ tin vào một mô hình.
- Bác sĩ giỏi nhất là người kết hợp được ba lớp: gợi ý từ máy + kinh nghiệm cá nhân + hiểu bệnh nhân thực tế.
Nếu bạn thích cách tiếp cận bài toán đời thường của data science, Thêm 3 ví dụ đời thường khác (Uber, giao thông, hồ nước) cho thấy data science giải quyết bài toán thực sẽ cho bạn thêm góc nhìn về giao thông và môi trường.
Nếu muốn học sâu, ngành này đang cần người
Cả y tế và quản lý thiên tai đều đang thiếu người làm data science có hiểu biết ngành dọc. Tại Mỹ, University of Chicago Graham School từng có chương trình Master of Science in Threat and Response Management đào tạo về ứng dụng dữ liệu trong quản lý thảm họa — tuy nhiên học phí, điều kiện nhập học và thậm chí tình trạng mở/đóng chương trình có thể đã thay đổi. Trước khi quyết định đăng ký, bạn nên kiểm tra trang chính hãng của trường để có thông tin cập nhật nhất. Tương tự, nếu bạn ở Việt Nam, các khóa học về data science tại đại học lớn cũng đang được mở rộng, nhưng lộ trình và chất lượng cần xác minh trước khi đầu tư thời gian.
Tóm lại bằng checklist cho người vừa đọc xong
- Data science không phải biểu đồ đẹp — nó là công cụ giúp bác sĩ và nhà khí tượng xử lý lượng thông tin mà con người không kham nổi.
- Predictive analytics (dự đoán từ dữ liệu quá khứ) và data mining (mò tìm mẫu ẩn trong dữ liệu lớn) là hai trụ cột kỹ thuật.
- Trong y tế, hệ thống gợi ý giúp bác sĩ ở bất kỳ đâu cũng tiếp cận được kiến thức mới nhất — khoảng cách chuyên môn được rút ngắn.
- Trong cảnh báo thiên tai, kết hợp dữ liệu truyền thống + mạng xã hội cho phép cảnh báo sớm hơn vài giờ — thời gian vàng để sơ tán.
- EMR (bệnh án điện tử) ẩn danh là nguồn dữ liệu vàng cho nghiên cứu y tế, nhưng phải bảo vệ quyền riêng tư bệnh nhân.
- Predictive analytics là trợ lý, không thay thế bác sĩ hay nhà khí tượng — quyết định cuối cùng vẫn là con người chịu trách nhiệm.
- Muốn học sâu thì bắt đầu từ project nhỏ, đừng nhảy thẳng vào chương trình thạc sĩ đắt tiền.
Nếu sau bài này bạn thấy data science đáng học hơn so với lúc bắt đầu đọc, thì mục tiêu bài viết đã đạt. Đây không phải môn lý thuyết xa vời — nó đang âm thầm giúp bác sĩ chọn đúng thuốc cho bệnh nhân ung thư, và giúp hàng ngàn người kịp rời khỏi vùng lũ trước khi nước dâng. Câu hỏi còn lại là bạn muốn bắt đầu từ đâu: đọc tiếp bài nền tảng, thử một project nhỏ với dữ liệu công khai, hay tìm hiểu lộ trình học chuyên sâu. Lựa chọn nào cũng hợp lý — miễn là bạn bắt đầu.
Tags
- machine learning
- ứng dụng y tế
- lộ trình học
- phân tích dữ liệu
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.