Data Science
Các Công Cụ Thương Mại Trong Data Science: Khi Nào Doanh Nghiệp Nên Chọn Phần Mềm Trả Phí
Phần mềm trả phí không thắng vì mạnh hơn PostgreSQL hay Airflow, mà thắng vì có người chịu trách nhiệm khi hệ thống sập, có vết kiểm toán, và chạy mượt trên hạ tầng cũ. Bài gom 7 nhóm công cụ thương mại theo 7 việc dự án dữ liệu doanh nghiệp thường làm, kèm gợi ý khi nào SME không cần mua.
 Phong Nguyen
PNTECH Writer · 16/09/2026
Ngân hàng, bảo hiểm, bán lẻ lớn vẫn trả tiền cho Oracle, Tableau, SPSS — vì sao?
Nếu open source đang miễn phí và mạnh như PostgreSQL, Airflow, MLflow, thì lý do gì khiến ngân hàng, công ty bảo hiểm, chuỗi bán lẻ lớn vẫn bỏ tiền mua Oracle, Tableau, SPSS? Câu trả lời ngắn: vì họ cần một bên chịu trách nhiệm khi hệ thống sập, cần truy vết được dữ liệu đã đi qua đâu (audit trail — tạm gọi là "vết kiểm toán"), và cần chạy mượt trên hạ tầng cũ mà đội ngũ nội bộ đã quen.
Ở góc người mới, bạn sẽ nghe loạt tên Oracle, SQL Server, Db2, Informatica PowerCenter, Tableau, Power BI, Cognos, SPSS Modeler, SAS Enterprise Miner, Watson Studio… và dễ rối. Bài này gom 7 nhóm công cụ thương mại trong data science theo đúng 7 việc mà dự án dữ liệu doanh nghiệp thường phải làm: lưu trữ, di chuyển và biến đổi dữ liệu, trực quan, dựng mô hình, triển khai, quản trị dữ liệu, và môi trường tích hợp đầu cuối. Mỗi nhóm đi kèm gợi ý: doanh nghiệp lớn vì sao vẫn trả tiền, và SME nhỏ khi nào không nhất thiết phải mua.
Nếu bạn muốn bức tranh tổng gồm cả open source lẫn thương mại trước, có thể xem bài tổng hợp 6 nhóm công cụ data science gồm cả open source và thương mại rồi quay lại đây đọc sâu phần trả phí.
Phần mềm thương mại khác gì so với mã nguồn mở?
Phần mềm thương mại là phần mềm trả phí, kèm hợp đồng với nhà cung cấp (vendor). Khi hệ thống lỗi giữa đêm, có đường dây gọi và đội kỹ thuật của hãng đến hỗ trợ. Khi cần nâng cấp, có lịch cam kết (SLA — Service Level Agreement, tức thỏa thuận mức độ dịch vụ: ví dụ hệ thống sập quá 4 giờ là hãng hoàn tiền). Khi cần chứng minh cho cơ quan quản lý rằng dữ liệu được xử lý đúng quy trình, có tài liệu chuẩn để dựa vào. Nói ngắn gọn: giống mua điều hòa có thợ đến tận nhà bảo hành, thay vì tự lắp và tự sửa.
Mã nguồn mở thì ngược lại. Bạn tải về miễn phí, xem được code, sửa theo ý muốn, nhưng khi hỏng thì tự lo. Cộng đồng có thể giúp, nhưng không ai cam kết thời gian xử lý. Bù lại, mã nguồn mở rẻ, linh hoạt, và có nhiều tài liệu hướng dẫn trên mạng.
Khi nào không nhất thiết phải mua bản trả phí? Khi dự án nhỏ, đội vài người, dữ liệu vài GB, chưa có yêu cầu kiểm toán hay tuân thủ pháp lý. Lúc đó PostgreSQL, Airflow, MLflow, Metabase kết hợp với cloud free tier (dùng thử miễn phí trên đám mây) đủ dùng. Mua phần mềm thương mại lúc này giống thuê đầu bếp 5 sao về nấu cho mình bữa cơm gia đình — lãng phí.
Nhóm 1: Lưu trữ dữ liệu (Data management)
Đây là tầng nền: nơi dữ liệu ngồi. Ba cái tên bạn sẽ gặp nhiều nhất ở doanh nghiệp lớn là Oracle Database, Microsoft SQL Server và IBM Db2. Cả ba đều là hệ quản trị cơ sở dữ liệu quan hệ (relational database — phần mềm lưu dữ liệu dạng bảng có liên kết với nhau), chạy ổn định trên máy chủ riêng của công ty hoặc trên cloud.
Vì sao họ không chuyển hết sang PostgreSQL hay MySQL miễn phí? Lý do thực dụng: có đội DBA (Database Administrator — người quản trị cơ sở dữ liệu) đã quen Oracle/SQL Server cả chục năm, sếp không muốn rủi ro đào tạo lại; cần đường dây hỗ trợ 24/7 từ nhà cung cấp vì downtime vài phút có thể mất tiền tỷ; cần chạy trên máy chủ cũ (on-premise — máy đặt tại công ty) vì dữ liệu nhạy cảm không được phép rời khỏi nước.
Ở Việt Nam, các ngân hàng thương mại cổ phần lớn vẫn chạy core banking trên Oracle hoặc SQL Server. Khi ngân hàng Nhà nước yêu cầu truy vết giao dịch trong vòng 24 giờ, họ cần nhà cung cấp có mặt tại Việt Nam để xử lý, không phải đợi cộng đồng PostgreSQL trả lời trên GitHub.
Cơ sở dữ liệu thương mại không thắng vì nhanh hơn PostgreSQL. Nó thắng vì khi hệ thống sập lúc 2 giờ sáng, có người nghe máy.
Nhóm 2: Di chuyển và biến đổi dữ liệu (ETL)
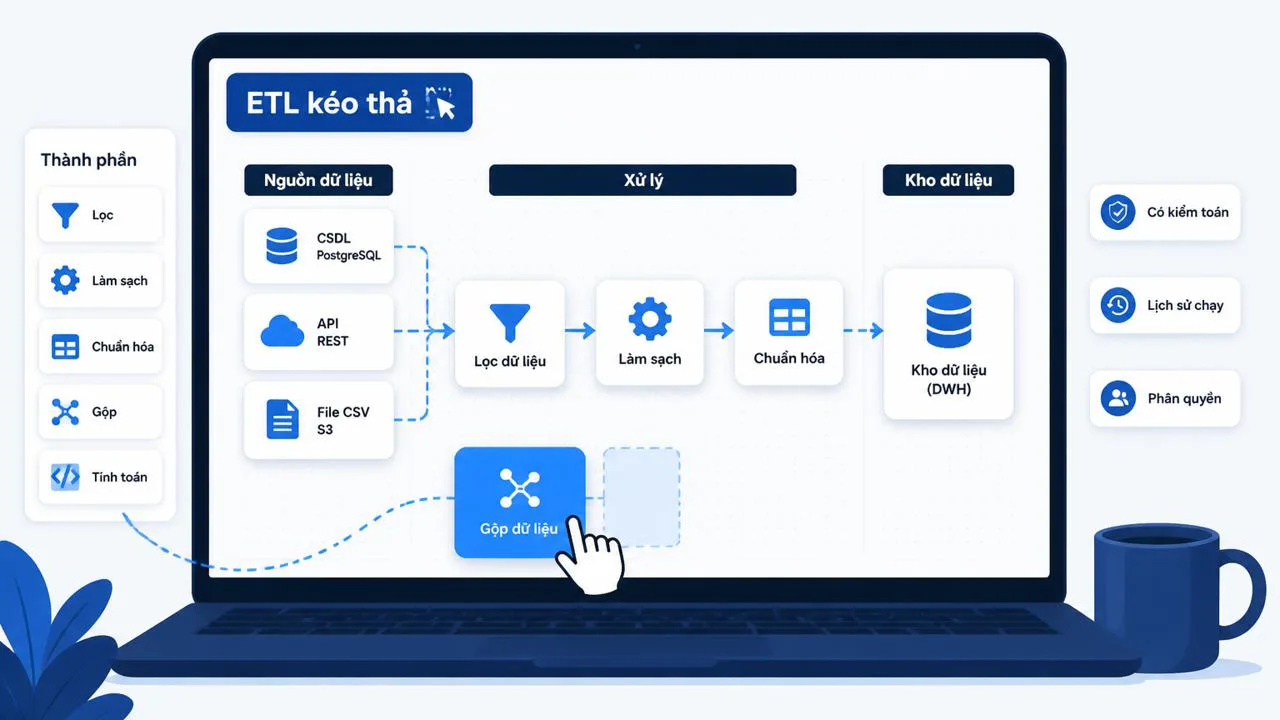
ETL là viết tắt của Extract (lấy dữ liệu ra từ nguồn), Transform (biến đổi cho đúng định dạng), Load (nạp vào nơi lưu mới). Ví dụ đời thường: mỗi sáng bạn lấy đơn hàng từ Shopee về Excel, gộp theo ngày, bỏ cột thừa, rồi nạp vào kho dữ liệu để phòng kế toán xem. ETL tool làm đúng quy trình đó, nhưng tự động và chạy hàng ngày.
Hai ông lớn trong nhóm này là Informatica PowerCenter và IBM InfoSphere DataStage. Ngoài ra còn SAP, Oracle Data Integrator, SAS Data Integration, Talend (có cả bản thương mại lẫn open source), Microsoft SQL Server Integration Services. Bài Hadoop, Spark và xử lý dữ liệu lớn bằng open source có nhắc đến Spark — công cụ xử lý dữ liệu lớn mã nguồn mở — với doanh nghiệp chỉ cần xử lý vài chục GB thì ETL thương mại dễ dựng hơn nhiều.
Điểm mạnh của nhóm trả phí: giao diện kéo thả (drag-and-drop — kéo thả khối chức năng thay vì viết code), hàng trăm connector có sẵn (connector là "cổng kết nối" giúp lấy dữ liệu từ SAP, Salesforce, MySQL, Excel…), lịch chạy tự động, và đặc biệt là người không biết code vẫn dựng được pipeline (pipeline là "đường ống" dẫn dữ liệu từ A sang B). Với đội vận hành 5–10 người, đây là khác biệt rất lớn so với Airflow hay Spark, nơi mọi thứ đều qua code Python.
Ở nhánh nhỏ hơn, IBM còn có Watson Studio Desktop với tính năng Data Refinery: mở dữ liệu dạng bảng ngay trong giao diện, lọc, sửa, xuất — giống Excel nhưng mạnh hơn và chạy trên dữ liệu lớn.
Nhóm 3: Trực quan hóa dữ liệu (Visualization)
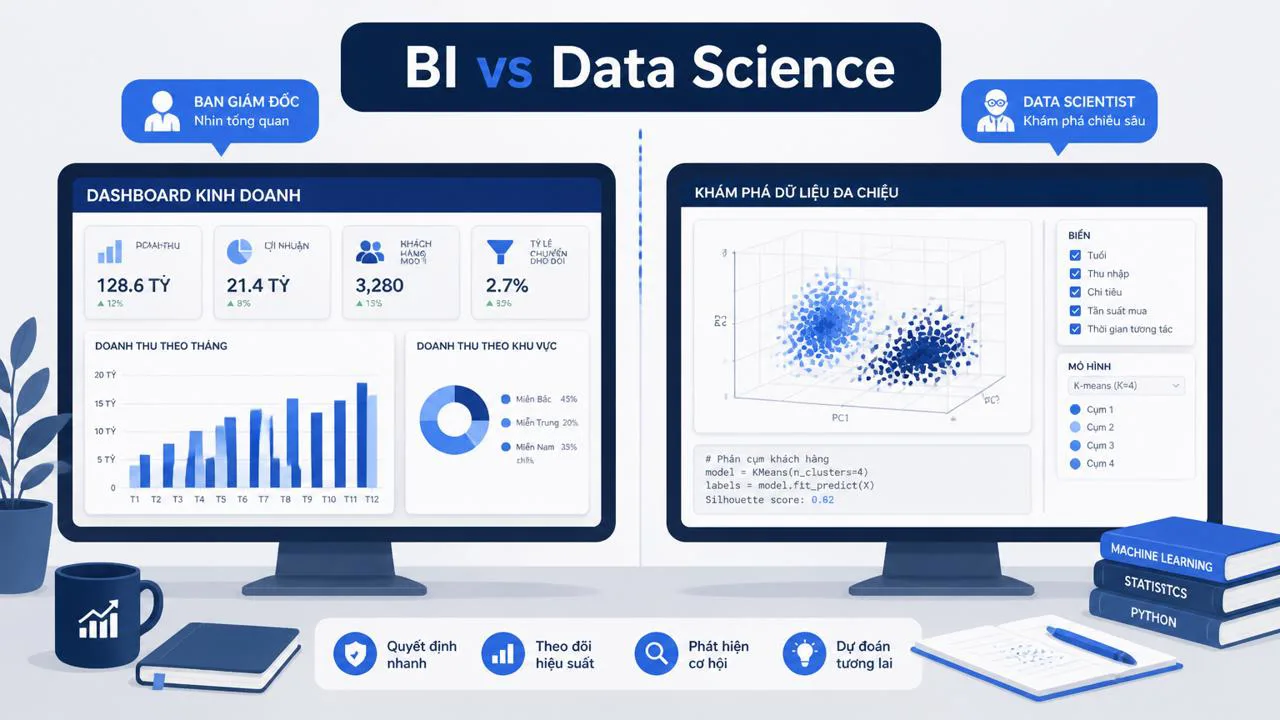
Có hai loại công cụ trực quan mà nhiều bạn mới hay nhầm. Loại thứ nhất là BI tools (Business Intelligence — công cụ phân tích kinh doanh cho người không chuyên), phục vụ sếp và phòng ban: Tableau, Microsoft Power BI, IBM Cognos Analytics. Loại này dựng dashboard (bảng điều khiển nhiều biểu đồ), lọc theo năm, theo khu vực, xem dữ liệu gần như thời gian thực, click vào ô nào là drill-down (đào sâu) vào chi tiết. Bài nguyên tắc chọn biểu đồ và công cụ trực quan hóa dữ liệu đi sâu hơn vào phần nguyên tắc.
Loại thứ hai là visualization cho data scientist, nằm trong các môi trường như Watson Studio Desktop. Loại này phục vụ khám phá dữ liệu: xem quan hệ giữa các cột, kiểm tra chất lượng dữ liệu, vẽ scatter plot (biểu đồ phân tán) để nhìn phân bố, vẽ box plot (biểu đồ hộp) để phát hiện giá trị bất thường. Đây là việc của người dựng mô hình, không phải việc của sếp.
Sai lầm thường gặp nhất ở người mới: dùng Tableau để khám phá correlation (tương quan — mức độ hai biến tăng/giảm cùng nhau) giữa hàng chục biến, mất cả ngày. Đúng ra phải dùng công cụ của data scientist. Ngược lại, nhiều bạn lại dựng biểu đồ đẹp bằng matplotlib trong Jupyter Notebook rồi gửi cho sếp — sếp không xem được vì phải cài Python. Lúc đó Tableau hay Power BI mới là lựa chọn đúng.
Nhóm 4: Dựng mô hình (Model building)
Dựng mô hình (model building) là bước dùng thuật toán để học từ dữ liệu, tạo ra một "mô hình" dùng để dự đoán hoặc phân loại. Data mining (khai phá dữ liệu) theo nghĩa truyền thống là dựng mô hình qua giao diện đồ họa, kéo thả các khối thuật toán thay vì viết code. Bạn có thể đọc lại quy trình 7 bước data mining từ dữ liệu thô đến quyết định để hình dung cả quy trình.
Hai cái tên lâu năm trong nhóm này là SPSS Modeler của IBM và SAS Enterprise Miner của SAS. Cả hai cho phép dựng mô hình dự đoán (churn khách hàng, rủi ro tín dụng, nhu cầu tồn kho) bằng cách ghép các khối thuật toán trên màn hình, không cần biết lập trình sâu. Phiên bản mới của SPSS Modeler hiện có trong Watson Studio Desktop, vẫn dùng workflow kéo thả nhưng tích hợp thêm Jupyter Notebook (giao diện chạy từng ô code Python/R phổ biến trong giới data) để chuyển sang code khi cần thuật toán đặc biệt.
H2O Driverless AI là công cụ tích hợp ở nhóm 7, nhưng cũng thuộc dạng "dựng mô hình tự động" (AutoML — tự động thử nhiều thuật toán và chọn cái tốt nhất). Với đội không có chuyên gia ML, đây là cách vào nhanh.
Nhóm 5: Triển khai và giám sát mô hình (Deployment & Monitoring)
Dựng xong mô hình chưa xong — còn phải triển khai (deployment) để app khác có thể gọi nó dự đoán. Hình dung như nấu xong món ở bếp, còn phải mở cửa hàng bán. Ở nhóm thương mại, IBM có SPSS Collaboration and Deployment Services để đưa mô hình SPSS lên server doanh nghiệp, có quy trình phê duyệt, versioning (quản lý nhiều phiên bản mô hình).
PMML (Predictive Model Markup Language) là định dạng file mở để xuất mô hình, để công cụ này dựng, công cụ khác đọc. Điểm hay của PMML là không bị khóa vào một nhà cung cấp — dựng bằng SAS, chạy bằng SPSS, hoặc ngược lại đều được. Thực tế hỗ trợ PMML ở mỗi phiên bản có khác nhau, cần kiểm tra khi dùng.
Phần giám sát (monitoring) là mảng mới: sau khi triển khai, cần theo dõi mô hình còn chính xác không, dữ liệu đầu vào có lệch không. IBM có Watson Open Scale cho phần này. Tuy nhiên ở mảng monitoring, các tool open source như MLflow, Evidently đang phát triển rất nhanh và được dùng phổ biến hơn; tình hình hỗ trợ thương mại năm 2025–2026 cần kiểm tra trực tiếp trên trang IBM để cập nhật.
Nhóm 6: Quản lý dữ liệu như tài sản (Data governance)
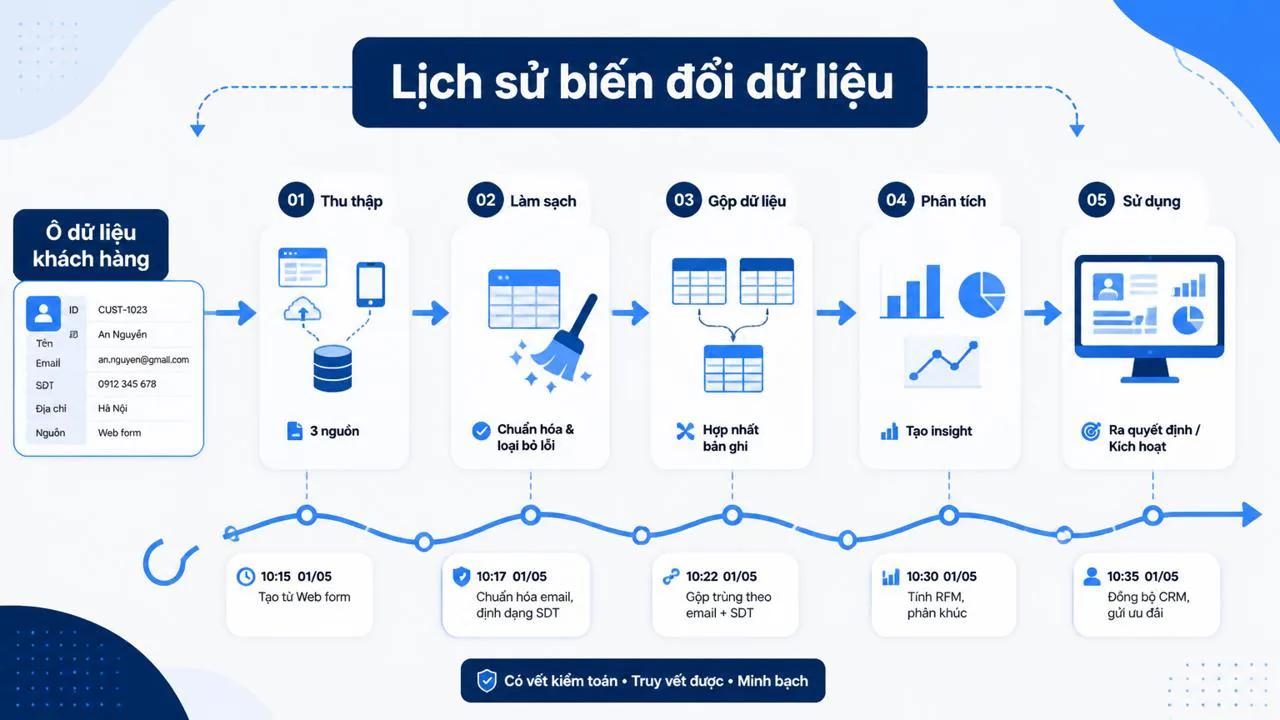
Data governance (quản trị dữ liệu) là quản dữ liệu như quản sổ đỏ nhà đất: biết ai sởữu, từ đâu đến, ai được đụng vào, lịch sử thay đổi ra sao. Nghe thì to tát, nhưng thực ra là ba thứ cụ thể: data dictionary (từ điển dữ liệu — file tra cứu cột nào nghĩa là gì), data steward/owner (người chịu trách nhiệm cho từng tập dữ liệu), và lineage (lịch sử biến đổi — dữ liệu này đã đi qua những bước nào, từ nguồn nào).
Hai sản phẩm dẫn đầu nhóm này là Informatica Enterprise Data Governance và IBM Information Governance Catalog. Cả hai đều cho phép gắn metadata (metadata = dữ liệu mô tả dữ liệu, kiểu như nhãn dán trên hộp), gắn người chịu trách nhiệm, lưu vết biến đổi, xuất báo cáo cho auditor (kiểm toán viên).
Tại sao nhóm này bắt buộc với doanh nghiệp lớn? Vì quy định pháp luật. Ngân hàng phải tuân thủ quy định của Ngân hàng Nhà nước về bảo mật thông tin khách hàng. Bệnh viện tư nhân phải tuân thủ Nghị định 13/2023 về bảo vệ dữ liệu cá nhân, cùng các quy định về y tế. Công ty đa quốc gia phải tuân thủ GDPR (quy định bảo vệ dữ liệu cá nhân của EU). Khi bị thanh tra, thiếu lineage là phạt.
Nhóm 7: Môi trường tích hợp đầu cuối (Integrated platforms)
Thay vì ghép 5–6 công cụ rời rạc, một số nhà cung cấp đóng gói cả vòng đời data science vào một môi trường duy nhất. Watson Studio + Watson Open Scale của IBM là ví dụ: từ dựng mô hình, đến triển khai, đến giám sát, đều trong cùng một giao diện. Có thể chạy on-premise (trên máy chủ công ty) hoặc trên Kubernetes/OpenShift — đây là các nền tảng giúp chạy ứng dụng đóng gói (container) và nhân bản dễ dàng, thay vì cài từng phần mềm thủ công.
H2O Driverless AI cũng thuộc dạng tích hợp, đặc biệt mạnh ở phần AutoML — tự động thử hàng chục thuật toán, tự chọn cái tốt nhất, tự giải thích mô hình. Với đội muốn có kết quả nhanh mà không tuyển được chuyên gia ML, đây là lựa chọn hợp lý.
Lợi ích lớn nhất của môi trường tích hợp: giảm chi phí ghép nối, dễ audit vì mọi thứ nằm một chỗ. Nhược điểm: vendor lock-in (bị phụ thuộc nhà cung cấp — chuyển sang hãng khác rất khó) và giá license thường cao hơn mua lẻ.
Môi trường tích hợp giống mua cả căn hộ có nội thất sẵn: tiện, nhưng không tháo ra bán lẻ từng đồ được.
Checklist chọn công cụ cho SME Việt
Không có công thức chung, nhưng có thể chia theo quy mô đội ngũ và dữ liệu:
Dưới 5 người, dữ liệu vài GB, dự án pilot (thử nghiệm): open source + cloud free tier đủ dùng. Cụ thể: PostgreSQL làm kho dữ liệu, Airflow hoặc Prefect chạy ETL, Jupyter Notebook dựng mô hình, Streamlit hoặc Metabase dựng dashboard, MLflow theo dõi mô hình. Chi phí license gần như bằng 0, chỉ tốn tiền cloud.
5–20 người, dữ liệu vài trăm GB đến vài TB, cần dashboard cho sếp xem hàng ngày, có một người vận hành chuyên trách: cân nhắc Power BI Pro hoặc Tableau Creator cho dashboard, kết hợp PostgreSQL + Airflow ở backend (phần hệ thống phía sau), có thể thuê thêm Informatica Cloud nếu cần kéo dữ liệu từ SAP. Ngân sách license khoảng vài trăm triệu đến một tỷ đồng mỗi năm tuỳ số user.
Trên 50 người, dữ liệu hàng chục TB, có yêu cầu compliance/audit, hoặc thuộc ngành ngân hàng/bảo hiểm/y tế: cân nhắc Tableau hoặc Power BI Premium cho BI, Informatica Cloud hoặc IBM DataStage cho ETL, Oracle hoặc SQL Server cho kho dữ liệu, IBM Information Governance Catalog cho data governance, và một nền tảng tích hợp như Watson Studio hoặc H2O Driverless AI cho data science.
Lưu ý quan trọng: giá license 2025–2026 thay đổi theo chính sách từng hãng và theo số user, cần verify trực tiếp trên trang chính hãng hoặc qua đối tác phân phối tại Việt Nam trước khi ký hợp đồng. Bài viết này không nêu con số cụ thể vì sẽ nhanh lỗi thời.
Tóm lại: khi nào doanh nghiệp nên trả tiền?
Công cụ thương mại thắng ở ba chỗ: có người chịu trách nhiệm khi hệ thống sập, có tài liệu chuẩn để trình auditor, và tích hợp sẵn với hệ thống cũ của doanh nghiệp lớn. Open source thắng ở ba chỗ khác: rẻ, linh hoạt, dễ tuyển người biết dùng. Doanh nghiệp lớn thường dùng cả hai, tận dụng open source ở phần linh hoạt và trả phí ở phần rủi ro cao.
Với SME Việt, khuyến nghị chung: bắt đầu bằng open source để hiểu bài toán, chỉ mua bản trả phí khi đã chạy được vài tháng và thấy điểm đau rõ ràng (downtime, audit, compliance). Đừng mua trước khi biết mình cần gì — sẽ tốn tiền mà vẫn không giải quyết được vấn đề.
Nếu bạn muốn so sánh chi tiết giữa bản thương mại và open source ở từng nhóm (ví dụ PostgreSQL với Oracle, Airflow với Informatica, MLflow với SPSS Modeler), bài tổng hợp 6 nhóm công cụ data science gồm cả open source và thương mại sẽ giúp bạn đối chiếu. Còn nếu đang cân nhắc chạy trên cloud thay vì mua máy chủ riêng, bài cloud cho data science và vì sao không còn cần máy khỏe giải thích rõ hơn về lựa chọn này.
Tags
- Tableau
- doanh nghiệp SME
- Oracle Database
- phần mềm thương mại
- data governance
- ETL thương mại
- quản trị dữ liệu
- SPSS Modeler
- công cụ data science
- audit trail
Câu hỏi thường gặp
Tiếp theo
Xem phần mềm — hoặc nhận tư vấn
Đọc xong thì chọn: phần mềm PN, công cụ khuyên dùng, hoặc nhờ mình làm theo nhu cầu.