Data Science
Nguồn Data Set Miễn Phí Và Có Phí Cho Data Science: Tổng Hợp Dễ Dùng Nhất
Tổng hợp hơn 20 nguồn data set miễn phí và có phí cho data science, chia theo lĩnh vực tài chính, y tế, tội phạm, học thuật. Kèm checklist 5 câu hỏi trước khi tải và lưu ý giấy phép sử dụng.
 Phong Nguyen
PNTECH Writer · 20/09/2026
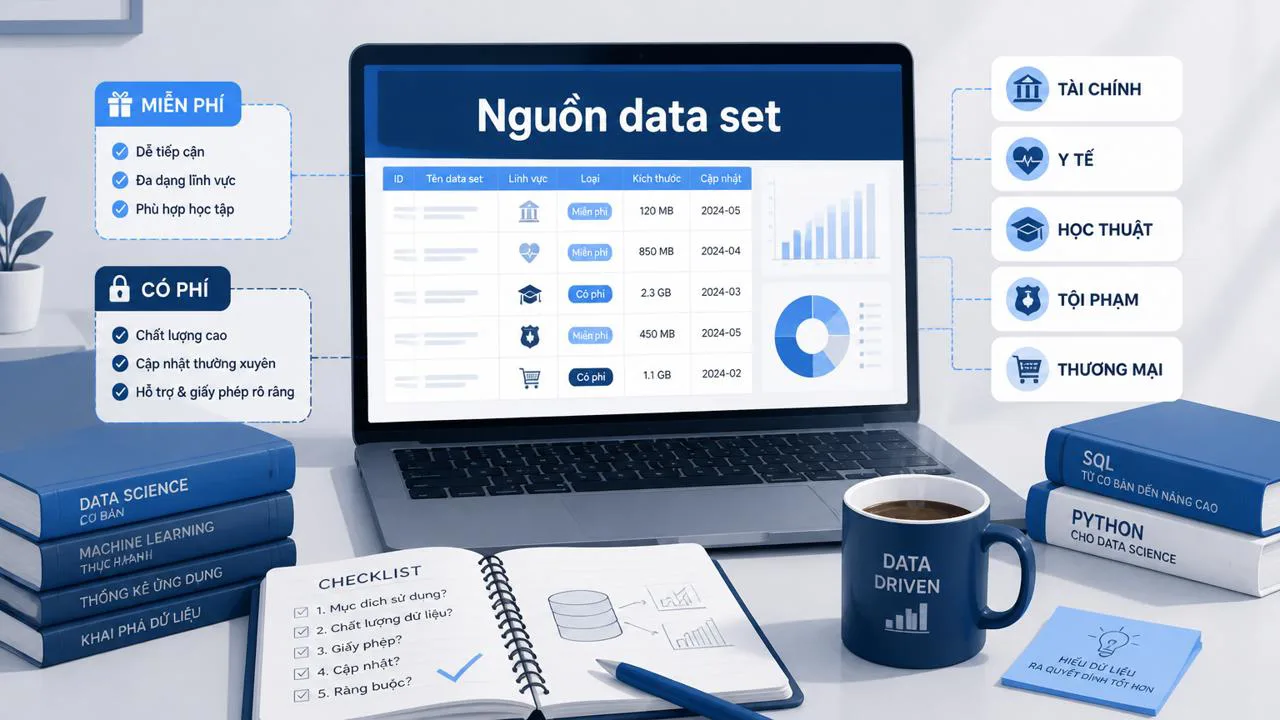
Nguồn data set miễn phí và có phí cho data science: danh sách đáng tin để bắt đầu ngay
Nếu bạn đang muốn làm data science mà chưa có dữ liệu trong tay, bài này gom lại hơn 20 nguồn data set — chia thành hai nhóm rõ ràng: miễn phí và có phí — đồng thời gợi ý mỗi nguồn phù hợp với bài toán nào. Bạn có thể đọc lướt theo lĩnh vực (tài chính, y tế, tội phạm, học thuật…) rồi chọn một nguồn để tải về và bắt tay vào project đầu tiên mà không phải mò Google cả buổi.
Một điểm quan trọng trước khi vào danh sách: nguồn data set miễn phí cho data science không phải lúc nào cũng đồng nghĩa với "dùng thoải mái cho mọi mục đích". Mỗi bộ dữ liệu đi kèm một giấy phép sử dụng — có loại cho phép dùng thương mại, có loại chỉ dùng cho học thuật, có loại yêu cầu ghi nguồn. trước khi tải, đọc lại bài data set là gì để hiểu cấu trúc và giấy phép sẽ giúp bạn tránh rắc rối về sau, đặc biệt khi muốn đưa project lên portfolio hoặc dùng cho sản phẩm thật.
Data set mở là gì và vì sao người mới nên bắt đầu từ đây
Data set mở (open data) là những bộ dữ liệu được công khai trên mạng, ai cũng có thể tải về mà không phải trả tiền. Ví dụ dễ hình dung nhất là bảng số liệu thời tiết hằng ngày của một thành phố — cơ quan khí tượng đăng lên web, bạn copy về phân tích lượng mưa trong 10 năm qua cũng được. Đặc điểm chung là: có nguồn rõ ràng, có tài liệu hướng dẫn, và thường đi kèm giấy phép cho phép dùng lại.
Với người mới, open data là điểm khởi đầu hợp lý vì ba lý do: dữ liệu đã được ai đó làm sạch ở mức cơ bản, cộng đồng đã có notebook hướng dẫn phân tích (đặc biệt trên Kaggle), và bạn không phải lo chuyện pháp lý khi đưa vào portfolio cá nhân. Hạn chế là open data thường cũ hơn dữ liệu thương mại vài tháng đến vài năm, và một số lĩnh vực (như hành vi người dùng chi tiết theo phút) hầu như không có open data.
Cần nhớ rằng "miễn phí" không có nghĩa là "không có điều kiện". Phần lớn open data đi kèm giấy phép kiểu CC-BY (ghi nguồn khi dùng lại) hoặc CDLA (giấy phép dành cho dữ liệu, cho phép chia sẻ và chỉnh sửa). bài data set là gì đã giải thích chi tiết các loại giấy phép này, bạn nên đọc qua một lần trước khi chọn nguồn cho project.
Nguồn data tài chính và kinh tế
Nhóm này phù hợp với bài toán kinh tế vĩ mô, phân tích thị trường, hoặc xây mô hình dự báo chuỗi thời gian tài chính. Đây cũng là nhóm có nhiều nguồn chất lượng cao vì ngân hàng trung ương và tổ chức quốc tế thường công bố dữ liệu định kỳ.
World Bank Open Data — kho dữ liệu của Ngân hàng Thế giới, chứa hàng nghìn chỉ tiêu kinh tế các quốc gia từ 1960 đến nay: GDP, dân số, tỷ lệ lạm phát, tỷ lệ biết chữ. Nếu bạn muốn làm project so sánh Việt Nam với các nước Đông Nam Á về tăng trưởng GDP, đây là nguồn nên mở đầu. Dữ liệu có thể tải trực tiếp qua giao diện web hoặc qua API (API là cách để chương trình của bạn tự động hỏi máy chủ lấy dữ liệu, thay vì bạn phải bấm tải tay từng file).
UN Comtrade — cơ sở dữ liệu thương mại của Liên Hợp Quốc, ghi nhận kim ngạch xuất nhập khẩu giữa các quốc gia. Phù hợp nếu bạn muốn phân tích "Việt Nam xuất gì sang Mỹ nhiều nhất trong 5 năm qua" hoặc xây dashboard theo dõi biến động xuất khẩu theo ngành hàng.
FRED (Federal Reserve Economic Data) — kho dữ liệu của Cục Dự trữ Liên bang St. Louis, chuyên về chuỗi thời gian kinh tế Mỹ: lãi suất, tỷ giá, chỉ số giá tiêu dùng, thất nghiệp. Đây là nguồn chuẩn cho bài toán dự báo kinh tế Mỹ hoặc tìm hiểu mối quan hệ giữa các chỉ số vĩ mô.
NBER (National Bureau of Economic Research) — viện nghiên cứu kinh tế hàng đầu của Mỹ, công bố dữ liệu đi kèm các bài nghiên cứu học thuật. Phù hợp nếu bạn muốn vừa đọc paper vừa tải data để tái hiện kết quả nghiên cứu.
Global Financial Data — một phần cho phép truy cập miễn phí, tập trung vào dữ liệu tài chính lịch sử dài hạn (giá cổ phiếu, chỉ số thị trường từ thế kỷ 19). Phần trả phí mở rộng phạm vi rất nhiều, nhưng bản miễn phí cũng đủ làm project nhỏ.
Với bài toán kinh tế vĩ mô, World Bank và FRED thường đủ dùng cho 80% project học thuật và portfolio cá nhân — không nhất thiết phải mua dữ liệu trả phí ngay từ đầu.
Nguồn data tội phạm và an ninh
Nhóm này phù hợp với ai quan tâm phân tích xu hướng xã hội, chính sách công, hoặc làm project về tội phạm học. Dữ liệu tội phạm thường có tính chuẩn hóa cao vì các cơ quan thực thi phải báo cáo định kỳ.
FBI UCR (Uniform Crime Reports) — báo cáo thống kê tội phạm thống nhất của FBI, ghi nhận số vụ án, loại tội, khu vực theo năm. Phù hợp để phân tích xu hướng tội phạm tại Mỹ hoặc so sánh giữa các bang.
NACJD / ICPSR — kho dữ liệu tội phạm học thuật do Đại học Michigan bảo trì. Nhiều bộ dữ liệu yêu cầu đăng ký tài khoản miễn phí nhưng giới hạn số request mỗi ngày — bạn nên kiểm tra trang chính hãng trước khi tải số lượng lớn.
NIDA (National Institute on Drug Abuse) — cung cấp dữ liệu về xu hướng sử dụng chất gây nghiện tại Mỹ, phù hợp project y tế công cộng hoặc nghiên cứu hành vi.
UNODC (United Nations Office on Drugs and Crime) — dữ liệu tội phạm và ma túy toàn cầu của Liên Hợp Quốc, có báo cáo theo quốc gia và theo năm. Phù hợp nếu bạn muốn làm bài so sánh tình hình tội phạm xuyên quốc gia.
Nguồn data y tế và khoa học đời sống
Đây là nhóm phong phú nhất về open data vì các tổ chức y tế và cơ quan nghiên cứu khoa học thường xuyên công bố dữ liệu để phục vụ cộng đồng. Lưu ý: phần lớn data y tế chỉ dùng cho mục đích nghiên cứu, không phải cho sản phẩm thương mại trực tiếp.
WHO GHO (Global Health Observatory) — kho dữ liệu sức khỏe toàn cầu của Tổ chức Y tế Thế giới, bao gồm các chỉ số như tuổi thọ trung bình, tỷ lệ tiêm chủng, tỷ lệ mắc bệnh theo quốc gia. Đây là nguồn chuẩn nếu bạn muốn làm dashboard sức khỏe cộng đồng.
FDA Food Data — cơ sở dữ liệu thành phần dinh dưỡng thực phẩm của Cục Quản lý Thực phẩm và Dược phẩm Mỹ. Hữu ích cho project phân tích dinh dưỡng hoặc xây ứng dụng gợi ý thực đơn.
SEER (Surveillance, Epidemiology, and End Results) — chương trình thống kê ung thư quốc gia của Mỹ, ghi nhận tỷ lệ mắc, sống sót, và tử vong theo loại ung thư và nhóm dân số. Phù hợp cho nghiên cứu ung thư học.
Open Science Data Cloud — nền tảng lưu trữ dữ liệu khoa học mở, phục vụ cộng đồng nghiên cứu. Dữ liệu đa dạng từ sinh học, thiên văn, đến khoa học xã hội.
NASA PDS (Planetary Data System) — kho dữ liệu hành tinh của NASA, ghi nhận thông tin từ các sứ mệnh thăm dò không gian. Phù hợp project thiên văn hoặc giáo dục STEM.
NASA Earthdata — dữ liệu quan sát Trái Đất từ vệ tinh: nhiệt độ bề mặt, chất lượng không khí, độ phủ rừng. Đây là nguồn rất phong phú cho project về biến đổi khí hậu hoặc nông nghiệp.
Nguồn data học thuật và kinh doanh
Nếu bạn đang làm project cho trường, làm luận văn, hoặc muốn kết hợp dữ liệu kinh doanh với phân tích, nhóm này sẽ hữu ích. Đặc điểm chung là dữ liệu có chất lượng cao nhưng thường yêu cầu đăng ký hoặc ghi nguồn.
Google Scholar — công cụ tìm kiếm bài báo học thuật. Bản thân nó không phải kho dữ liệu, nhưng rất nhiều paper đi kèm dataset mà tác giả đăng kèm. Khi đọc paper mà thấy có dataset, hãy cuộn xuống phần "Data Availability" hoặc "Supplementary Materials" để tìm link tải.
NCES (National Center for Education Statistics) — cơ sở dữ liệu giáo dục quốc gia Mỹ, bao gồm điểm thi, tỷ lệ nhập học, chi phí giáo dục. Phù hợp cho nghiên cứu về giáo dục hoặc phân tích chính sách.
Glassdoor Research — dữ liệu về lương, đánh giá công ty, và văn hóa doanh nghiệp. Phù hợp nếu bạn muốn phân tích "mức lương data scientist tại các công ty công nghệ lớn" hoặc so sánh điều kiện làm việc giữa các ngành.
Yelp Dataset — bộ dữ liệu review nhà hàng và dịch vụ tại Mỹ và Canada, được Yelp công bố định kỳ cho mục đích học thuật. Đây là nguồn rất phổ biến để thực hành phân tích sentiment (phân tích cảm xúc từ văn bản) hoặc hệ thống gợi ý.
Nguồn tổng hợp dễ vào nhất cho người mới
Nếu bạn chưa biết bắt đầu từ đâu, hai nguồn dưới đây thường là lựa chọn đầu tiên của hầu hết người học data science.
Kaggle Datasets — kho dữ liệu khổng lồ của cộng đồng Kaggle, chứa hàng chục nghìn bộ dữ liệu từ nhiều lĩnh vực. Mỗi dataset thường có notebook hướng dẫn phân tích đi kèm, giúp bạn vừa tải vừa học cách xử lý. sau khi có data, xem bài các nhóm công cụ data science để chọn tool xử lý sẽ giúp bạn biết nên dùng Pandas, Jupyter, hay BI tool nào cho từng loại data. Lưu ý: giấy phép trên Kaggle rất đa dạng — có dataset cho phép dùng thương mại, có dataset chỉ dùng cho học tập. Luôn kiểm tra cột "License" trước khi đưa vào project thật.
Reddit r/datasets — subreddit chuyên chia sẻ và thảo luận về dataset. Người dùng thường đăng link tới nguồn dữ liệu mới, kèm cảnh báo về chất lượng hoặc giấy phép. Đây là nơi tốt để khám phá những nguồn ít người biết, nhưng cần verify lại từ trang chính hãng trước khi dùng.
Proprietary dataset là gì và khi nào nên trả phí
Proprietary dataset (dữ liệu có chủ sở hữu) là những bộ dữ liệu do công ty hoặc tổ chức tạo ra, muốn dùng thì phải mua hoặc xin cấp phép. Ví dụ dễ hiểu: hãng xe A có dữ liệu chi tiết về hành vi lái xe từ hệ thống kết nối của họ — dữ liệu này rất giá trị cho bài toán bảo hiểm, nhưng hãng không công khai mà bán cho đối tác trả phí.
Với người mới, bạn thường không cần trả phí. Nhưng trong một số tình huống, nguồn trả phí lại hợp lý: khi open data không có lĩnh vực bạn cần (ví dụ dữ liệu hành vi người dùng trên app cụ thể), khi cần data cập nhật theo giờ thay vì theo năm, hoặc khi đã đi vào production và cần SLA (cam kết chất lượng dịch vụ) từ nhà cung cấp.
Một vài nguồn proprietary phổ biến:
- SGIM Compendium of Proprietary Datasets — danh mục các bộ dữ liệu y tế có chủ sở hữu, biên soạn bởi Hội Y học Nội khoa Tổng quát Mỹ. Phù hợp nếu bạn làm nghiên cứu y tế và cần truy cập dữ liệu bệnh viện chi tiết — quyền truy cập cần được xác minh qua từng nhà cung cấp.
- Datarade.ai — sàn giao dịch dữ liệu thương mại, nơi các nhà cung cấp đăng bán dữ liệu từ nhiều lĩnh vực (tài chính, marketing, IoT…). Bạn có thể tìm và so sánh giá trước khi mua.
- Google Cloud Datasets — bộ dữ liệu được Google cung cấp trên nền tảng GCP (Google Cloud Platform), trả phí theo lượng sử dụng. Nhiều bộ dữ liệu công khai (như bản đồ, ảnh vệ tinh) nhưng tính phí truy vấn và lưu trữ.
Quy tắc đơn giản: nếu open data đủ dùng và cập nhật trong vòng 1–2 năm, bạn chưa cần trả phí. Hãy chuyển sang nguồn proprietary khi bài toán đã rõ ràng và open data không đáp ứng được.
Checklist 5 câu hỏi trước khi tải một nguồn data
Trước khi bấm tải bất kỳ bộ dữ liệu nào, hãy tự hỏi nhanh năm câu sau — câu trả lời sẽ giúp bạn tránh mất thời gian vì chọn sai nguồn.
- Mục đích dùng là gì? Học tập cá nhân hay đưa vào sản phẩm thương mại? Hai mục đích này chấp nhận giấy phép khác nhau.
- Giấy phép cho phép dùng đến đâu? CC-BY chỉ cần ghi nguồn; CDLA cho phép chỉnh sửa và chia sẻ; một số giấy phép chỉ cho dùng phi thương mại.
- Dung lượng có xử lý nổi không? File vài trăm MB thì laptop cá nhân xử lý được; file vài chục GB thì cần máy mạnh hơn hoặc dùng cloud.
- Định dạng file là gì? CSV và JSON là phổ biến nhất và dễ đọc bằng Pandas; data tải về thường ở CSV/JSON — xem bài các định dạng file trong data science để biết cách xử lý từng loại. File PDF hay XML thường cần thêm bước trích xuất.
- Có cần đăng ký hoặc API key không? Nhiều nguồn yêu cầu tài khoản miễn phí và một "API key" — đây là chuỗi mật khẩu dùng để máy chủ nhận diện bạn khi chương trình tự động tải data. Một số nguồn giới hạn số request mỗi ngày, nên đọc kỹ điều khoản trước.
Lưu ý thực tế 2025–2026 khi dùng các nguồn này
Một vài điểm cần lưu ý vì chính sách truy cập dữ liệu thay đổi khá thường xuyên trong giai đoạn 2025–2026.
Thứ nhất, nhiều nguồn trước đây cho tải tự do giờ yêu cầu đăng ký tài khoản miễn phí và giới hạn số request mỗi ngày — kiểu "cho dùng nhưng không cho lạm dụng". Khi tải dataset lớn, bạn nên kiểm tra trang chính hãng xem có chính sách gì mới không, thay vì dựa vào hướng dẫn cũ.
Thứ hai, với người dùng tại Việt Nam, có một điểm khá thực tế: nguồn dữ liệu mở tiếng Việt chuẩn, cập nhật, và đủ lớn để làm project data science thật sự vẫn còn hạn chế. Một số cơ quan nhà nước có công bố dữ liệu, nhưng định dạng và giấy phép chưa thống nhất. Nếu bạn cần dữ liệu về thị trường nội địa, hãy cân nhắc kết hợp: lấy dữ liệu khung từ nguồn quốc tế (ví dụ World Bank cho GDP), kết hợp với dữ liệu bạn tự thu thập (scraper công khai từ các trang thương mại điện tử, báo chí). Cách này tốn công hơn nhưng cho ra bộ dữ liệu phù hợp với bài toán Việt Nam.
Tóm lại và bước tiếp theo
Danh sách trên đủ để bạn bắt đầu phần lớn project data science phổ biến: phân tích kinh tế vĩ mô (World Bank, FRED), xây dashboard sức khỏe (WHO GHO), làm project NLP với review (Yelp), hay đơn giản chỉ cần một bảng CSV sạch để vẽ biểu đồ đầu tiên (Kaggle). Hãy chọn một nguồn duy nhất, tải về, và đặt câu hỏi cụ thể mà bạn muốn data trả lời — đừng cố khám phá tất cả cùng lúc.
Khi đã có data trong tay, bước tiếp theo là chọn công cụ xử lý. bài các nhóm công cụ data science sẽ giúp bạn biết nên bắt đầu với Jupyter Notebook, Pandas, hay BI tool tùy theo mục tiêu. Còn nếu bạn vẫn đang mơ hồ về cấu trúc file CSV/JSON, bài các định dạng file trong data science sẽ giải thích từng loại bằng ví dụ cụ thể.
Tags
- nguồn data set
- data science
- giấy phép dữ liệu
- dataset y tế
- FRED
- dataset tài chính
- open data
- kaggle
- World Bank
- data set miễn phí
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.