Data Science
Modeling Trong Data Science — Case Study Suy Tim: Cân Bằng Độ Nhạy, Độ Đặc Hiệu Và Điều Chỉnh Tham Số
Accuracy 85% nghe đẹp nhưng có thể bỏ sót hơn nửa ca bệnh. Bài đi qua 3 lần chạy mô hình cây quyết định trên case suy tim để minh họa cân bằng giữa độ nhạy, độ đặc hiệu và chi phí âm tính giả.
 Phong Nguyen
PNTECH Writer · 24/09/2026
Một mô hình có độ chính xác tổng thể 85% nghe rất ấn tượng — nhưng trong case study suy tim sung huyết mà mình theo dõi, nó bỏ sót tới hơn một nửa số bệnh nhân thực sự có nguy cơ tái khám. Bài này đi qua 3 lần chạy mô hình cây quyết định thật trên cùng một bộ dữ liệu để xem vì sao accuracy cao chưa hẳn tốt, hai loại lỗi phân loại không đối xứng thế nào trong y tế, và cách điều chỉnh tham số để cân bằng giữa việc bỏ sót ca bệnh với can thiệp dự phòng thừa.
Modeling nằm ở đâu trong quy trình data science
Trong một quy trình data science điển hình, modeling là bước chạy thuật toán trên dữ liệu đã được làm sạch, gán nhãn và biến đổi ở giai đoạn chuẩn bị. Đây là lúc bạn "dạy" máy nhìn ra quy luật từ lịch sử, rồi mới đánh giá xem mô hình có thật sự hữu ích hay không. Nếu bạn chưa nắm rõ khái niệm modeling ở mức nền tảng, bài khái niệm modeling nền tảng giải thích bằng ví dụ đời thường rất dễ hình dung.
Case study trong bài này lấy từ chương From Understanding to Preparation và From Modeling to Evaluation trong bài học Personal Tracker — một bài toán dự đoán nguy cơ tái khám ở bệnh nhân suy tim sung huyết (CHF — congestive heart failure, tức tình trạng tim bơm máu không hiệu quả khiến dịch ứ trong phổi và các cơ quan). Đầu vào là hồ sơ bệnh án đã được chuẩn bị ở bước trước (xem lại phần data preparation cùng case CHF), đầu ra là một mô hình phân loại mỗi ca mới vào hai nhóm: có nguy cơ tái khám, hoặc không. Bài toán thuộc nhóm phân loại nhị phân — nghĩa là chỉ có hai kết quả để chọn.
Cây quyết định hoạt động như thế nào
Decision tree (cây quyết định) là một thuật toán phân loại bằng chuỗi câu hỏi có/không. Bạn có thể hình dung nó giống một sơ đồ flowchart ngược: bắt đầu từ một câu hỏi ở trên cùng, mỗi nhánh trả lời "có" hoặc "không" sẽ dẫn tới câu hỏi tiếp theo, cho tới khi chạm lá cuối cùng — lá đó chính là kết quả dự đoán.
Ví dụ đời thường với bệnh nhân CHF: "Bệnh nhân trên 65 tuổi chưa?". Nếu "không", rẽ sang một nhánh. Nếu "có", hỏi tiếp: "Có tiền sử nhập viện trong 6 tháng qua không?". Mỗi câu trả lời lại rẽ nhánh, cho tới khi mô hình quyết định bệnh nhân này thuộc nhóm tái khám hay không tái khám.
Vì sao case study này chọn cây quyết định thay vì các thuật toán phức tạp hơn? Lý do thực dụng: bác sĩ và nhân viên y tế có thể đọc cây quyết định trực tiếp mà không cần kiến thức toán — họ thấy luôn luật "nếu A thì B". Thêm nữa, cây quyết định cho phép gán chi phí khác nhau cho từng loại lỗi, đúng với bản chất không đối xứng của bài toán y tế.
Hai loại lỗi phân loại: dương tính giả và âm tính giả
Khi mô hình phân loại sai, có hai hướng sai hoàn toàn khác nhau:
- Dương tính giả (false positive): mô hình đoán "có tái khám" nhưng thực tế bệnh nhân này sẽ không tái khám. Chi phí là can thiệp dự phòng thừa: gọi điện nhắc, hẹn khám, cho thuốc dự phòng... tốn công sức và tiền bạc nhưng không gây hại trực tiếp.
- Âm tính giả (false negative): mô hình đoán "không tái khám" nhưng thực tế bệnh nhân này sẽ tái khám thật. Chi phí ở đây nặng hơn nhiều: bệnh nhân có nguy cơ cao bị bỏ sót, dẫn tới biến chứng, nhập viện cấp cứu, thậm chí tử vong — kèm theo chi phí điều trị khổng lồ về sau.
Điểm mấu chốt là hai lỗi này không đối xứng trong y tế. Một ca bỏ sót thường đáng sợ hơn nhiều ca can thiệp thừa. Đây chính là lý do vì sao mình không thể đánh giá mô hình chỉ bằng một con số accuracy tổng thể.
Trong y tế, một ca âm tính giả có thể nghĩa là một bệnh nhân nguy cơ cao bị bỏ qua — hậu quả không đo bằng tiền can thiệp thừa được.
Sensitivity, specificity và cái bẫy của accuracy
Ba chỉ số sau xuất hiện xuyên suốt case study, và bạn chỉ cần nhớ bằng ví dụ đời thường là đủ:
- Overall accuracy: trong tất cả ca, mô hình đoán đúng bao nhiêu phần trăm. Ví dụ accuracy 85% nghĩa là 100 ca thì đoán đúng 85.
- Sensitivity (độ nhạy): trong số ca thực sự "có tái khám", mô hình bắt được bao nhiêu phần trăm. Sensitivity 45% nghĩa là cứ 100 ca thực sự tái khám, mô hình chỉ phát hiện ra 45 ca, còn 55 ca bị bỏ sót.
- Specificity (độ đặc hiệu): trong số ca thực sự "không tái khám", mô hình đoán đúng bao nhiêu phần trăm. Specificity 85% nghĩa là 100 ca không tái khám thật, mô hình nhận ra đúng 85 ca là "không".
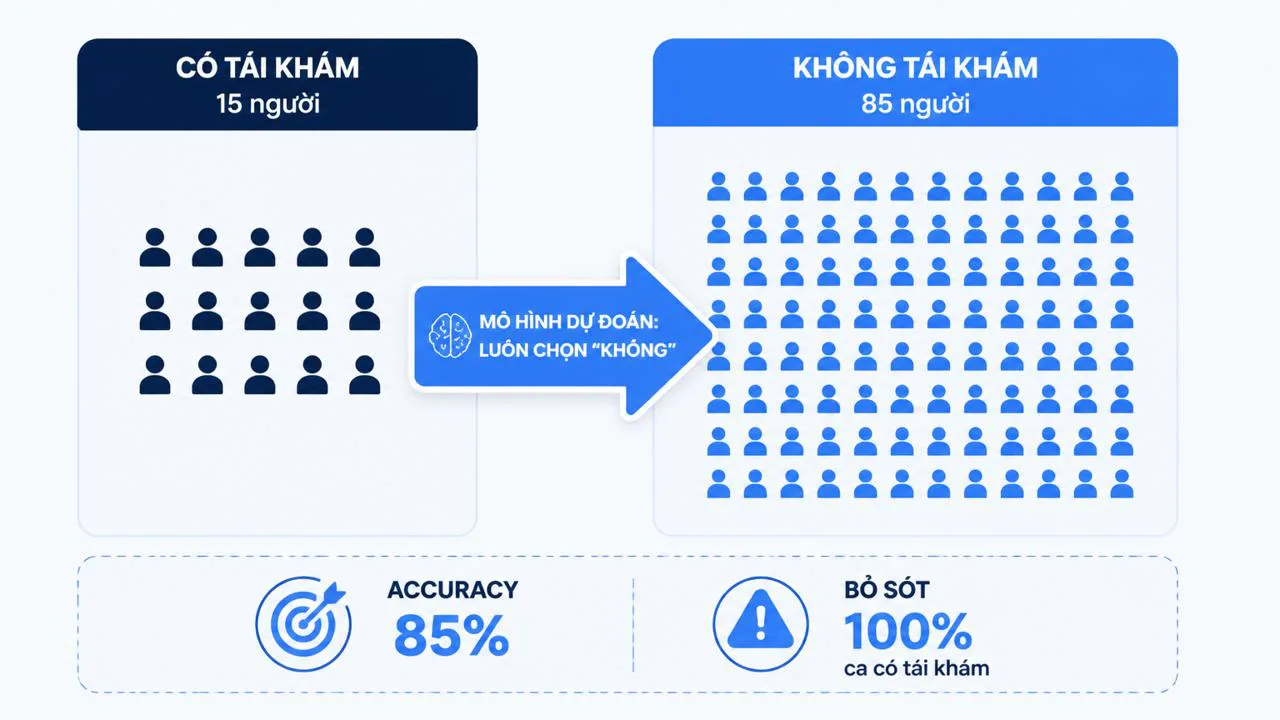
Cái bẫy cần nhớ: accuracy 85% nghe rất tốt, nhưng hoàn toàn có thể đạt được bằng một mô hình "lười biếng" — chỉ đoán "không" cho hầu hết mọi người. Nếu dữ liệu có 85% bệnh nhân không tái khám và 15% có tái khám, một mô hình đoán "không" cho tất cả mọi người sẽ đạt 85% accuracy — vô dụng hoàn toàn trong lâm sàng vì sensitivity lúc đó bằng 0.
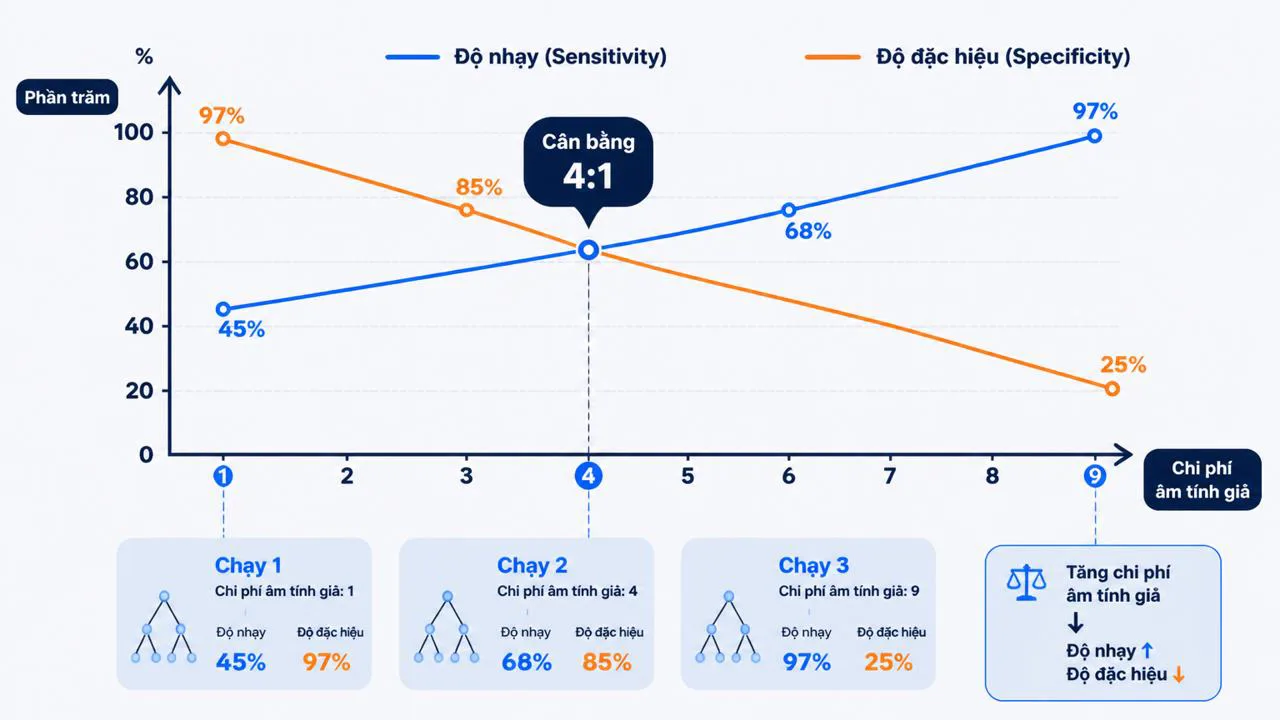
Lần chạy 1 — Chi phí mặc định 1:1
Lần chạy đầu tiên, mình dùng cây quyết định với chi phí mặc định 1:1 — tức cả hai loại lỗi được coi nặng ngang nhau. Kết quả thu được:
- Overall accuracy: 85%
- Sensitivity: 45%
85% accuracy nghe rất đẹp — nhưng sensitivity 45% có nghĩa là mô hình bỏ sót tới 55% bệnh nhân thực sự có nguy cơ tái khám. Trong bối cảnh y tế, đây là con số không thể chấp nhận: hơn một nửa số ca cần can thiệp bị bỏ qua. Lần chạy 1 cho thấy cần phải tinh chỉnh tham số, không thể dừng ở đây.
Lần chạy 2 — Đẩy cực đoan 9:1 và bài học "mô hình hoang tưởng"
Để giảm bỏ sót, mình tăng mạnh chi phí cho lỗi âm tính giả lên gấp 9 lần lỗi dương tính giả — tức mỗi lần mô hình đoán "không" sai cho một ca thực sự "có", nó bị "phạt" gấp 9 lần so với đoán "có" sai cho một ca thực sự "không".
Kết quả:
- Sensitivity: 97% (bắt được gần hết ca "có")
- Overall accuracy: tụt còn 49%
Đây là lúc mô hình trở thành "hoang tưởng" — nó đoán "có tái khám" cho gần như tất cả mọi người chỉ để tránh bỏ sót. Sensitivity tăng vọt nhưng specificity sụp đổ: hàng loạt bệnh nhân không có nguy cơ bị gán nhãn "có" và nhận can thiệp y tế dự phòng thừa. Chi phí y tế phình lên, bệnh nhân lo lắng vô cớ, hệ thống quá tải. Đẩy một chiều quá đà cũng nguy hiểm không kém bỏ sót hàng loạt.
Lần chạy 3 — Tìm điểm cân bằng 4:1
Sau hai lần thử cực trị, mình đặt chi phí ở mức hợp lý hơn: 4 cho lỗi âm tính giả, 1 cho lỗi dương tính giả. Kết quả thu được:
- Sensitivity: 68%
- Specificity: 85%
- Overall accuracy: 81%
Đây là lần chạy cân bằng nhất trong ba lần: bắt được 68% ca thực sự "có" — không hoàn hảo nhưng tốt hơn nhiều so với 45%, đồng thời vẫn giữ được specificity 85% nghĩa là không gán nhầm "có" cho quá nhiều ca thực sự "không". Accuracy tổng thể 81% chỉ giảm nhẹ so với lần 1, nhưng đổi lại sensitivity tăng 23 điểm phần trăm. Với một bộ training set kích thước nhỏ (vài trăm ca), đây là điểm cân bằng tốt nhất có thể đạt được.
Bảng so sánh 3 lần chạy
| Lần chạy | Chi phí âm tính giả : dương tính giả | Accuracy | Sensitivity | Specificity | Nhận xét |
|---|---|---|---|---|---|
| Lần 1 | 1 : 1 | 85% | 45% | ~không đo | Accuracy đẹp nhưng bỏ sót hơn nửa ca có |
| Lần 2 | 9 : 1 | 49% | 97% | rất thấp | Mô hình "hoang tưởng", gán gần hết là "có" |
| Lần 3 | 4 : 1 | 81% | 68% | 85% | Cân bằng tốt nhất với dữ liệu hiện có |
Mục tiêu không phải con số đẹp nhất — mà là sự đánh đổi hợp lý giữa bỏ sót ca bệnh và can thiệp thừa trong bối cảnh bài toán cụ thể.
Parameter tuning trong cây quyết định — nút vặn relative cost
Relative cost (chi phí tương đối) là tham số quan trọng nhất khi điều chỉnh cây quyết định cho bài toán có hai loại lỗi không đối xứng. Bạn có thể hiểu nó như một nút vặn: vặn sang trái là "không ngại can thiệp thừa, chỉ cần bắt cho hết ca có", vặn sang phải là "hạn chế báo động nhầm, chấp nhận bỏ sót một số ca".
Cách chọn tỷ lệ phù hợp dựa trên chi phí thực tế của từng loại lỗi:
- Chi phí một ca âm tính giả: tổng chi phí điều trị khi bệnh nhân tái khám thật + chi phí biến chứng + ảnh hưởng sức khỏe dài hạn. Trong bài toán CHF, con số này có thể lên tới hàng chục triệu đồng mỗi ca.
- Chi phí một ca dương tính giả: chi phí can thiệp dự phòng thừa (gọi điện, khám, thuốc dự phòng). Con số này thường thấp hơn nhiều — vài trăm nghìn tới vài triệu đồng.
Nếu chi phí hai bên chênh nhau rõ ràng, tỷ lệ nên lệch tương ứng — ví dụ một ca âm tính giả tốn gấp 5 lần ca dương tính giả thì thử cost ratio 5:1 trước. Nếu chưa biết chi phí thực, thử 2–3 mức (1:1, 4:1, 9:1) rồi so bảng kết quả — đó cũng chính xác là cách mình làm trong case study CHF.
Modeling là vòng lặp, không phải đích đến
Nhiều bạn mới nghĩ modeling là "chạy thuật toán một lần rồi xong". Thực tế trong case study CHF, mình đã phải chạy tới 3 lần với 3 cấu hình tham số khác nhau mới tìm được điểm cân bằng tạm chấp nhận được. Và nếu dữ liệu lớn hơn, có lẽ phải chạy nhiều hơn nữa.
Đặc biệt, khi đã tinh chỉnh tham số hết mức mà kết quả vẫn chưa tốt, bạn cần quay lại giai đoạn chuẩn bị dữ liệu: định nghĩa lại biến, thêm biến mới (ví dụ thông tin tuân thủ thuốc, chỉ số sinh học), thu thập thêm mẫu, hoặc thậm chí định nghĩa lại outcome (biến cần dự đoán). Modeling và data preparation là hai vòng lặp đan xen, không tách rời. Bạn có thể xem lại phần chuẩn bị dữ liệu ở data preparation cùng case CHF và bức tranh tổng thể của quy trình trong bài 10 giai đoạn data science methodology.
Sai lầm thường gặp và checklist trước khi chốt mô hình
Ba sai lầm phổ biến nhất khi đánh giá mô hình phân loại nhị phân trong bối cảnh không đối xứng:
- Chỉ nhìn accuracy tổng thể: như lần chạy 1 đã chứng minh, accuracy 85% có thể đi kèm bỏ sót 55% ca có.
- Đẩy một chiều quá đà: lần chạy 2 với cost ratio 9:1 tạo mô hình hoang tưởng, gây can thiệp thừa hàng loạt.
- Tưởng modeling là một lần chạy duy nhất: thực tế là vòng lặp giữa chạy thử, đánh giá, tinh chỉnh tham số, và đôi khi phải quay lại giai đoạn dữ liệu.
Checklist 5 bước trước khi chốt mô hình:
- Xác định rõ outcome of interest: trong bài toán y tế, đó là ca "có tái khám" hay "không tái khám"?
- Đo đủ ba chỉ số: sensitivity, specificity, overall accuracy — không chỉ accuracy.
- Thử ít nhất 2–3 mức relative cost (ví dụ 1:1, 4:1, 9:1) và ghi lại bảng kết quả.
- Chọn mô hình cân bằng nhất theo ngữ cảnh bài toán, không phải mô hình có con số đẹp nhất.
- Nếu không cải thiện được, quay lại giai đoạn chuẩn bị dữ liệu — thêm biến, thu thập thêm mẫu, định nghĩa lại biến.
Điểm cần nhớ và bước tiếp theo
Qua 3 lần chạy mô hình cây quyết định trên case study CHF, có ba điểm cốt lõi cần mang đi:
- Accuracy cao chưa hẳn tốt — phải đi kèm sensitivity đủ cao cho bài toán có rủi ro bỏ sót.
- Hai loại lỗi không đối xứng trong y tế: âm tính giả thường nặng hơn dương tính giả, và điều này phải phản ánh vào relative cost.
- Modeling là vòng lặp giữa chạy thử, tinh chỉnh tham số, và đôi khi quay lại giai đoạn dữ liệu.
Nếu bạn muốn đào sâu lý thuyết modeling từ góc khái niệm, đọc bài khái niệm modeling nền tảng. Nếu muốn xem lại toàn bộ phần chuẩn bị dữ liệu của cùng case CHF, đọc bài data preparation cùng case CHF. Bước tiếp theo sau modeling trong methodology là đánh giá (evaluation) và triển khai (deployment) — sẽ được đi sâu ở bài sau.
Lưu ý: số liệu 85% / 45% / 97% / 49% / 68% / 81% lấy từ bài học gốc trên Coursera (Personal Tracker — IBM Data Science Professional Certificate). Trước khi dùng làm dẫn chứng chính thức trong báo cáo hoặc bài giảng, nên đối chiếu lại với slide gốc của khóa học vì số liệu có thể được cập nhật qua các phiên bản.
Tags
- độ nhạy độ đặc hiệu
- accuracy sai lầm
- phân loại nhị phân
- cây quyết định
- modeling data science
- case study y tế
- suy tim sung huyết
- điều chỉnh tham số
- phương pháp luận data science
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.