Data Science
Analytic Approach Trong Data Science: Chọn Đúng Phương Pháp Trước Khi Chọn Thuật Toán
Chọn nhóm phương pháp phân tích theo câu hỏi kinh doanh trước khi chọn thuật toán. Bài đi vào giai đoạn 2 Data Science Methodology, ánh xạ câu hỏi sang nhóm phương pháp và giải thích vì sao Decision Tree hợp bài toán y tế cần giải thích được.
 Phong Nguyen
PNTECH Writer · 21/09/2026
Sau khi đã hiểu rõ bài toán ở giai đoạn 1 Business Understanding, nhiều người nhảy thẳng vào chọn thuật toán — Decision Tree, Random Forest, Neural Network, mới nhất là mô hình ngôn ngữ lớn. Đó là sai lầm phổ biến nhất khi mới học data science. Bước đúng phải là chọn hướng phân tích (analytic approach) trước: câu hỏi kinh doanh thuộc loại nào, thì nhóm phương pháp nào trả lời được. Chọn sai hướng, cả dự án đi lệch dù dùng thuật toán xịn đến đâu.
Bài viết này đi vào giai đoạn 2 — Analytic Approach trong Data Science Methodology của John Rollins (IBM), nối tiếp giai đoạn 1. Mục tiêu: giúp bạn biết cách đối chiếu câu hỏi với nhóm phương pháp, hiểu vì sao Decision Tree thường là lựa chọn hợp lý cho bài toán y tế, và nhìn ra những lỗi hay mắc khi chọn theo cảm tính.
Analytic Approach là gì và nằm ở đâu trong quy trình?
Trong 10 giai đoạn Data Science Methodology, Analytic Approach là giai đoạn 2, ngay sau khi bạn đã trả lời xong câu hỏi "mình muốn biết điều gì từ dữ liệu". Bạn có thể xem lại toàn bộ 10 giai đoạn Data Science Methodology để hình dung vị trí. Nếu giai đoạn 1 hỏi "bài toán là gì, ai cần kết quả, tiêu chí thành công ra sao", thì giai đoạn 2 hỏi tiếp: "với loại câu hỏi này, nhóm phương pháp nào phù hợp để trả lời?".
Nguyên tắc vàng ở đây: câu hỏi quyết định phương pháp, không phải ngược lại. Nhiều bạn mới thích thuật toán lắm, mở GitHub thấy mô hình X đang hot là áp dụng ngay. Nhưng nếu bài toán thực chất là tìm nhóm khách hàng tương tự nhau, mà bạn ép vào một mô hình dự đoán có nhãn, mô hình sẽ chạy ra — nhưng trả lời sai câu hỏi.
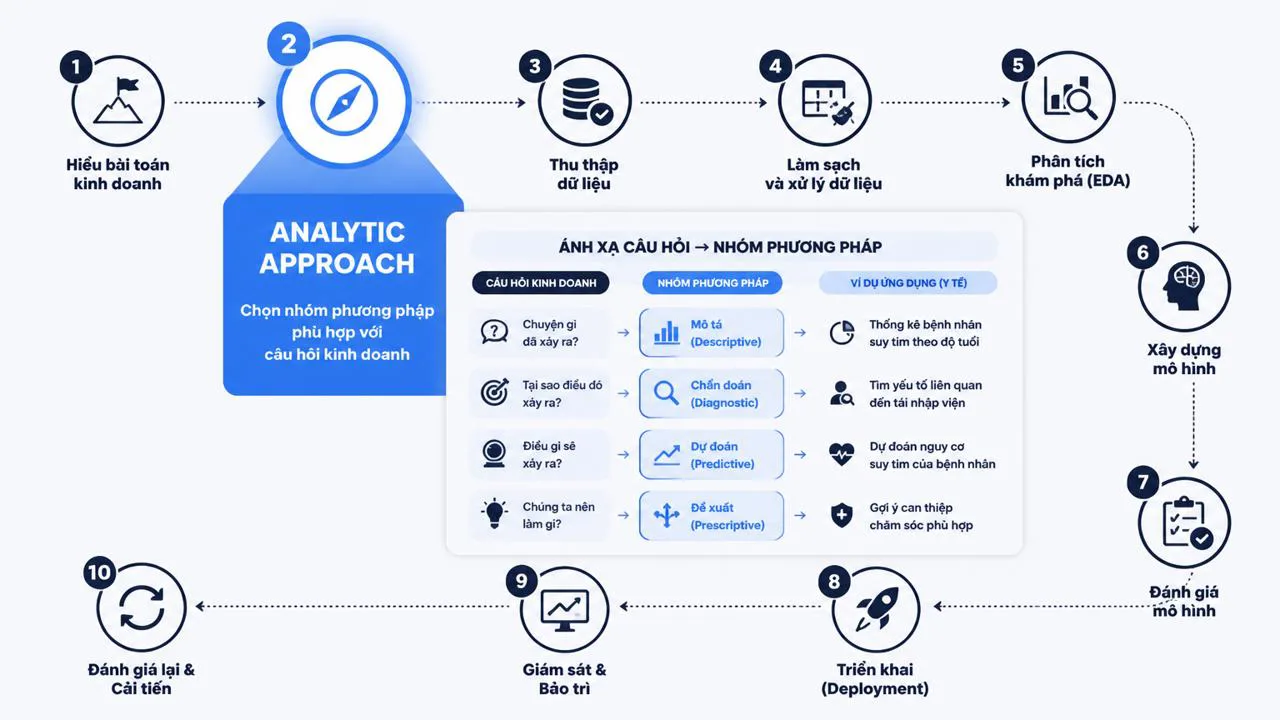
Analytic Approach không yêu cầu bạn chốt luôn một thuật toán cụ thể. Nó yêu cầu bạn chốt nhóm phương pháp (ví dụ: classification, clustering, association rule), rồi sau đó mới chọn thuật toán trong nhóm (Decision Tree, Random Forest, K-Means...). Việc chốt nhóm sớm giúp bạn tiết kiệm hàng tuần thử nghiệm sai hướng.
Bảng ánh xạ câu hỏi sang nhóm phương pháp
Đây là phần dễ nhớ nhất nếu bạn đang bắt đầu. Mỗi loại câu hỏi đời thường sẽ map sang một nhóm phương pháp tương ứng. Dưới đây là bảng tóm tắt, theo sau là giải thích từng ô bằng ví dụ quen thuộc.
| Loại câu hỏi | Ví dụ đời thường | Nhóm phương pháp |
|---|---|---|
| Chuyện gì sẽ xảy ra trong tương lai? Bao nhiêu? | Tháng tới doanh thu là bao nhiêu? | Predictive (dự đoán) |
| Mối quan hệ giữa A và B là gì? | Quảng cáo ảnh hưởng doanh thu thế nào? | Descriptive (mô tả quan hệ) |
| Có/Không, đếm tỷ lệ | Tỷ lệ khách rời bỏ là bao nhiêu? | Statistical Analysis (thống kê) |
| Gán vào nhãn rời rạc đã biết | Bệnh nhân này thuộc nhóm rủi ro cao/thấp? | Classification (phân loại) |
| Tìm nhóm tương tự hoặc quy luật đi kèm | Khách hàng chia được mấy nhóm hành vi? | Clustering & Association |
Predictive (dự đoán): Khi câu hỏi có chữ "bao nhiêu" hoặc "tháng tới, năm sau", bạn cần một mô hình ước lượng xác suất hoặc giá trị liên tục. Ví dụ: dự đoán doanh thu tháng sau, dự đoán giá nhà. Nếu cần đọc thêm khái niệm nền, bạn có thể tham khảo machine learning là gì và 3 loại học máy.
Descriptive (mô tả quan hệ): Khi câu hỏi là "A ảnh hưởng B thế nào", bạn thường dùng hồi quy (regression) hoặc phân tích tương quan. Mục tiêu không phải đoán tương lai, mà giải thích mối quan hệ đang tồn tại.
Statistical Analysis (phân tích thống kê): Khi câu hỏi đơn giản là "có/không, bao nhiêu phần trăm", đôi khi bạn không cần mô hình học máy, chỉ cần kiểm định giả thuyết hoặc tỷ lệ. Ví dụ: tỷ lệ khách hàng phản hồi trong chiến dịch A so với chiến dịch B có khác biệt thật không?
Classification (phân loại): Khi bạn đã có sẵn các nhãn rời rạc — ví dụ "rủi ro cao / rủi ro thấp", "spam / không spam", "mắc bệnh / không mắc" — bạn đang ở bài toán classification. Đầu ra là một nhãn, không phải con số liên tục.
Clustering & Association: Khi bạn chưa có nhãn và muốn máy tự tìm nhóm (clustering), hoặc muốn tìm quy luật "mua A thường mua kèm B" (association rule mining). Hai bài toán này khác nhau nhưng cùng thuộc nhóm unsupervised (không có nhãn sẵn).
Quy tắc dễ nhớ: bài toán có nhãn sẵn → Classification; bài toán không có nhãn và muốn máy tự chia nhóm → Clustering. Hai khái niệm này hay bị nhầm nhất.
Sau khi xem bảng trên, bạn nên tự đối chiếu bài toán của mình theo checklist ngắn:
- Câu hỏi có chứa từ "bao nhiêu", "tương lai"? → Predictive.
- Câu hỏi đo lường quan hệ giữa hai biến? → Descriptive.
- Câu hỏi yes/no hoặc đếm tỷ lệ đơn giản? → Statistical.
- Đã có nhãn rời rạc sẵn, muốn gán nhãn cho dữ liệu mới? → Classification.
- Chưa có nhãn, muốn máy tự tìm cấu trúc nhóm? → Clustering / Association.
Ví dụ thực tế: bệnh nhân suy tim có nguy cơ tái nhập viện không?
Để minh họa, lấy một case y tế cụ thể trong tài liệu gốc của IBM: bệnh nhân suy tim sung huyết (Congestive Heart Failure). Câu hỏi đặt ra: "Bệnh nhân nào có nguy cơ tái nhập viện trong thời gian tới?"
Đây là câu hỏi có/không — yes/no — gán cho từng bệnh nhân. Câu trả lời là một nhãn rời rạc: "rủi ro cao" hoặc "rủi ro thấp". Theo bảng ánh xạ ở trên, đây là bài toán Classification. Vậy chọn thuật toán nào trong nhóm classification?
Có nhiều lựa chọn: Logistic Regression, Decision Tree, Random Forest, Gradient Boosting, Deep Neural Network... Với bối cảnh y tế, tiêu chí hàng đầu không phải độ chính xác tuyệt đối, mà là khả năng giải thích được (interpretability). Bác sĩ — stakeholder phi kỹ thuật — cần đọc được vì sao mô hình đưa ra kết luận đó. Nếu bạn đưa một mô hình hộp đen, dù chính xác đến 99%, bác sĩ sẽ không tin và không dám dùng. Decision Tree là lựa chọn hợp lý vì mỗi quyết định đều có thể đọc thành câu tiếng Việt bình thường.
Nếu bạn muốn đọc thêm về các thuật toán khác trong nhóm này, có thể tham khảo tổng hợp các thuật toán data science cơ bản. Bài đó liệt kê rộng hơn, còn bài này tập trung vào lý do chọn.
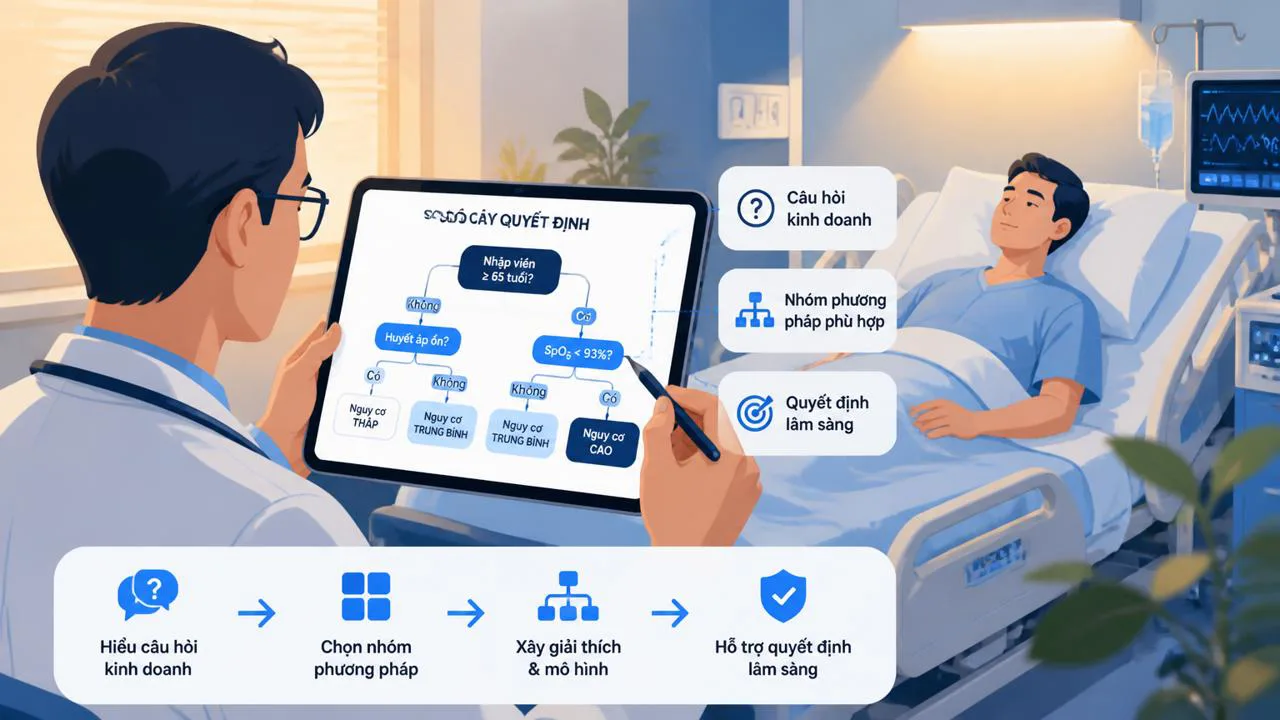
Decision Tree hoạt động thế nào trong bài toán này?
Nếu bạn từng đi khám bệnh, bạn đã làm quen với Decision Tree mà không biết. Bác sĩ hỏi: "Anh bao nhiêu tuổi?". Nếu trên 65, hỏi tiếp: "Huyết áp có cao không?". Nếu cao, hỏi tiếp: "Tiền sử có nhập viện không?". Cứ mỗi câu trả lời là đi vào một nhánh, cuối cùng ra một kết luận. Decision Tree mô phỏng đúng cách hỏi tuần tự đó.
Về mặt kỹ thuật, cây gồm các nút (node — điểm hỏi điều kiện) và các lá (leaf — điểm kết luận cuối). Mỗi nút là một điều kiện nhị phân, ví dụ: "tuổi > 65?". Mỗi lá chứa tỷ lệ bệnh nhân thực sự tái nhập viện, gọi là tỷ lệ yes/no.
Cách đọc kết quả cho một bệnh nhân cụ thể: bạn cho bệnh nhân đi từ gốc xuống lá theo các điều kiện của họ. Khi tới lá, lấy tỷ lệ yes tại lá đó làm xác suất rủi ro.
Giả sử lá cuối cùng cho bệnh nhân A có 12 bệnh nhân cùng đặc điểm trong dữ liệu lịch sử, trong đó 9 người tái nhập viện, 3 người không. Đa số là YES, nên rủi ro của bệnh nhân A được ước lượng là 9/12 = 75%. Ngược lại, nếu lá đó có 12 người nhưng chỉ 3 người tái nhập viện, 9 người không, đa số là NO, rủi ro được tính là 1 − 9/12 = 25%. Cách tính này bám sát nghĩa đen: nếu đa số lịch sử là tái nhập viện, xác suất bệnh nhân hiện tại cũng vậy là cao.
Vì sao Decision Tree phù hợp với stakeholder phi kỹ thuật
Trong dự án data science có hai loại mô hình: mô hình giải thích được (interpretable) và mô hình hộp đen (black-box). Decision Tree thuộc loại giải thích được. Deep Neural Network thuộc loại hộp đen: rất chính xác, nhưng khi hỏi "vì sao mô hình nghĩ bệnh nhân này rủi ro cao?", bạn không trả lời được.
Trong y tế, khả năng giải thích không phải tính năng phụ — đó là yêu cầu bắt buộc. Bác sĩ cần biết lý do để quyết định có cho bệnh nhân xuất viện hay không, có theo dõi thêm hay không. Mô hình hộp đen không đáp ứng được yêu cầu này dù chính xác hơn.
Decision Tree còn có lợi thế khác: linh hoạt theo thời gian. Bệnh nhân không đứng yên — họ thay đổi trạng thái mỗi ngày. Bạn có thể chạy nhiều cây cho nhiều mốc thời gian (lúc nhập viện, sau 30 ngày, sau 60 ngày) để có bức tranh rủi ro thay đổi theo thời gian. Mỗi cây trả lời một câu hỏi hơi khác, nhưng vẫn cùng ngôn ngữ dễ đọc.
Trong y tế và nhiều lĩnh vực chịu quản lý chặt, một mô hình chính xác mà không giải thích được có thể bị bác bỏ — dù chính xác hơn mô hình giải thích được.
Cùng bài toán, đổi câu hỏi là đổi phương pháp
Để thấy rõ câu hỏi quyết định phương pháp, hãy giữ nguyên dữ liệu bệnh nhân suy tim, nhưng đổi câu hỏi kinh doanh:
Câu hỏi 1: "Có nhóm bệnh nhân nào có hành vi tương tự nhau không, để thiết kế chương trình chăm sóc riêng?" → Đây là bài toán Clustering. Không có nhãn "rủi ro cao / thấp" sẵn, bạn muốn máy tự tìm nhóm. Thuật toán phổ biến: K-Means, Hierarchical Clustering.
Câu hỏi 2: "Triệu chứng nào thường đi kèm nhau ở bệnh nhân suy tim nặng?" → Đây là bài toán Association. Bạn muốn tìm quy luật "có X thì thường có Y". Thuật toán phổ biến: Apriori, FP-Growth.
Câu hỏi 3: "Xác suất bệnh nhân tái nhập viện trong 30 ngày tới là bao nhiêu?" → Đây là bài toán Predictive. Bạn cần con số phần trăm, không phải nhãn yes/no. Có thể dùng Logistic Regression, hoặc nếu muốn mô hình mạnh hơn thì Gradient Boosting.
Ba câu hỏi trên cùng dùng một bộ dữ liệu, nhưng mỗi câu đi với một nhóm phương pháp khác nhau. Nếu bạn lỡ chọn Decision Tree cho cả ba, bạn sẽ có câu trả lời cho câu 1 (classification), nhưng câu 2 và 3 sẽ trả lời sai hoặc không hiệu quả. Bài học: đừng chọn thuật toán trước khi hiểu câu hỏi.
Lỗi thường gặp và cảnh báo cần biết
Có bốn lỗi phổ biến mà người mới hay mắc khi ở giai đoạn Analytic Approach. Biết trước sẽ giúp bạn tránh mất hàng tuần.
Lỗi 1: Chọn thuật toán trước khi hiểu bài toán. Đây là lỗi phổ biến nhất. Bạn thấy bạn cùng dùng XGBoost, bạn cũng dùng XGBoost. Nhưng nếu bài toán thực chất là clustering, XGBoost có dùng cũng không ra kết quả đúng.
Lỗi 2: Nhầm Classification với Clustering. Classification có nhãn sẵn, bạn dùng để gán nhãn cho dữ liệu mới. Clustering không có nhãn, bạn dùng để máy tự chia nhóm. Hai khái niệm này nghe giống nhau nhưng bản chất khác nhau. Nếu dữ liệu chưa có nhãn, ép vào Classification sẽ cho kết quả vô nghĩa.
Lỗi 3: Decision Tree quá sâu dễ overfitting (quá khớp). Nếu để cây phát triển tới mức mỗi lá chỉ chứa 1-2 bệnh nhân, mô hình sẽ học thuộc dữ liệu huấn luyện thay vì học quy luật tổng quát. Khi áp dụng vào bệnh nhân mới, dự đoán sẽ sai. Cách xử lý: giới hạn độ sâu cây (max depth), yêu cầu mỗi lá chứa tối thiểu một số mẫu nhất định (min samples per leaf), và luôn kiểm tra trên tập dữ liệu độc lập (validation set) chưa từng thấy trong huấn luyện.
Lỗi 4: Nhầm "có kết quả" với "đúng câu hỏi". Một mô hình có thể chạy ra kết quả rất đẹp, độ chính xác 95%, nhưng nếu nó trả lời sai câu hỏi, nó vô dụng. Kiểm tra: câu hỏi bạn đặt ra ở giai đoạn 1 có được trả lời không? Có đúng đơn vị / đúng dạng kết quả không?
Hai cảnh báo kỹ thuật thêm: (a) khi dữ liệu thay đổi nhiều theo thời gian (như bệnh nhân), chạy một mô hình tĩnh có thể không đủ — cân nhắc chạy nhiều mô hình theo từng mốc. (b) Decision Tree nhạy cảm với dữ liệu nhiễu — một vài bản ghi bất thường có thể làm cây thay đổi đáng kể. Nếu cần ổn định hơn, có thể cân nhắc Random Forest (gồm nhiều cây) — tuy nhiên Random Forest kém interpretable hơn Decision Tree thuần.
Điểm cần nhớ và bước tiếp theo
Tóm lại, khi đã xác định xong bài toán ở giai đoạn 1, bạn cần nhớ sáu ý chính khi bước vào giai đoạn 2 Analytic Approach:
- Câu hỏi quyết định nhóm phương pháp, không phải ngược lại.
- Có 5 nhóm phương pháp chính: Predictive, Descriptive, Statistical Analysis, Classification, Clustering & Association.
- Classification có nhãn sẵn; Clustering không có nhãn — đừng nhầm.
- Trong bài toán y tế, Decision Tree thường được ưu tiên vì bác sĩ cần đọc được lý do.
- Decision Tree dễ bị overfitting nếu để cây quá sâu — luôn kiểm tra trên tập độc lập.
- Một bài toán có thể chạy nhiều mô hình cho nhiều mốc thời gian, mỗi mô hình trả lời một khía cạnh.
Sau khi chốt nhóm phương pháp và thuật toán, bước tiếp theo trong Data Science Methodology là xác định dữ liệu cần thu thập. Bạn có thể đọc thêm về data requirements trong data science để biết cách chuẩn bị dữ liệu cho mô hình vừa chọn. Nếu muốn nhìn lại toàn cảnh 10 giai đoạn, hãy mở lại toàn bộ 10 giai đoạn Data Science Methodology hoặc quay về giai đoạn 1 Business Understanding để xem bạn đã rõ bài toán chưa.
Cuối cùng, một lưu ý thực tế: công cụ, thuật toán và best practice trong data science thay đổi nhanh. Khi thấy hướng dẫn nào khác biệt với tài liệu năm 2025-2026, hãy kiểm tra trang chính hãng (scikit-learn, IBM, TensorFlow) để cập nhật. Đừng để kiến thức vài năm trước định hướng cho bài toán hôm nay.
Tags
- classification
- analytic approach
- data science methodology
- machine learning cơ bản
- clustering
- chọn thuật toán
- predictive modeling
- decision tree
- phân tích dữ liệu
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.