Data Science
Ứng Dụng Machine Learning Trong Đời Sống Và Tài Chính: Recommender, Phát Hiện Gian Lận, Predictive Analytics
Tổng quan các ứng dụng machine learning phổ biến trong đời sống và tài chính: gợi ý sản phẩm, phát hiện gian lận, dự đoán tín dụng. Giải thích recommender, classification, clustering, precision–recall, overfitting cho người mới.
 Phong Nguyen
PNTECH Writer · 15/09/2026
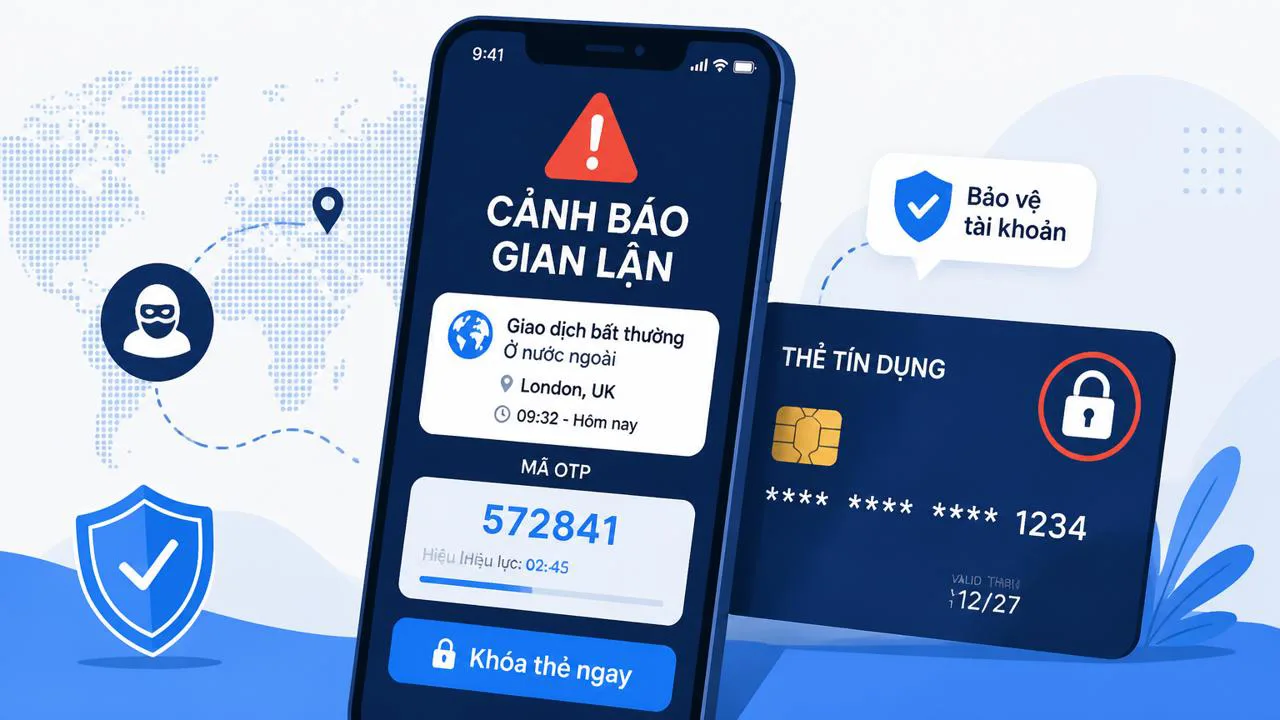
Bạn vừa xem xong một bộ phim trên Netflix, lướt tiếp thì thấy danh sách phim tương tự hiện ra đúng gu. Bạn mở app ngân hàng, giao dịch bất thường ở nước ngoài bị chặn và yêu cầu xác nhận bằng OTP (mã số dùng một lần gửi về điện thoại). Bạn vào sàn chứng khoán, hệ thống gợi ý cổ phiếu phù hợp với hồ sơ rủi ro của bạn. Tất cả những điều đó đều là ứng dụng machine learning — một nhánh của trí tuệ nhân tạo, nơi máy tính tự học quy luật từ dữ liệu thay vì được lập trình cứng từng bước. Bài viết này đi qua các ứng dụng phổ biến nhất của machine learning, đặc biệt trong tài chính, kèm những khái niệm cốt lõi mà người mới bắt đầu cần nắm trước khi áp dụng.
Machine learning (gọi tắt là ML) là một phần của AI và data science. Nếu bạn đang bắt đầu học data science, bạn sẽ gặp thuật ngữ này hàng ngày — vì hầu hết sản phẩm số quanh ta đều có một mô hình ML chạy phía sau.
Recommender system: gợi ý đúng thứ bạn muốn
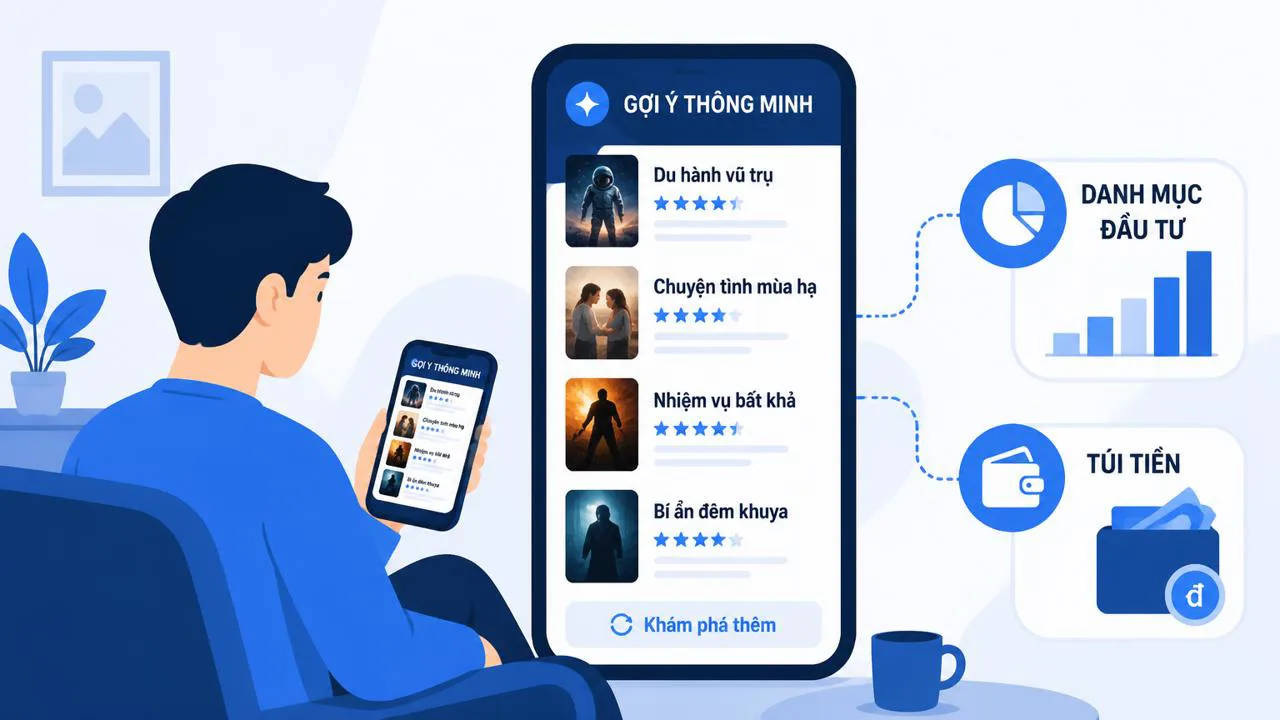
Recommender system là phần mềm dùng lịch sử hành vi của bạn (xem gì, mua gì, like gì) để đoán bạn sẽ thích gì tiếp theo. Bạn thấy nó ở khắp nơi: Netflix gợi ý phim, YouTube gợi ý video, Shopee gợi ý sản phẩm, Spotify gợi ý nhạc. Về bản chất, hệ thống này hoạt động theo bốn bước: thu thập dữ liệu hành vi, so sánh bạn với nhóm người tương tự hoặc với chính sản phẩm tương tự, chấm điểm mức độ phù hợp, rồi hiển thị kết quả lên giao diện.
Trong tài chính, cơ chế recommender cũng được áp dụng theo cách tương tự. Thay vì gợi ý phim, hệ thống gợi ý danh mục đầu tư, quỹ mở, hoặc sản phẩm bảo hiểm phù hợp với hồ sơ rủi ro và mục tiêu tài chính của bạn. Nhiều fintech Việt Nam đã bắt đầu dùng recommender để cá nhân hóa trải nghiệm khách hàng thay vì hiển thị một danh sách chung cho tất cả mọi người.
Classification và clustering: phân loại và tìm nhóm tự nhiên
Classification là bài toán phân một món đồ vào nhóm có sẵn. Ví dụ: giao dịch này là gian lận hay hợp lệ; email này là spam hay không; khách này có khả năng trả nợ hay không. Mô hình học từ các ví dụ trong quá khứ đã được gán nhãn, rồi áp dụng quy tắc cho dữ liệu mới.
Clustering khác classification ở chỗ: không có nhãn sẵn. Máy tính tự tìm ra các nhóm khách hàng có hành vi giống nhau mà bạn chưa từng nghĩ tới. Ví dụ: phân tích dữ liệu giao dịch của một ngân hàng, hệ thống có thể phát hiện ba nhóm khách hàng tự nhiên — nhóm tiết kiệm, nhóm đầu tư mạo hiểm, nhóm tiêu dùng — mà nhân viên ngân hàng chưa từng phân loại chính thức.
Một ứng dụng kinh điển của clustering là market basket analysis — phân tích giỏ hàng. Siêu thị nhận ra chips và soda hay được mua cùng nhau, từ đó sắp xếp kệ gần nhau hoặc tạo combo. Hai mươi năm trước, bài toán này rất khó vì dữ liệu quá lớn; giờ nó chạy thường ngày ở mọi cửa hàng bán lẻ có hệ thống thu thập dữ liệu. Bạn có thể đọc thêm về ứng dụng data science trong kinh doanh để thấy bức tranh rộng hơn.
Classification trả lời câu hỏi "món này thuộc nhóm nào"; clustering trả lời câu hỏi "tự nhiên có mấy nhóm trong dữ liệu này". Hai bài toán khác nhau, dùng khác nhau.
Predictive analytics: dự đoán tương lai từ dữ liệu
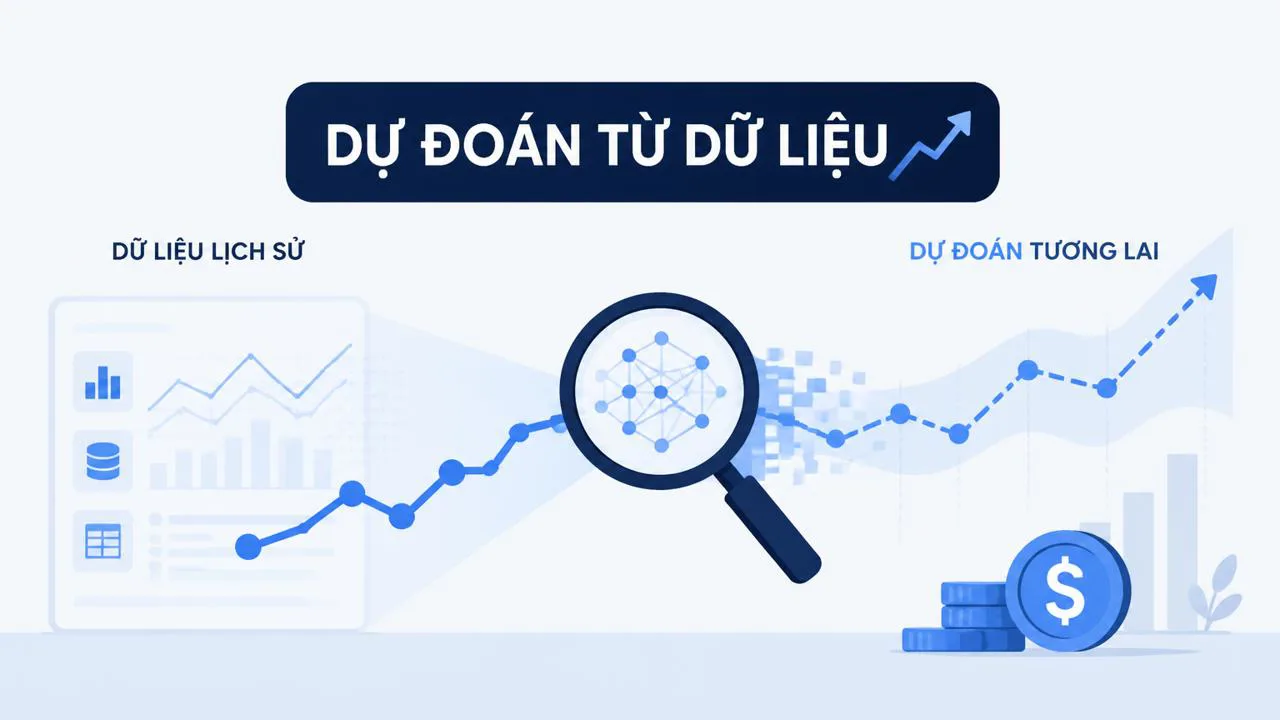
Predictive analytics là dùng dữ liệu quá khứ để ước đoán điều sẽ xảy ra trong tương lai. Ví dụ quen thuộc nhất là chấm điểm tín dụng (credit scoring): dựa vào lịch sử trả nợ, thu nhập, độ tuổi… hệ thống ước đoán khả năng bạn trả nợ đúng hạn trong tương lai. Ngân hàng dùng nó để quyết định cho vay hay không, và cho vay bao nhiêu.
Một ví dụ khác là churn prediction — dự đoán khách sẽ rời bỏ dịch vụ. Công ty viễn thông phát hiện một khách hàng gọi phản ánh nhiều hơn 30% trong tháng, dùng dữ liệu ít hơn 50% so với trước, hệ thống cảnh báo nhân viên chăm sóc khách hàng liên hệ giữ chân trước khi khách hủy thuê bao.
Khác với thống kê truyền thống với mẫu nhỏ và đánh giá một lần, predictive analytics thường dùng lượng dữ liệu lớn và mô hình được cập nhật liên tục khi có dữ liệu mới. Đây là lý do các sản phẩm số ngày càng chính xác theo thời gian — chúng đang học từ chính bạn.
Decision tree và naive Bayes: hai công cụ phổ biến người mới hay gặp
Decision tree (cây quyết định) là cách máy tính mô phỏng một chuỗi câu hỏi có/không để đi đến quyết định. Ví dụ: thu nhập hàng tháng trên 20 triệu? Có nợ xấu trong 2 năm qua? Đã từng vay và trả đúng hạn? Nếu đủ điều kiện thì duyệt vay, ngược lại từ chối. Cây càng sâu, câu hỏi càng nhiều, quyết định càng cụ thể.
Naive Bayes hoạt động theo hướng khác: cộng dồn xác suất từ nhiều dấu hiệu nhỏ. Ví dụ: email có từ "trúng thưởng" + có link lạ + gửi từ địa chỉ không quen → khả năng cao là spam. Thuật toán giả định mỗi dấu hiệu độc lập với nhau (đây là lý do gọi là "naive" — ngây thơ), dù thực tế không hoàn toàn đúng, nhưng trong nhiều bài toán vẫn cho kết quả tốt và chạy rất nhanh.
Cả hai thuật toán này đều có sẵn trong các thư viện Python và R phổ biến — bạn không cần tự viết code từ đầu. Quan trọng hơn là hiểu ý nghĩa và khi nào nên dùng thuật toán nào. Nếu muốn tìm hiểu sâu hơn về các thuật toán, bạn có thể đọc các thuật toán machine learning phổ biến trong data science hoặc các chủ đề và thuật toán data science cơ bản.
Precision, recall, overfitting: ba thứ phải biết trước khi tin một mô hình
Precision và recall là hai chỉ số đánh giá mô hình phân loại, thường xuyên được nhắc đến cùng nhau vì chúng có một mối quan hệ đánh đổi rất rõ ràng.
Precision (độ chính xác) trả lời câu hỏi: trong số những trường hợp mô hình đánh dấu là "gian lận", bao nhiêu trường hợp thực sự là gian lận? Recall (độ phủ) trả lời câu hỏi ngược lại: trong tổng số vụ gian lận thật, mô hình bắt được bao nhiêu?
Hai chỉ số này thường xung đột nhau. Nếu mô hình chỉ đánh dấu rất ít giao dịch là nghi ngờ (rất thận trọng), precision sẽ cao nhưng recall sẽ thấp — tức là nhiều vụ gian lận thật bị bỏ sót. Ngược lại, nếu mô hình đánh dấu quá nhiều, recall tăng nhưng precision giảm — tức là nhiều giao dịch hợp lệ bị chặn nhầm, khách hàng giận. Đây là lý do bài toán phát hiện gian lận và bài toán lọc spam thường chọn ngưỡng khác nhau: thiếu tiền vì miss fraud rất đau, nhưng chặn nhầm email quan trọng của khách cũng không chấp nhận được.
Overfitting là hiện tượng mô hình học thuộc dữ liệu cũ đến mức không làm được với dữ liệu mới. Ví dụ dễ hiểu: học sinh học thuộc lòng đáp án 10 bài kiểm tra cũ, nhưng gặp bài mới thì không giải được vì không hiểu bản chất. Mô hình ML cũng vậy — nếu quá phức tạp hoặc huấn luyện quá lâu trên một tập dữ liệu, nó sẽ "học vẹt" thay vì "học hiểu".
Oversampling là kỹ thuật xử lý khi dữ liệu lớp hiếm quá ít. Ví dụ: trong 10.000 giao dịch, chỉ có 50 giao dịch gian lận — mô hình sẽ không học được gì vì lớp "gian lận" quá nhỏ. Oversampling nhân bản dữ liệu lớp hiếm lên để mô hình có đủ ví dụ học. Nhưng nếu lạm dụng, đánh giá trên dữ liệu đã nhân bản sẽ cho kết quả đẹp một cách giả tạo.
Ví dụ thực tế trong tài chính và bán lẻ
Hai ví dụ dưới đây giúp bạn hình dung ML đang chạy đâu đó quanh bạn hàng ngày.
Gợi ý ý tưởng đầu tư kiểu Netflix: app đầu tư phân tích bạn đã xem quỹ nào, đã mua cổ phiếu ngành nào, mức độ rủi ro bạn chấp nhận; từ đó gợi ý danh mục hoặc sản phẩm tài chính phù hợp. Cơ chế giống hệt Netflix gợi ý phim, chỉ khác là "sản phẩm" là tiền chứ không phải phim. Điểm cần lưu ý: gợi ý đầu tư có thể sai, và khi sai thì hậu quả là tiền mất chứ không phải chỉ mất thời gian xem phim dở.
Phát hiện gian lận thẻ tín dụng real-time: bạn đang ở Hà Nội mà thẻ vừa quẹt ở Brazil vài phút trước — hệ thống chặn giao dịch, gửi OTP về điện thoại để xác nhận, đồng thời cảnh báo nhân viên. Toàn bộ quy trình diễn ra trong vài giây nhờ mô hình classification chạy liên tục, so sánh giao dịch mới với hàng triệu giao dịch đã học.
Market basket analysis trong siêu thị: hệ thống phát hiện khách mua bỉm thường mua thêm bia; siêu thị sắp xếp hai mặt hàng ở hai đầu hành lang để khách đi qua nhiều sản phẩm khác. Nghe vô lý nhưng đây là case kinh điển trong ngành bán lẻ (cần verify nguồn nếu bạn muốn trích dẫn số liệu cụ thể).
Một mô hình ML "chạy được" không có nghĩa là an toàn để triển khai. Bạn cần hiểu nó đang sai ở đâu, sai bao nhiêu, và sai như thế có chấp nhận được không.
Sai lầm phổ biến người mới hay mắc
Dùng ML như hộp đen không hiểu gì: nhiều người ném dữ liệu vào thư viện, nhận kết quả, đưa ra quyết định mà không hiểu mô hình đang dựa vào đâu. Khi mô hình sai, họ không biết sai ở đâu để sửa. Cách tránh: luôn dành thời gian xem mô hình dựa vào biến nào, biến nào có ý nghĩa thực tế, biến nào chỉ là nhiễu.
Chỉ tối ưu một chỉ số: nếu bạn chỉ nhìn precision mà quên recall (hoặc ngược lại), mô hình có thể trông đẹp trên giấy nhưng thảm họa khi chạy thật. Ví dụ: mô hình phát hiện gian lận với precision 99% nghe rất tốt, nhưng nếu recall chỉ 10% nghĩa là bạn bỏ sót 90% vụ gian lận — precision cao vô nghĩa.
Để mô hình overfit dữ liệu cũ: huấn luyện quá lâu trên một tập dữ liệu mà không kiểm tra trên tập dữ liệu mới. Cách tránh: luôn chia dữ liệu thành tập huấn luyện và tập kiểm tra, đánh giá mô hình trên dữ liệu mô hình chưa thấy.
Lạm dụng oversampling: nhân bản dữ liệu lớp hiếm quá nhiều khiến đánh giá sai. Cách tránh: đánh giá cuối cùng nên thực hiện trên dữ liệu gốc, không phải dữ liệu đã nhân bản.
Tóm tắt một phút cho người mới
- Machine learning đang chạy ở khắp nơi — từ gợi ý phim đến phát hiện gian lận thẻ.
- Recommender system dùng được cho cả phim và ý tưởng đầu tư, cơ chế giống nhau.
- Phát hiện gian lận là bài toán classification kinh điển, nhưng cần cân nhắc precision–recall.
- Decision tree và naive Bayes là hai thuật toán phổ biến, hiểu ý nghĩa quan trọng hơn nhớ công thức.
- Precision và recall luôn là một đánh đổi — chọn cái nào tùy thuộc vào bài toán cụ thể.
- Overfitting và oversampling là hai cách mô hình "đẹp" lúc phát triển nhưng "chết" lúc chạy thật.
Nếu bạn muốn đào sâu hơn vào các thuật toán cụ thể hoặc các mô hình phức tạp hơn như neural network (mạng nơ-ron nhân tạo — mô hình học sâu mô phỏng cách não bộ xử lý thông tin), bạn có thể đọc tiếp deep learning cơ bản và ứng dụng thực tế. Lưu ý rằng giá và tính năng của các thư viện ML có thể thay đổi theo từng năm; khi bắt đầu thực hành, hãy kiểm tra trang chính hãng của thư viện bạn chọn để có thông tin cập nhật nhất.
Tags
- dự đoán dữ liệu
- phân loại dữ liệu
- chấm điểm tín dụng
- machine learning cơ bản
- phát hiện gian lận
- precision và recall
- học data science
- machine learning tài chính
- ứng dụng machine learning
- recommender system
Câu hỏi thường gặp
Tiếp theo
Xem phần mềm — hoặc nhận tư vấn
Đọc xong thì chọn: phần mềm PN, công cụ khuyên dùng, hoặc nhờ mình làm theo nhu cầu.