Data Science
Data Warehouse Là Gì? Kho Dữ Liệu Tập Trung Cho Phân Tích Và Data Science
Data Warehouse là kho dữ liệu tập trung, tối ưu cho truy vấn và phân tích lớn. Bài phân biệt DWH với Database và Data Lake, giải thích kiến trúc 4 lớp và gợi ý khi nào cá nhân, SME thực sự cần.
 Phong Nguyen
PNTECH Writer · 21/09/2026
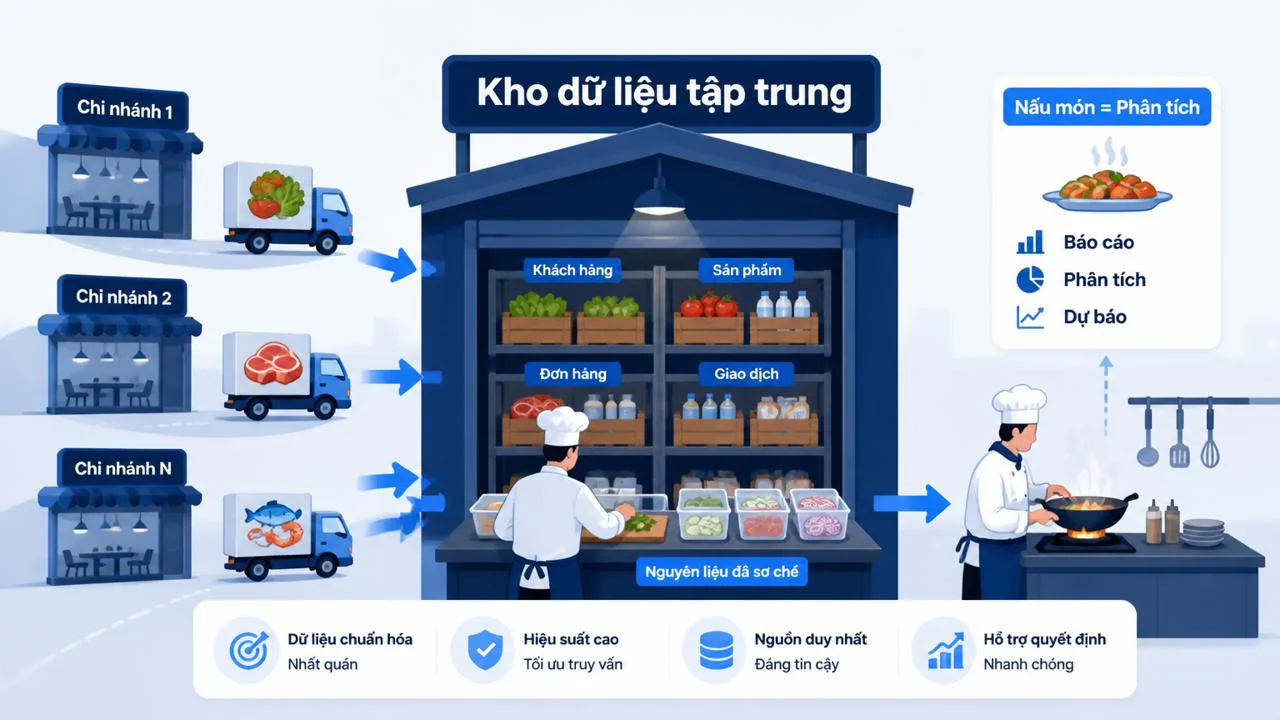
Data Warehouse nghe thì to tát, nhưng bạn hình dung nó giống bếp trung tâm của một nhà hàng là dễ nắm nhất. Mỗi chi nhánh gửi nguyên liệu thô về, đầu bếp ở bếp trung tâm sơ chế, phân loại, đóng gói sẵn — để khi cần nấu món (phân tích, làm báo cáo, huấn luyện mô hình), đầu bếp chỉ việc lấy ra dùng, không phải đi chợ từng ngày.
Bài viết này giải thích Data Warehouse là gì theo cách đời thường nhất, phân biệt với Database thường và Data Lake — hai khái niệm hay bị trộn lẫn — rồi đi vào vai trò thật của nó trong quy trình data science là gì và quy trình tổng thể. Mục tiêu: sau khi đọc xong, bạn biết mình có cần một kho dữ liệu cho dự án của mình hay chưa, và nếu cần thì bắt đầu từ đâu.
Data Warehouse là gì theo nghĩa đơn giản nhất
Data Warehouse (gọi tắt là DWH, tiếng Việt hay dịch là "kho dữ liệu") là một hệ thống lưu trữ tập trung, được thiết kế riêng cho việc truy vấn và phân tích dữ liệu lớn — chứ không phải để xử lý giao dịch hằng ngày như khi bạn bán hàng, rút tiền, hay cập nhật đơn [S1][S2].
Hình dung thế này: bạn có một chuỗi cửa hàng nhỏ với 5 chi nhánh. Mỗi chi nhánh có sổ ghi chép bán hàng riêng (đó là Database của từng cửa hàng). Mỗi tối, sổ của 5 chi nhánh được gom về một kho tổng, ở đó nhân viên văn phòng tổng hợp lại thành một bảng doanh thu thống nhất: ai bán được gì, khu vực nào, ngày nào. Cái kho tổng đó chính là Data Warehouse.
Điểm mấu chốt để nhớ: Data Warehouse không phải nơi dữ liệu được tạo ra, mà là nơi dữ liệu từ nhiều nguồn được gộp lại, làm sạch và chuẩn hoá để phục vụ việc phân tích và ra quyết định.
Có ba đặc điểm dễ nhớ để nhận diện một Data Warehouse "đúng chuẩn":
- Tích hợp nhiều nguồn: CRM (phần mềm chăm sóc khách hàng), ERP (phần mềm quản lý doanh nghiệp), app bán hàng, file Excel từ kế toán, log từ web… tất cả được đưa về cùng một chỗ [S3][S4].
- Dữ liệu sạch và thống nhất: cùng một khách hàng "Nguyễn Văn A" và "Nguyen Van A" và "A Nguyễn" sẽ được gộp thành một bản ghi duy nhất, cùng một đơn vị tiền tệ, cùng một định dạng ngày tháng [S5].
- Lưu lịch sử theo thời gian: dữ liệu không bị xoá đi khi cập nhật, mà được giữ lại để bạn soi lại "tháng 3 năm ngoái bán được bao nhiêu" [S6].
Vì sao Data Warehouse quan trọng trong Data Science
Nếu bạn đã đọc về data science là gì và quy trình tổng thể, bạn sẽ thấy bước "thu thập và chuẩn bị dữ liệu" thường ngốn 60–80% thời gian của người làm dữ liệu. Data Warehouse ra đời để rút ngắn đúng khâu đó.
Cụ thể, Data Warehouse giúp người làm data science ở ba điểm rõ ràng:
Một — có dữ liệu sạch để bắt tay vào phân tích. Thay vì mỗi lần làm mô hình lại phải xin file từ 5 phòng ban, nối cột, đối chiếu tên khách hàng, xử lý ngày tháng sai định dạng, nhà khoa học dữ liệu chỉ việc truy vấn từ kho dữ liệu và bắt đầu chạy thuật toán ngay. Đây là lý do nhiều công ty xem Data Warehouse là nền móng của mọi dự án machine learning.
Hai — chạy truy vấn nặng mà không làm sập hệ thống bán hàng. Bạn không nên mở trực tiếp app bán hàng đang chạy để chạy câu lệnh "tính tổng doanh thu 2 năm theo từng tỉnh thành". Truy vấn đó sẽ khoá bảng, làm chậm hệ thống, thậm chí gây lỗi khi khách đang thanh toán. Data Warehouse tách riêng khối phân tích ra khỏi khối vận hành, nên ai cần dữ liệu to cứ vào kho mà chạy, hệ thống bán hàng vẫn chạy bình thường.
Ba — trả lời câu hỏi kinh doanh nhanh và nhất quán. Câu hỏi kiểu "doanh thu 6 tháng qua theo khu vực", "khách hàng nào rời đi trong quý này", "tỷ lệ đơn huỷ theo kênh bán" — tất cả đều là những truy vấn tổng hợp nặng, có thể chạy trong vài giây trên một Data Warehouse được thiết kế đúng [S7][S8].
Phân biệt Database, Data Warehouse và Data Lake
Ba khái niệm này hay bị trộn lẫn vì nghe giống nhau — đều là nơi chứa dữ liệu. Nhưng mục đích và cách tổ chức khác nhau hoàn toàn.
Database (cơ sở dữ liệu thường, hay OLTP — xử lý giao dịch trực tuyến) được thiết kế để ghi và cập nhật từng đơn lẻ, nhanh và liên tục. Hệ thống POS ở quầy thu ngân, app ngân hàng khi bạn chuyển khoản, hệ thống đặt vé xem phim — tất cả chạy trên Database kiểu này. Đặc điểm: dữ liệu hiện tại, cập nhật liên tục, mỗi thao tác là một giao dịch nhỏ.
Data Warehouse (hay OLAP — xử lý phân tích trực tuyến) thì ngược lại: tối ưu cho việc đọc và tổng hợp dữ liệu lớn theo nhiều chiều (thời gian, khu vực, sản phẩm…). Dữ liệu được nạp vào theo lô (hằng giờ, hằng ngày), ít khi cập nhật từng dòng, mà thường thêm dòng mới để giữ lịch sử.
Data Lake là kho chứa dữ liệu thô mọi định dạng: bảng, ảnh, video, log server, JSON, file âm thanh… Hình dung như một nhà kho lớn đổ tất cả về rồi phân loại sau. Data Lake giữ được dữ liệu gốc, phù hợp cho data scientist muốn khám phá tự do, nhưng nếu không có quy trình dọn dẹp thì dễ thành "bãi rác dữ liệu" — ai cũng đổ vào nhưng không ai dùng được.
Để so nhanh, bạn có thể nhìn bảng dưới đây. Mình dùng từ đời thường để bạn hình dung trước khi đụng vào thuật ngữ kỹ thuật:
| Tiêu chí | Database (OLTP) | Data Warehouse (OLAP) | Data Lake |
|---|---|---|---|
| Mục đích chính | Ghi và xử lý giao dịch hằng ngày | Truy vấn và phân tích dữ liệu lớn | Lưu trữ dữ liệu thô mọi định dạng |
| Loại dữ liệu | Có cấu trúc, dữ liệu hiện tại | Có cấu trúc, đã làm sạch và chuẩn hoá | Mọi định dạng: có cấu trúc, bán cấu trúc, phi cấu trúc |
| Cách cập nhật | Từng dòng, liên tục theo thời gian thực | Theo lô (hằng giờ, hằng ngày) | Khi cần, thường thêm chứ không sửa |
| Người dùng điển hình | Hệ thống vận hành, app, quầy giao dịch | Nhà phân tích, BI, data scientist | Data engineer, data scientist khám phá |
| Ví dụ đời thường | Sổ bán hàng của một cửa hàng | Bảng tổng hợp doanh thu cả chuỗi | Nhà kho chứa tất cả, chưa phân loại |
| Ví dụ công cụ | MySQL, PostgreSQL, SQL Server | Snowflake, BigQuery, Redshift | S3, ADLS, HDFS |
Database là quầy thu ngân — giao dịch nhanh, từng đơn. Data Warehouse là phòng kế toán cuối ngày — tổng hợp sạch sẽ để lên báo cáo. Data Lake là kho hàng phía sau — chứa tất cả, kể cả thứ chưa biết dùng làm gì.
Kiến trúc tổng quan của một Data Warehouse
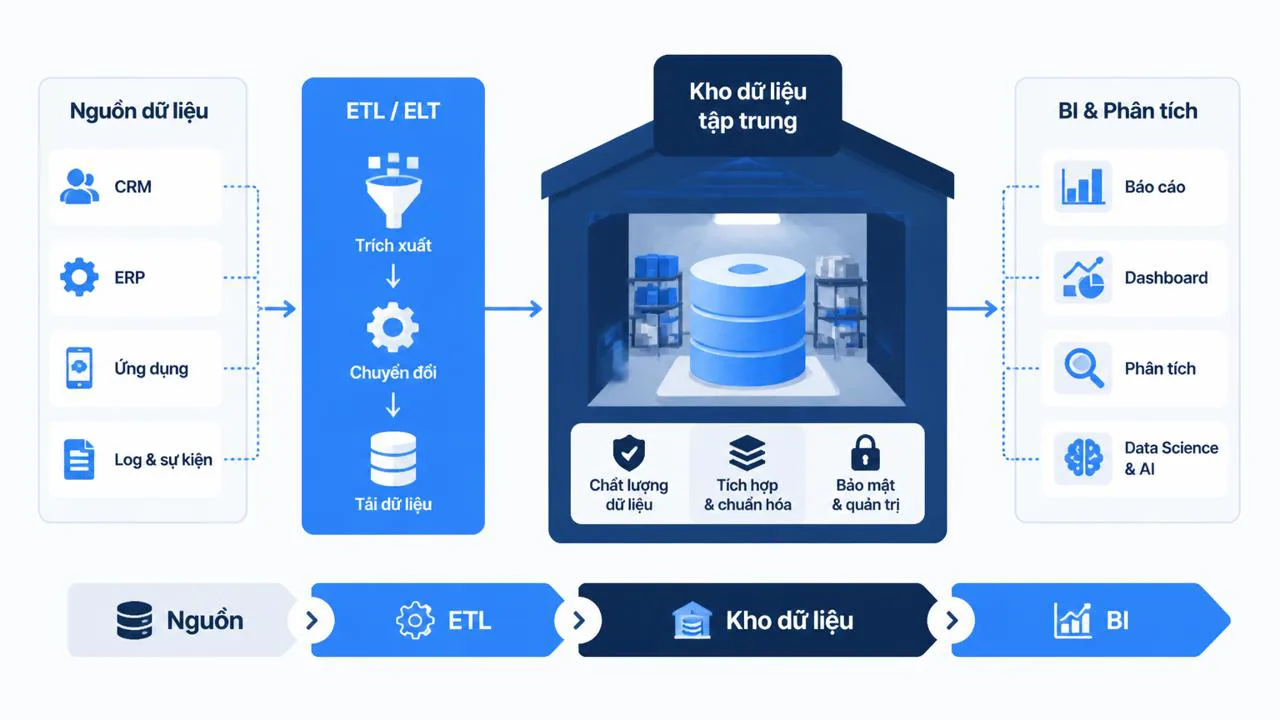
Để khỏi bị choáng khi đọc tài liệu kỹ thuật, bạn chỉ cần nhớ một sơ đồ đơn giản: dữ liệu chảy từ nhiều nguồn → qua lớp xử lý → vào kho → rồi mới đến tay người phân tích.
Cụ thể hơn, một Data Warehouse điển hình có bốn lớp:
Lớp nguồn dữ liệu. Đây là nơi dữ liệu được tạo ra: hệ thống CRM, phần mềm ERP, app bán hàng, app ngân hàng số, log từ web server, file Excel từ phòng kế toán, thậm chí dữ liệu từ đối tác bên ngoài. Mỗi nguồn có cấu trúc và chất lượng khác nhau.
Lớp ETL/ELT — bước "dọn bếp". ETL là viết tắt của Extract (lấy dữ liệu về), Transform (làm sạch, chuẩn hoá, tính toán lại), Load (nạp vào kho). ELT thì đảo lại: nạp thô vào kho trước, rồi mới transform. Bạn có thể đọc chi tiết ở bài ETL là gì để hiểu sâu hơn; ở bài này bạn chỉ cần nhớ: đây là bước biến dữ liệu lộn xộn thành dữ liệu sạch, thống nhất.
Lớp kho dữ liệu. Chính là Data Warehouse. Dữ liệu ở đây được tổ chức theo các mô hình (schema) để truy vấn nhanh, thường gặp nhất là star schema (mô hình hình sao): một bảng trung tâm chứa số liệu kinh doanh (gọi là bảng fact — kiểu "đơn hàng", "giao dịch"), xung quanh là các bảng mô tả chi tiết (gọi là bảng dimension — kiểu "khách hàng", "sản phẩm", "thời gian"). Một biến thể là snowflake schema (hình bông tuyết), trong đó bảng dimension được tách nhỏ thêm nếu cần chuẩn hoá cao hơn.
Lớp phân tích và BI. Cuối cùng, dữ liệu từ kho được kết nối với các công cụ BI (Business Intelligence — phần mềm làm báo cáo và dashboard trực quan, ví dụ: Power BI, Tableau, Looker), hoặc được data scientist lấy ra để huấn luyện mô hình. Lớp này là nơi ra quyết định thực sự diễn ra.
Ví dụ bằng bảng tính cho dễ hình dung: bạn có một bảng "đơn hàng" ở giữa với các cột ngày, khách hàng, sản phẩm, số lượng, doanh thu. Xung quanh nó là ba bảng phụ: bảng khách hàng (tên, khu vực, ngày đăng ký), bảng sản phẩm (tên, danh mục, giá gốc), bảng thời gian (ngày, tháng, quý, năm). Khi muốn tính "doanh thu theo khu vực theo quý", bạn chỉ cần nối (join) bảng đơn hàng với bảng khách hàng và bảng thời gian — mọi thông tin đã có sẵn, không phải đi gom lại.
Công cụ Data Warehouse phổ biến 2025–2026
Trên thị trường có bốn cái tên thường gặp nhất, đa số là dịch vụ đám mây (cloud) nên không cần mua máy chủ, trả theo dung lượng và lượng truy vấn:
- Google BigQuery: thuộc hệ sinh thái Google Cloud, có bản sandbox miễn phí để thử. Phù hợp nếu dữ liệu của bạn đã nằm trên Google Cloud hoặc team đang dùng hệ Google.
- Amazon Redshift: thuộc AWS, cũng có gói free tier. Phù hợp nếu hệ thống của bạn đã chạy trên AWS.
- Snowflake: nền tảng độc lập, chạy được trên cả AWS, Azure lẫn Google Cloud. Thường được chọn khi muốn tách khỏi một nhà cung cấp cloud duy nhất.
- Microsoft Azure Synapse: thuộc Azure, tích hợp chặt với các công cụ Microsoft như Power BI, SQL Server.
Lưu ý thực tế: giá và tính năng các dịch vụ này thay đổi theo từng năm, nên trước khi quyết định, bạn nên vào trang chính hãng của từng nhà cung cấp để kiểm tra bảng giá và điều khoản hiện hành. Bài viết này không trích dẫn con số cụ thể vì chúng dễ lệch theo thời điểm đọc.
Ngoài nhóm công cụ kể trên, bạn cũng nên biết Data Warehouse nằm trong nhóm lưu trữ và xử lý dữ liệu, một trong các các nhóm công cụ data science mà dân trong ngành hay phân loại. Khi chọn công cụ, bạn cần cân nhắc thêm phần ETL (để nạp dữ liệu), BI (để trực quan hoá), và ngân sách vận hành hằng tháng.
Khi nào cá nhân và SME thực sự cần Data Warehouse
Không phải ai cũng cần Data Warehouse ngay từ đầu. Nếu dữ liệu của bạn còn nằm gọn trong vài file Excel, vài bảng PostgreSQL với vài chục nghìn dòng, bạn hoàn toàn xử lý được bằng Pandas (thư viện Python phổ tích hợp dữ liệu dạng bảng, phổ biến trong data science) hoặc công cụ BI kết nối thẳng vào Database — chưa cần kho riêng.
Bạn nên bắt đầu nghĩ đến Data Warehouse khi có một trong các dấu hiệu sau:
- Dữ liệu nằm rải ở nhiều nơi: CRM một chỗ, kế toán một chỗ, app bán hàng một chỗ, log một chỗ — mỗi lần làm báo cáo phải gom thủ công.
- Báo cáo chạy chậm: truy vấn trên Database vận hành ngày càng ì ạch, ảnh hưởng đến tốc độ hệ thống bán hàng.
- Nhiều người cùng cần phân tích: marketing, sale, kế toán, lãnh đạo — ai cũng muốn xem dashboard, mỗi người một kiểu.
- Có nhu cầu dashboard cập nhật theo thời gian thực hoặc gần thời gian thực: lúc này Data Warehouse giúp tách khối phân tích khỏi khối vận hành.
Nếu bạn nhận diện mình đang ở giai đoạn này, một lộ trình đơn giản để bắt đầu:
- Gom nguồn: liệt kê tất cả nơi đang có dữ liệu (CRM, app, Excel, log…), ưu tiên nguồn nào quan trọng nhất với việc ra quyết định.
- Dọn sạch: xác định các trường dữ liệu dùng chung (tên khách hàng, mã sản phẩm, đơn vị tiền…), thống nhất định dạng trước khi đưa vào kho.
- Đưa vào kho: chọn một nền tảng phù hợp (BigQuery, Snowflake, Redshift…), nạp dữ liệu bằng công cụ ETL.
- Kết nối BI: nối kho dữ liệu với Power BI, Tableau hoặc Looker Studio để dashboard tự động cập nhật.
Với quy mô cá nhân hoặc SME nhỏ, bạn không cần làm hết bốn bước ngày một ngày hai. Có thể bắt đầu bằng một nguồn dữ liệu duy nhất, làm trơn tru rồi mở rộng dần — vừa tiết kiệm tiền vừa tránh "over-engineering" (làm phức tạp hoá vấn đề đơn giản).
Data Warehouse không phải thứ bạn cần có ngày đầu khởi nghiệp — mà là thứ bạn sẽ cần đến khi dữ liệu đã đủ lớn và đủ nhiều nguồn để bạn không thể nhìn ra bức tranh toàn cảnh bằng một file Excel nữa.
Tóm lại và checklist hành động
Năm dòng để nhớ nhanh về Data Warehouse:
- Là kho dữ liệu tập trung, không phải nơi tạo ra dữ liệu.
- Được thiết kế để phân tích và báo cáo, không phải để xử lý giao dịch hằng ngày.
- Khác Database ở chỗ: Database giao dịch nhanh từng đơn, Data Warehouse tổng hợp chậm nhưng chắc trên dữ liệu lớn.
- Khác Data Lake ở chỗ: Data Lake chứa dữ liệu thô mọi định dạng, Data Warehouse chứa dữ liệu đã sơ chế theo cấu trúc rõ ràng.
- Là nền tảng cho Data Science và BI, vì cung cấp dữ liệu sạch, lịch sử, sẵn sàng truy vấn.
Checklist 3 bước nếu bạn muốn bắt đầu áp dụng cho dự án của mình:
- Bước 1 — Xác định nhu cầu thật: bạn có đang đau đầu vì báo cáo chạy chậm, dữ liệu rải rác nhiều nơi, hoặc cần dashboard cho cả team không? Nếu chưa, chưa cần Data Warehouse.
- Bước 2 — Vẽ bức tranh dữ liệu: liệt kê nguồn, trường dữ liệu quan trọng, tần suất cập nhật. Không cần chi tiết kiến trúc ngay, chỉ cần biết bạn muốn trả lời câu hỏi gì từ dữ liệu.
- Bước 3 — Chọn nền tảng và thử nghiệm nhỏ: đăng ký gói miễn phí của BigQuery hoặc Redshift, nạp thử một bảng, kết nối thử với một dashboard đơn giản. Khi thấy mượt và hữu ích, hẵng mở rộng.
Nếu bạn đang trong giai đoạn tìm hiểu data science và muốn có cái nhìn toàn cảnh, hãy quay lại đọc bài data science là gì và quy trình tổng thể — Data Warehouse chỉ là một mảnh ghép trong bức tranh đó, nhưng là mảnh ghép mà hầu hết dự án thật đều không thể thiếu.
Tags
- Data Lake
- kho dữ liệu
- Database
- Snowflake
- data science
- BigQuery
- data warehouse
- OLAP
- ETL
- Redshift
Câu hỏi thường gặp
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.