Data Science
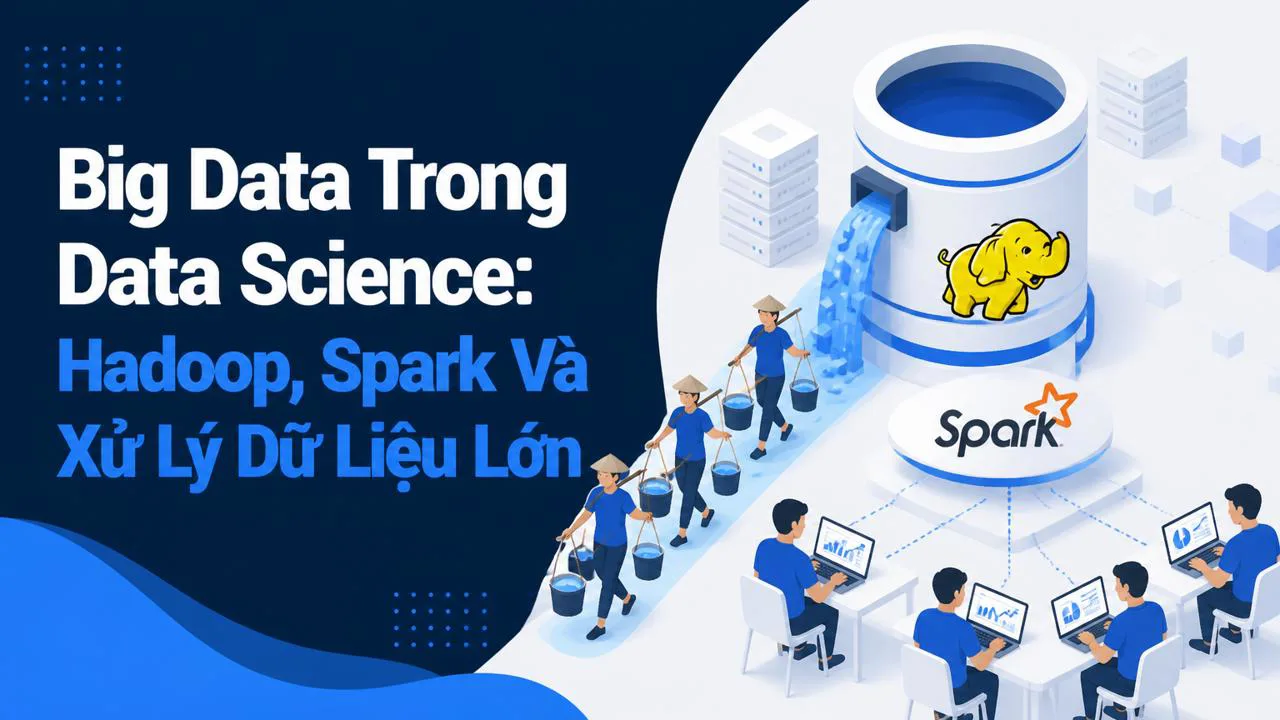
Big Data Trong Data Science: Hadoop, Spark Và Xử Lý Dữ Liệu Lớn
Hadoop và Spark là hai công cụ nền tảng để xử lý big data, nhưng đóng vai trò khác nhau và không phải lúc nào cũng cần dùng. Bài giải thích bằng ví dụ đời thường để bạn biết khi nào cần, dùng cái nào giữa pandas, Hadoop hay Spark.
 Phong Nguyen
PNTECH Writer · 14/09/2026
Một ngày bạn xử lý file CSV 10 GB chứa log bán hàng cả năm, mở bằng pandas trên laptop 16 GB RAM — máy treo, báo lỗi out of memory (hết bộ nhớ tạm). Hoặc công ty bạn cần phân tích hành vi 20 triệu người dùng mỗi ngày, mỗi người tạo ra hàng trăm sự kiện click, xem, mua. Lúc này Excel bó tay, pandas quá tải, bạn nghe đồng nghiệp nhắc đến Hadoop, Spark mà chưa biết bắt đầu từ đâu.
Hadoop và Spark là hai công cụ nền tảng để xử lý big data trong data science, nhưng chúng đóng vai trò khác nhau, không phải lúc nào cũng cần dùng, và không phải dùng cùng một lúc. Bài này giải thích cả hai bằng ví dụ đời thường — gánh nước, chia việc cho nhiều người — để bạn hiểu khi nào cần, dùng cái nào, và không nhầm lẫn giữa chúng.
Big data là gì và khi nào vượt khả năng của pandas?
Big data (dữ liệu lớn) là tập dữ liệu quá lớn hoặc quá phức tạp để các công cụ truyền thống xử lý hiệu quả. Người ta thường nhớ big data qua ba chữ V: Volume (dung lượng — tính bằng GB, TB trở lên), Velocity (tốc độ — dữ liệu sinh ra liên tục theo thời gian thực, ví dụ log server mỗi giây), Variety (đa dạng — vừa có bảng số, vừa có chữ, hình ảnh, video, JSON lẫn lộn) [S1][S3].
Bạn đã quen với pandas — đọc file CSV vài trăm MB, lọc, nhóm, tính tổng trong vài giây trên laptop. Ngưỡng mà pandas bắt đầu oằn mình thường nằm quanh 5–10 GB dữ liệu thô, hoặc khi bạn cần chạy tính toán lặp lại hàng trăm lần (ví dụ train một mô hình machine learning qua nhiều vòng thử tham số). Vượt qua ngưỡng đó, bạn cần cách chia việc cho nhiều máy cùng làm — đó chính là lý do Hadoop và Spark ra đời.
Big data không phải lúc nào cũng cần Hadoop hay Spark — nếu dữ liệu dưới 10 GB và laptop còn RAM, pandas vẫn là lựa chọn tốt nhất.
Hadoop là gì? Cách chia việc cho nhiều máy
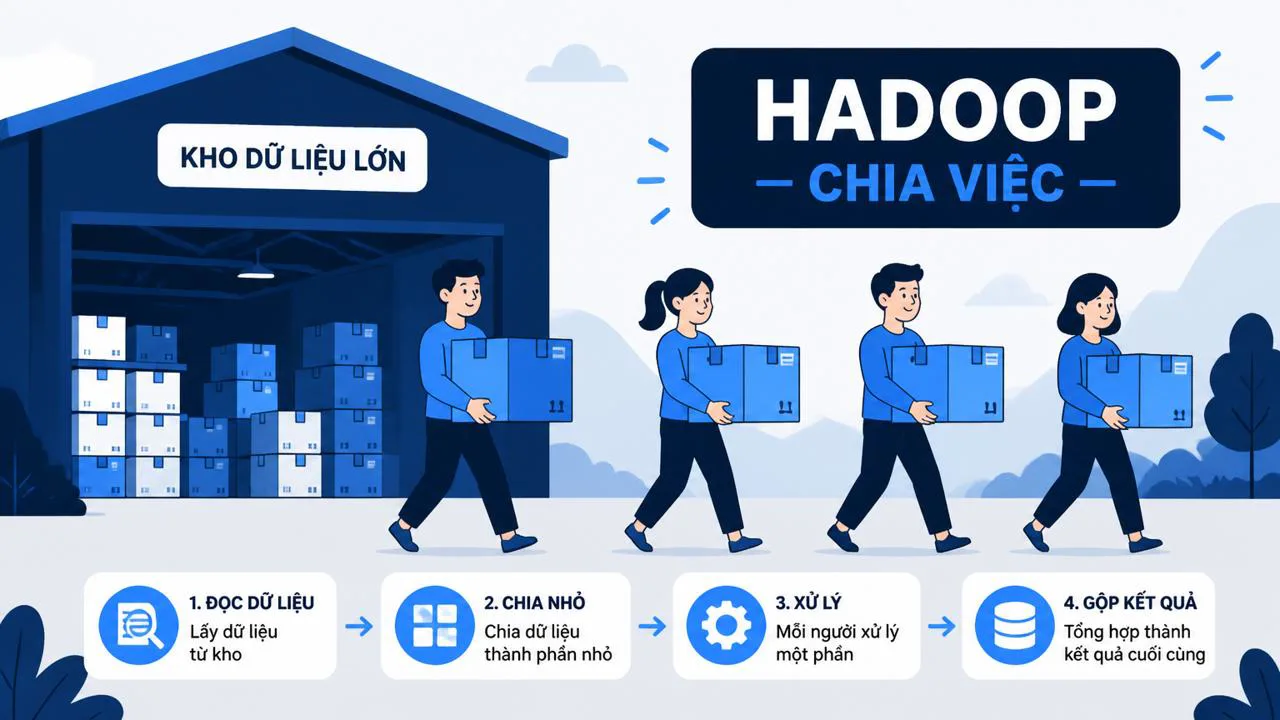
Hãy tưởng tượng bạn phải chuyển 1.000 thùng hàng từ kho A sang kho B. Một mình bạn gánh thì mất cả tuần. Nhưng nếu thuê 10 người, mỗi người lo 100 thùng, ai lo phần mình, cuối cùng gộp lại — xong trong một ngày. Hadoop hoạt động đúng tinh thần đó: chia một bài toán lớn cho nhiều máy tính cùng xử lý song song.
Để làm được việc này, Hadoop có ba thành phần chính bạn cần nhớ:
- HDFS (Hadoop Distributed File System) — đây là cách lưu trữ. Một file 10 GB sẽ được tự động chia thành nhiều mảnh nhỏ, lưu trên nhiều máy khác nhau. Khi một máy hỏng, máy khác vẫn có bản sao, dữ liệu không mất.
- MapReduce — đây là cách tính toán. Gồm hai bước lặp lại: Map (mỗi máy xử lý phần dữ liệu của mình, ví dụ đếm từ khóa trong từng file nhỏ), rồi Reduce (gộp kết quả từ các máy lại thành con số cuối cùng).
- YARN — quản lý tài nguyên: máy nào rảnh, máy nào bận, phân việc thế nào cho hợp lý. Giống quản đốc công trường biết phân công thợ.
Vì sao Hadoop từng phổ biến? Vì nó rẻ — chạy được trên máy tính thường, không cần server đắt tiền, chỉ cần gom nhiều máy lại. Tin cậy — một máy chết, hệ thống vẫn chạy vì dữ liệu có bản sao. Nhưng nhược điểm thật: MapReduce đọc và ghi dữ liệu xuống ổ cứng liên tục, nên rất chậm với các tác vụ lặp lại nhiều lần — ví dụ train mô hình machine learning 100 vòng, hoặc tính toán tương tác nhiều bước. Thêm nữa, setup một cụm Hadoop đúng chuẩn khá phức tạp, tốn thời gian cho người mới.
Spark là gì? Phiên bản nhanh hơn của Hadoop
Spark cũng chia việc cho nhiều máy, nhưng điểm khác biệt lớn nhất là nó giữ dữ liệu tạm trong RAM (bộ nhớ tạm của máy) thay vì đọc ghi xuống ổ cứng liên tục. Ví dụ đời thường: nấu ăn thì để nguyên liệu trên bàn bếp, lúc cần lấy ngay, không phải mỗi lần chạy xuống kho lấy lên. Hadoop giống mỗi lần dùng lại xuống kho lấy — chậm hơn rõ rệt.
Vì lý do đó, Spark thường nhanh hơn MapReduce của Hadoop rất nhiều lần cho các tác vụ lặp lại — đặc biệt là machine learning và xử lý tương tác. Theo tài liệu chính thức của Apache Spark, tốc độ có thể nhanh hơn MapReduce từ 10 đến 100 lần khi làm việc trong bộ nhớ (cần kiểm tra con số cụ thể trên trang chính thức vì phụ thuộc workload và cụm phần cứng).
Một điểm dễ gây nhầm: Spark không phải là cái thay thế hoàn toàn Hadoop. Spark có thể chạy độc lập — đọc dữ liệu từ nhiều nguồn như HDFS, S3, database — hoặc chạy trên nền một cụm Hadoop, tận dụng HDFS làm nơi lưu trữ và YARN quản lý tài nguyên. Hai công cụ bổ sung cho nhau, không loại trừ nhau.
Spark đi kèm nhiều thư viện giúp bạn làm việc thuận tiện hơn:
- Spark SQL — truy vấn dữ liệu bằng cú pháp SQL quen thuộc, quen thuộc với người đã biết SQL.
- MLlib — thư viện machine learning chạy phân tán, train mô hình trên dữ liệu lớn.
- Spark Streaming — xử lý dữ liệu đến liên tục theo thời gian thực, ví dụ log click chuột mỗi giây.
Khi nào dùng Hadoop, khi nào dùng Spark?
Câu hỏi thực tế nhất mà người mới hay đặt ra là: dữ liệu của mình có cần Hadoop/Spark chưa, hay pandas vẫn đủ? Một checklist đơn giản để quyết định:
- Dữ liệu dưới 10 GB, máy có 16–32 GB RAM → pandas trên laptop là đủ, chưa cần đụng đến Hadoop hay Spark. Đừng over-engineer (làm phức tạp hóa) vấn đề khi công cụ đơn giản vẫn chạy tốt.
- 10 GB đến vài trăm GB → Spark trên một cụm nhỏ (3–5 máy) hoặc Spark trên cloud (Databricks, EMR) là lựa chọn hợp lý. Spark cho tốc độ tốt, dễ lập trình hơn Hadoop thuần.
- Hàng TB trở lên, cần lưu trữ lâu dài, batch chạy hàng đêm → kết hợp Hadoop (HDFS làm kho dữ liệu) + Spark (làm động cơ tính toán) vẫn là kiến trúc phổ biến.
Bảng so sánh nhanh giúp bạn nhìn rõ sự khác biệt:
| Tiêu chí | Hadoop (MapReduce + HDFS) | Spark |
|---|---|---|
| Tốc độ tính toán lặp lại | Chậm (đọc/ghi ổ cứng liên tục) | Nhanh hơn nhiều lần trong bộ nhớ |
| Độ khó cài đặt | Phức tạp, tốn thời gian | Dễ hơn, có bản community miễn phí |
| Chi phí phần cứng | Rẻ, chạy máy thường | Cần nhiều RAM hơn |
| Phù hợp với dữ liệu | Lưu trữ lâu dài, batch lớn | Tính toán lặp lại, machine learning, streaming |
| Khi nào KHÔNG cần | Dữ liệu nhỏ, cần kết quả tức thì | Dữ liệu dưới 10 GB, chưa quen phân tán |
Thực tế Hadoop và Spark năm 2025–2026
Nhiều doanh nghiệp hiện đại đang chuyển sang các dịch vụ cloud data warehouse như Snowflake, BigQuery, Databricks — nơi bạn không cần tự quản lý cụm máy mà chỉ trả tiền theo dung lượng xử lý. Xu hướng này khiến Hadoop on-premise (tự dựng tại công ty) dần ít phổ biến hơn trong môi trường doanh nghiệp mới (cần kiểm tra báo cáo ngành gần nhất để xác nhận mức độ chuyển dịch).
Tuy nhiên, Hadoop và Spark vẫn là kiến thức nền tảng quan trọng trong lộ trình học data science. Lý do: hầu hết các chương trình đào tạo đều dạy Hadoop/Spark như nền tảng lịch sử, rất nhiều tài liệu kỹ thuật và bài báo khoa học vẫn viết theo thuật ngữ Hadoop, và phỏng vấn vị trí data engineer vẫn hỏi về HDFS, MapReduce, Spark. Hiểu hai công cụ này giúp bạn đọc tài liệu dễ hơn và làm việc với hệ thống cũ còn đang vận hành.
Gợi ý bước tiếp theo cho người mới: học Spark trên cloud miễn phí (Databricks Community Edition) trước, làm quen với cách viết Spark SQL và PySpark (Spark viết bằng Python — ngôn ngữ bạn đã quen nếu đã học pandas). Khi đã thành thạo Spark, quay lại tìm hiểu sâu Hadoop sẽ dễ hơn nhiều.
Spark nhanh hơn MapReduce nhờ giữ dữ liệu trong RAM, nhưng vẫn cần Hadoop (HDFS) làm nơi lưu trữ — hai công cụ thường đi cùng nhau.
Tóm tắt nhanh cho người mới
- Hadoop = cách lưu trữ dữ liệu lớn trên nhiều máy (HDFS) và cách tính toán phân tán (MapReduce), quản lý bởi YARN.
- Spark = động cơ xử lý dữ liệu lớn, giữ dữ liệu trong RAM nên nhanh hơn MapReduce cho tác vụ lặp lại.
- Dữ liệu dưới 10 GB → pandas là đủ, chưa cần Hadoop/Spark.
- 10 GB đến vài trăm GB → Spark trên cloud hoặc cụm nhỏ.
- Hàng TB trở lên → Hadoop + Spark kết hợp, hoặc chuyển sang cloud data warehouse.
- Bắt đầu ở đâu → Spark với PySpark trên Databricks Community Edition, sau đó mở rộng sang Hadoop khi cần.
Khi bạn đã quen Spark, việc chuyển sang các công cụ cloud hiện đại như BigQuery hay Snowflake sẽ nhẹ nhàng hơn nhiều — vì tư duy nền tảng về xử lý dữ liệu lớn vẫn là giống nhau.
Tags
- PySpark
- Pandas
- Big Data
- data science
- MapReduce
- Hadoop
- Xử lý dữ liệu lớn
- Cloud Data
- HDFS
- Spark
Câu hỏi thường gặp
Tiếp theo
Xem phần mềm — hoặc nhận tư vấn
Đọc xong thì chọn: phần mềm PN, công cụ khuyên dùng, hoặc nhờ mình làm theo nhu cầu.