Tool & Productivity
AI không gợi ý thương hiệu của bạn? Hiểu lỗi nhầm lẫn thực thể và cách kiểm tra
Nghiên cứu 14.140 lượt chạy API cho thấy AI có thể biết tên thương hiệu nhưng không gợi ý nó. Bài giải thích hiện tượng nhầm lẫn thực thể và 5 bước kiểm tra cho doanh nghiệp nhỏ Việt Nam.
 Phong Nguyen
PNTECH Writer · 19/10/2026
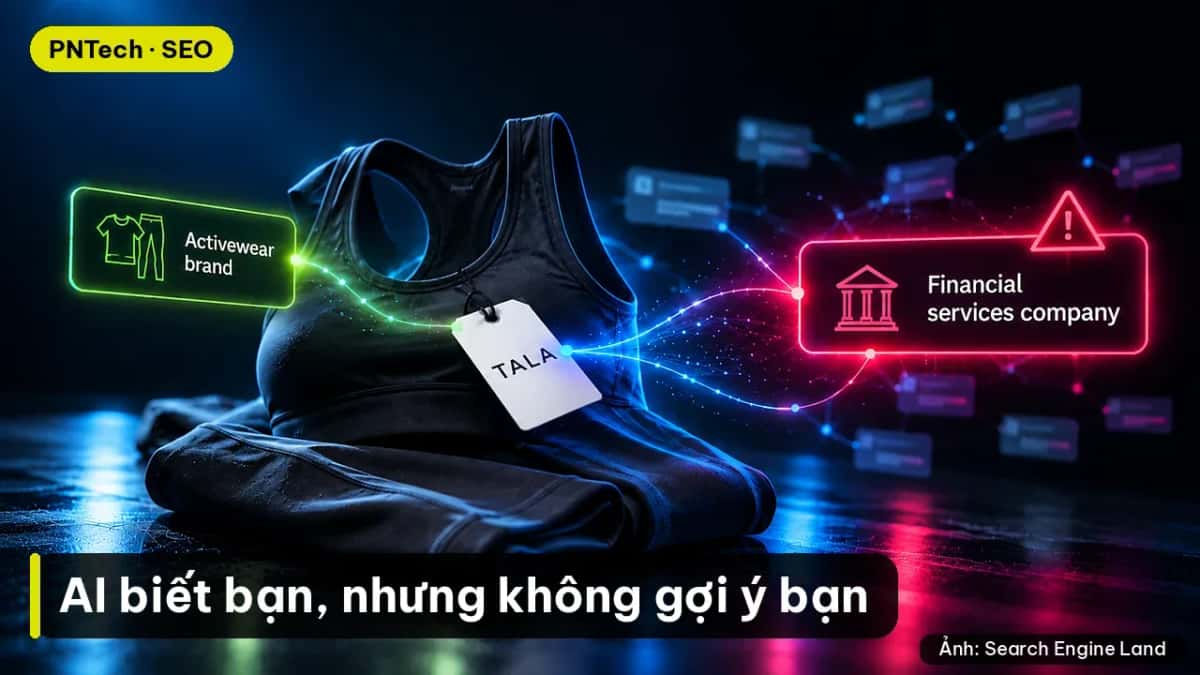
Bạn hỏi một trợ lý AI "[tên thương hiệu] là gì?" và nhận được câu trả lời đúng. Nhưng khi hỏi "nên mua sản phẩm này của hãng nào?", tên của bạn không hề xuất hiện. Tình trạng AI không gợi ý thương hiệu dù đã biết thương hiệu đó đang được giới SEO chú ý. Một nghiên cứu mới cho thấy vấn đề có thể bắt đầu từ một bước rất cơ bản: hệ thống không chắc cái tên ấy đang chỉ đúng thực thể nào. Hiện tượng này gọi là entity confusion, tức nhầm lẫn thực thể [S1].
Bài này tóm tắt nghiên cứu đó và các bước kiểm tra mà doanh nghiệp nhỏ, người làm một mình ở Việt Nam có thể tự làm.
Chuyện gì đã xảy ra: nghiên cứu 14.140 lượt chạy về thương hiệu trên AI
Ngày 15/10/2026, Search Engine Land đăng bài của Maryanna Franco về cách nhầm lẫn thực thể làm thương hiệu khó xuất hiện trong câu trả lời AI [S1]. Bài viết dựa trên nghiên cứu bà thực hiện cùng João da Silva tại FrictionAI, công bố dạng truy cập mở và có mã DOI [S2].
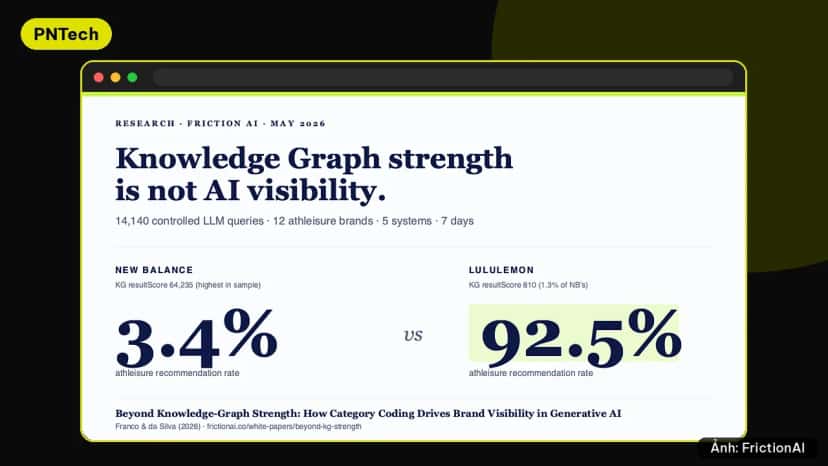
Quy mô nghiên cứu: 14.140 lượt chạy API có kiểm soát, với 12 thương hiệu đồ thể thao trên 5 nền tảng AI tạo sinh [S1][S2].
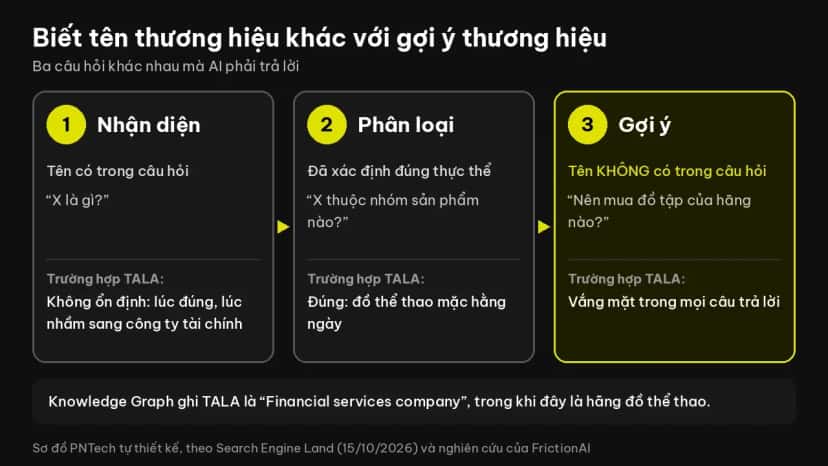
Trường hợp được nhắc nhiều nhất là TALA, một hãng đồ tập của Anh. Knowledge Graph của Google mô tả TALA là "Financial services company", tức công ty dịch vụ tài chính. Và TALA vắng mặt trong mọi câu trả lời gợi ý thương hiệu athleisure, nhóm đồ thể thao mặc hằng ngày, mà nhóm tác giả kiểm tra [S1]. Họ gọi trạng thái này là "KG-hijacked entity": cái tên trên Knowledge Graph đã bị gắn vào một công ty khác [S1][S2].
 Ảnh: FrictionAI
Vì sao AI không gợi ý thương hiệu dù đã biết tên?
Bài của Search Engine Land tách việc "AI biết thương hiệu" thành ba câu hỏi khác nhau [S1]:
- Nhận diện: tên có sẵn trong câu hỏi, ví dụ "TALA là gì?".
- Phân loại: đã xác định đúng thực thể, AI xếp nó vào nhóm nào.
- Gợi ý: câu hỏi chỉ nêu nhu cầu, ví dụ "nên mua đồ tập của hãng nào?". AI phải tự tìm ứng viên.
Với TALA, khi đã xác định đúng hãng đồ tập, các mô hình xếp nó đúng nhóm. Nhưng bước nhận diện không ổn định: lúc AI hiểu đúng, lúc lại nhầm sang công ty tài chính [S1]. Vậy trả lời đúng câu "X là gì?" chưa có nghĩa X sẽ được nhắc khi khách hỏi theo nhu cầu.
 Ảnh: PNTech tự thiết kế, theo Search Engine Land và FrictionAI
Mạnh trên Knowledge Graph chưa chắc được gợi ý
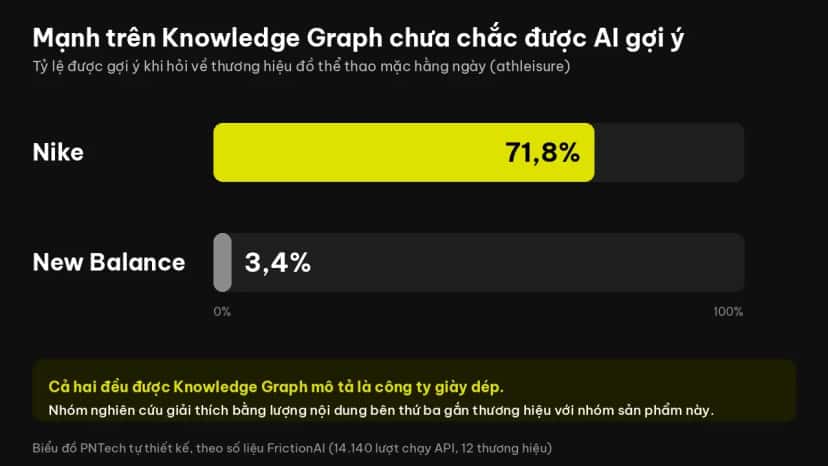
Khi hỏi về thương hiệu athleisure, Nike được gợi ý ở 71,8% truy vấn, còn New Balance chỉ 3,4%, dù cả hai cùng được Knowledge Graph mô tả là công ty giày dép [S2]. Nhóm nghiên cứu giải thích khác biệt này bằng lượng nội dung bên thứ ba gắn từng thương hiệu với nhóm sản phẩm đó [S2].
 Ảnh: PNTech tự thiết kế, theo số liệu FrictionAI
Website của bạn ít được trích khi AI so sánh
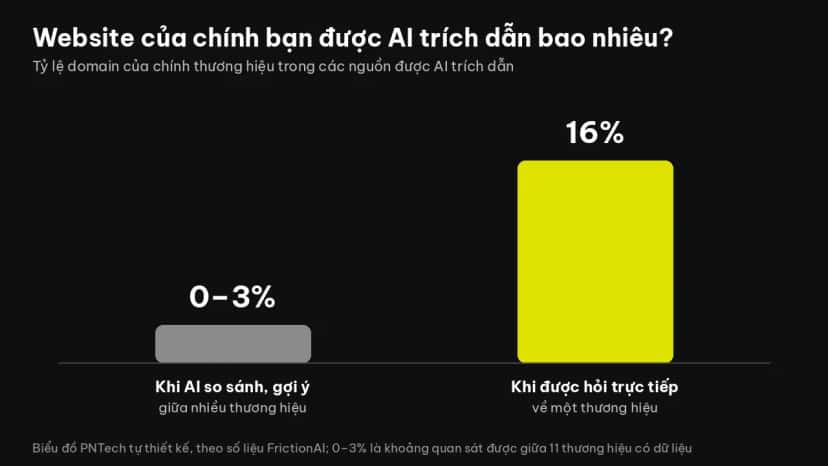
Khi AI so sánh và gợi ý giữa nhiều thương hiệu, domain của chính thương hiệu chỉ chiếm 0–3% nguồn được trích. Khi được hỏi trực tiếp về một thương hiệu, tỷ lệ này là 16% [S2]. Website của bạn giúp AI trả lời câu "bạn là ai", nhưng câu "nên chọn ai" lại dựa nhiều vào nguồn bên ngoài.
 Ảnh: PNTech tự thiết kế, theo số liệu FrictionAI
Wikipedia và tìm kiếm web
Khi tắt tính năng tìm kiếm web, 3 thương hiệu mất khả năng được nhận diện, và cả ba đều là những hãng không có bài Wikipedia tiếng Anh [S2]. Điều này gợi ý rằng thương hiệu chưa có mặt trên Wikipedia phụ thuộc nhiều hơn vào việc AI tra cứu web lúc trả lời.
Cần đọc đúng: đây là tương quan, chưa phải nhân quả. Chính tác giả viết rằng dữ liệu quan sát không chứng minh việc Knowledge Graph mô tả sai đã gây ra tỷ lệ gợi ý bằng 0 của TALA. Họ coi đó là giả thuyết cần kiểm chứng tiếp [S1][S2].
Vì sao chuyện này quan trọng với doanh nghiệp Việt
Theo Search Engine Land, thương hiệu có tên ngắn, tên phổ biến, tên viết tắt, vừa đổi tên hoặc trùng tên với tổ chức lớn là nhóm đặc biệt dễ bị nhầm lẫn thực thể [S1]. Nhiều shop và công ty nhỏ ở Việt Nam đặt tên tiếng Anh ngắn, nên dễ trùng tên với doanh nghiệp nước ngoài.
Điểm thứ hai: cùng là "không được AI gợi ý" nhưng nguyên nhân có thể rất khác. Bài viết nêu ba kiểu: thực thể rõ nhưng gắn sai nhóm sản phẩm như New Balance, tín hiệu thực thể quá yếu, và va chạm tên như TALA [S1]. Tác giả cũng lưu ý các "điểm hiển thị trên AI" gộp nhiều chỉ số thành một con số dễ che mất nguyên nhân [S1].
Đây là phần tiếp nối của bài nhận diện thương hiệu ảnh hưởng thứ hạng website thế nào, nhưng trong môi trường AI.
Cách kiểm tra thương hiệu trên AI: 5 bước cho doanh nghiệp nhỏ
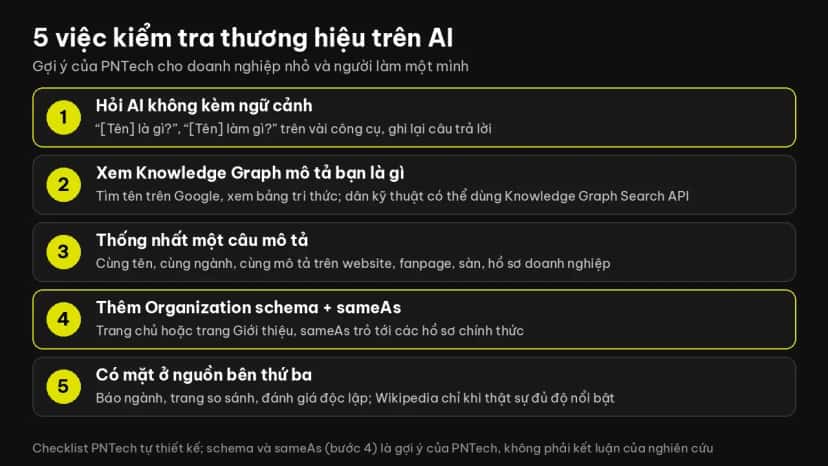
Các bước dưới đây kết hợp cách chẩn đoán của Search Engine Land với tài liệu của Google. Phần schema và sameAs là gợi ý của PNTech, không phải kết luận của nghiên cứu.
 Ảnh: PNTech tự thiết kế
Bước 1: Hỏi AI mà không kèm ngữ cảnh
Dùng các câu ngắn, không giải thích thêm: "[Tên] là gì?", "[Tên] làm gì?", "Mô tả [Tên]", "[Tên] là công ty nào?", "Kể về [Tên]" [S1]. Thử trên vài công cụ AI, ghi lại AI có xác định cùng một thực thể không, có hỏi lại hay trộn thông tin của hai công ty [S1].
Sau đó hỏi riêng câu phân loại ("[Tên] thuộc ngành nào?"), rồi hỏi câu gợi ý không có tên bạn, ví dụ "Nên mua [sản phẩm] của thương hiệu nào ở Việt Nam?" [S1]. Lưu kết quả kèm ngày thử, vì câu trả lời AI thay đổi theo thời gian.
Bước 2: Xem Knowledge Graph đang mô tả bạn là gì
Tìm tên thương hiệu trên Google và xem bảng tri thức (knowledge panel) nếu có. Đọc kỹ dòng mô tả ngắn: theo Search Engine Land, một mô tả thuộc về tổ chức khác là tín hiệu đáng lo hơn nhiều so với một mô tả chung chung [S1]. Người làm kỹ thuật có thể dùng Knowledge Graph Search API của Google, cũng là công cụ nhóm nghiên cứu dùng để lấy dữ liệu [S2][S5].
Nếu Knowledge Graph đang gắn tên bạn với công ty khác, bài viết gợi ý gửi yêu cầu chỉnh sửa tới Google [S1].
Bước 3: Thống nhất một câu mô tả thực thể
Search Engine Land liệt kê những thứ giúp phân biệt hai thực thể trùng tên: website có nét riêng, thông tin tổ chức nhất quán, quan hệ rõ với người sáng lập và sản phẩm, cùng các nguồn bên thứ ba uy tín [S1].
Cách làm thực tế: viết một câu chuẩn như "[Tên] là [loại hình] tại [thành phố], chuyên [sản phẩm], thành lập năm [năm] bởi [người sáng lập]". Dùng đúng câu đó và cùng cách viết tên trên website, fanpage, gian hàng sàn, hồ sơ doanh nghiệp trên Google và LinkedIn.
Bước 4: Thêm Organization schema và sameAs (gợi ý của PNTech)
Google cho biết thêm structured data loại Organization vào trang chủ có thể giúp Google hiểu thông tin tổ chức và phân biệt tổ chức của bạn với tổ chức khác trong kết quả tìm kiếm [S3]. Không có thuộc tính bắt buộc, và Google khuyên đặt trên trang chủ hoặc trang Giới thiệu [S3].
Thuộc tính sameAs chứa URL của trang trên website khác có thêm thông tin về tổ chức, ví dụ hồ sơ mạng xã hội [S3]. Schema.org định nghĩa nó là URL của trang tham chiếu xác định rõ danh tính, như trang Wikipedia, mục Wikidata hoặc website chính thức [S4]. Ví dụ rút gọn:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Tên thương hiệu",
  "url": "https://tenmien.vn",
  "description": "Câu mô tả chuẩn ở bước 3",
  "sameAs": ["https://facebook.com/trang-chinh-thuc", "https://linkedin.com/company/ten-cong-ty"]
}
Kiểm tra mã bằng Rich Results Test trước khi đưa lên [S3]. Cần nói rõ: nghiên cứu FrictionAI không kiểm tra tác động của schema hay sameAs, và Google cũng không đảm bảo các tính năng dùng structured data sẽ hiển thị [S2][S3]. Đây là bước làm sạch dữ liệu, không phải công tắc để AI gợi ý bạn. Xem thêm bài Rich Results và Structured Data.
Bước 5: Nội dung trên domain riêng và nguồn bên thứ ba
Website riêng vẫn quan trọng khi người dùng hỏi trực tiếp về bạn, nơi domain thương hiệu chiếm 16% nguồn được trích [S2]. Giữ trang Giới thiệu, sản phẩm và tác giả rõ ràng (xem thêm blog nhỏ cần làm gì để được Google trích dẫn trong câu trả lời AI).
Còn với câu hỏi so sánh, nghiên cứu khuyến nghị đầu tư vào nguồn bên ngoài: báo ngành, trang so sánh, bài đánh giá độc lập trong đúng nhóm sản phẩm [S2].
Về Wikipedia và Wikidata, PNTech cho rằng nên thực tế: đây không phải nơi doanh nghiệp tự viết bài giới thiệu, và một bài chỉ đứng vững khi đã có nguồn độc lập nói về bạn. Shop nhỏ nên xây nguồn bên thứ ba trước. Khi đã có trang Wikipedia hoặc mục Wikidata đúng về mình, hãy thêm vào sameAs [S4].
Công cụ AI cho việc làm nội dung hằng ngày có trong trang Tool khuyên dùng của PNTech.
Giới hạn và rủi ro cần biết
- Tương quan, không phải nhân quả: nghiên cứu quan sát hệ thống AI từ bên ngoài, không chứng minh sửa một trường Knowledge Graph sẽ khiến AI gợi ý bạn [S1][S2].
- Mẫu nhỏ, một ngành: 12 thương hiệu đồ thể thao, chạy từ Anh. Kết quả có thể khác ở thị trường Việt Nam [S2].
- Xung đột lợi ích đã công bố: nhóm tác giả gắn với FrictionAI, công ty kinh doanh trong lĩnh vực hiển thị thương hiệu trên AI [S2].
- Schema và sameAs chưa được kiểm chứng trong nghiên cứu: đó là gợi ý của PNTech dựa trên tài liệu Google [S3].
- Đừng chạy theo số lượng: cần bằng chứng nhất quán để phân biệt hai thực thể, không phải thêm thật nhiều bài chứa cái tên dễ nhầm [S1].
Kết luận
AI không gợi ý thương hiệu của bạn chưa chắc vì AI "không biết" bạn. Có thể nó đang nhầm bạn với thực thể khác, xếp bạn sai nhóm, hoặc thiếu nguồn bên ngoài nhắc tới bạn. Trước khi viết thêm nội dung hay chạy PR, hãy tự hỏi câu tác giả Search Engine Land đặt ra: khi gặp tên thương hiệu của bạn, AI đang hiểu đó là ai [S1]? Kiểm tra theo 5 bước trên rồi mới quyết định đầu tư vào đâu.
Nguồn tham khảo
- [S1] Search Engine Land, Maryanna Franco, "How entity confusion can hurt your brand's AI visibility" (15/10/2026): https://searchengineland.com/entity-confusion-hurt-ai-visibility-496139
- [S2] FrictionAI, Maryanna Franco và João da Silva, "Beyond Knowledge Graph Strength" (white paper): https://www.frictionai.co/white-papers/beyond-kg-strength, DOI: https://doi.org/10.5281/zenodo.20331344
- [S3] Google Search Central, "Organization structured data": https://developers.google.com/search/docs/appearance/structured-data/organization
- [S4] Schema.org, "sameAs": https://schema.org/sameAs
- [S5] Google for Developers, "Knowledge Graph Search API": https://developers.google.com/knowledge-graph
Tags
- ai-search
- entity SEO
- Knowledge Graph
- Schema Markup
- thuong-hieu-tren-ai
Câu hỏi thường gặp
Entity confusion là gì?
Vì sao AI biết thương hiệu của tôi nhưng không gợi ý khi khách hỏi?
Thêm Organization schema và sameAs có giúp AI gợi ý thương hiệu không?
Doanh nghiệp nhỏ có cần bài Wikipedia không?
Làm sao biết Knowledge Graph đang mô tả thương hiệu của tôi thế nào?
Tiếp theo
Tool mình đã dùng thật
Xem danh sách tool và dịch vụ đã dùng trong công việc — kèm lý do nên cân nhắc và khi nào không cần.